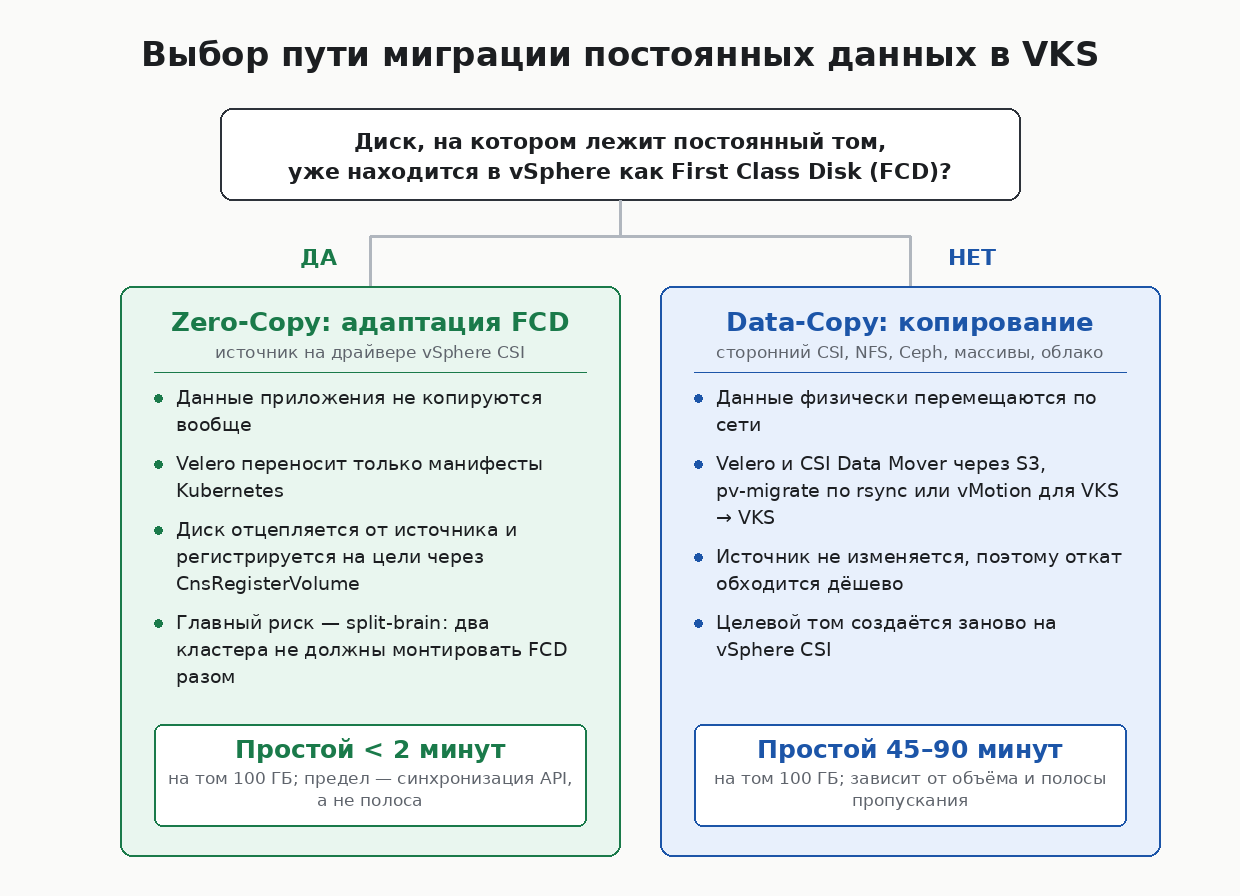
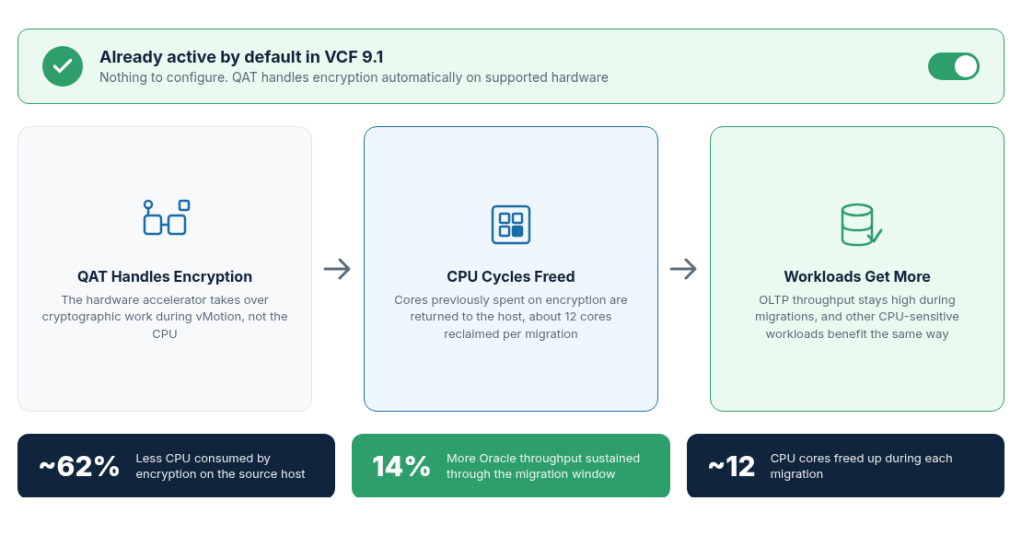
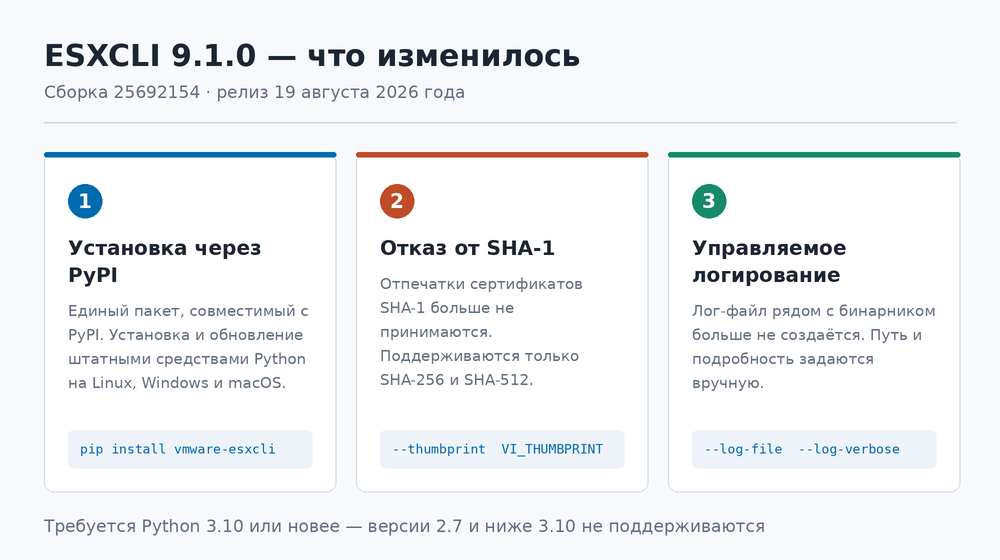
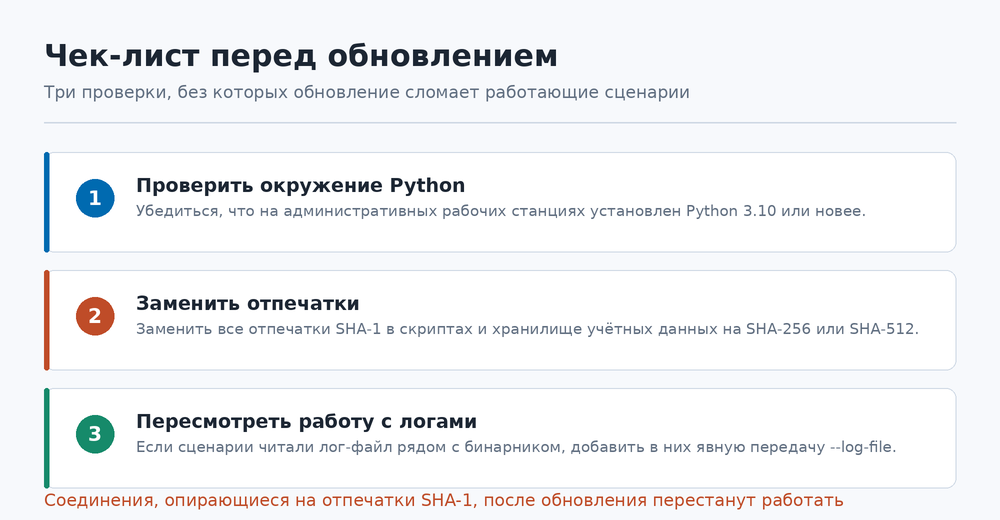
В Basis Virtual Security 4.1 появились контроль кластеров Kubernetes, политики Kyverno, сканирование реестров и проверка подписей контейнерных образов.
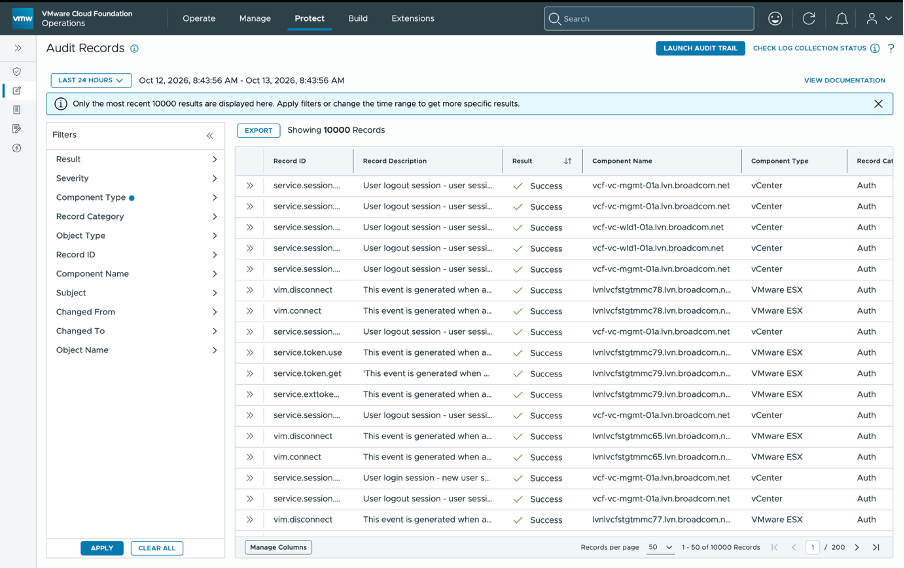
Новый Audit Trail в VCF 9.1 выстраивает действия пользователей vCenter, NSX и ESX в единую хронологию. На примере удаления ВМ VMware показывает поиск повышения прав и следов атаки.
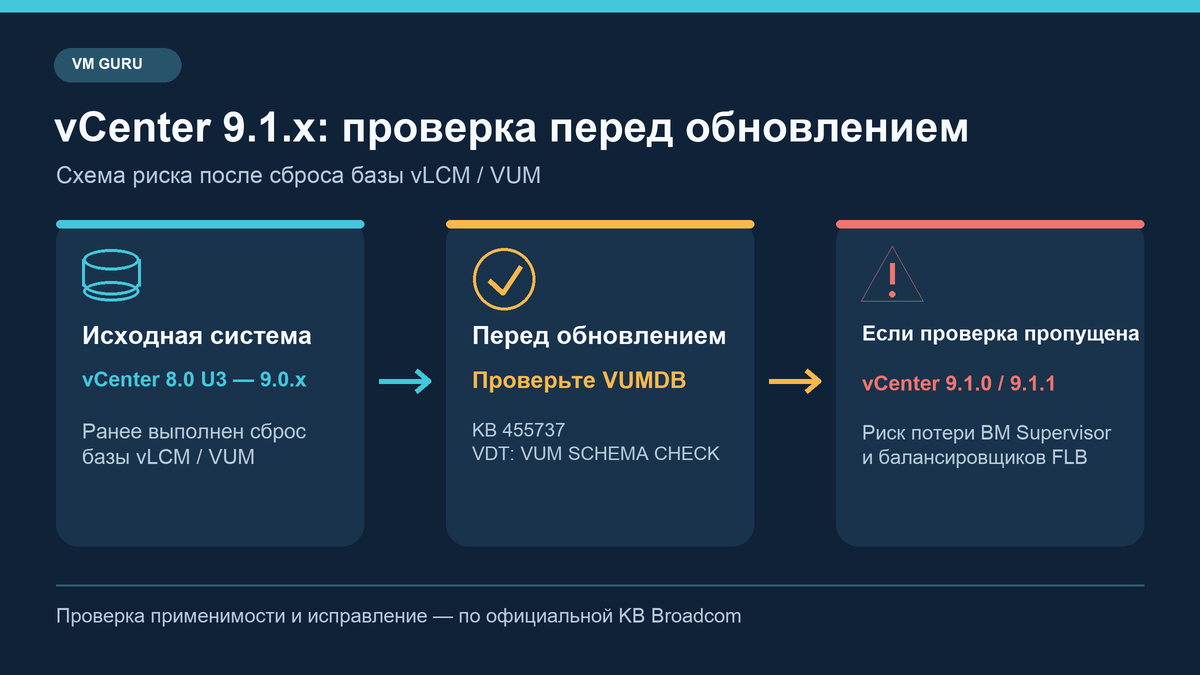
VMware предупреждает: после сброса базы vLCM обновление до vCenter 9.1.0 или 9.1.1 может привести к потере управляющих ВМ Supervisor. Перед переходом требуется проверить и при необходимости исправить схему VUMDB.
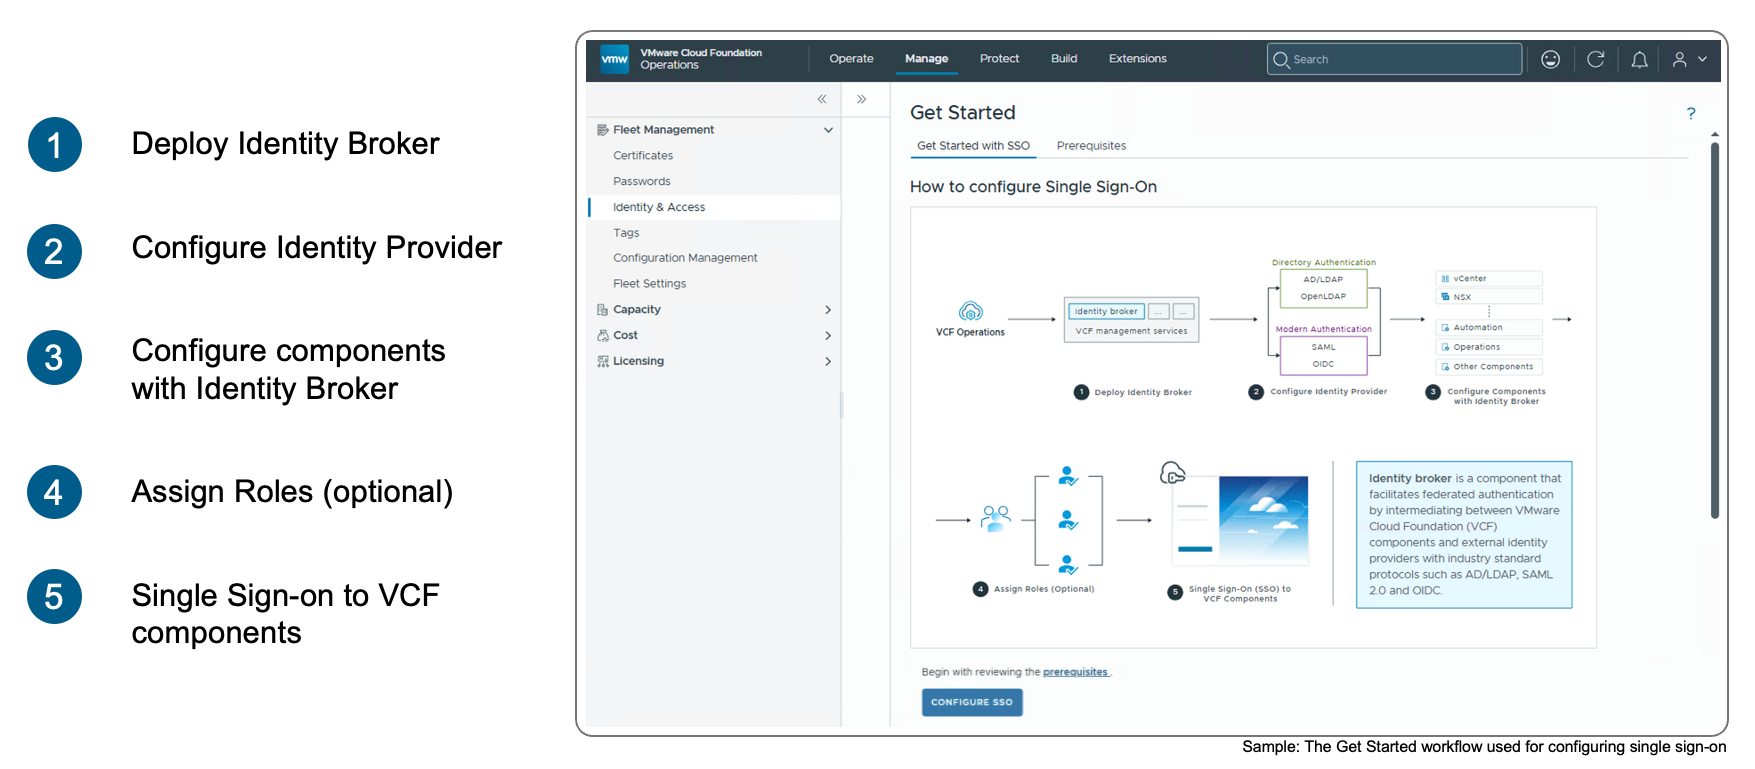
VCF Operations 9.1.1 может проверять пользователей Active Directory и OpenLDAP при входе. Разбираем, как On-Demand Lookup меняет выдачу временного доступа и чем отличается от предварительного импорта.
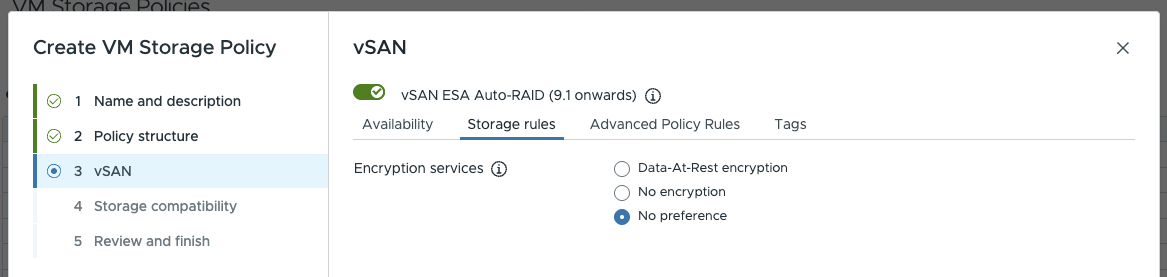
Правила Storage Rules в vSAN 9.1 не всегда включают сервис для отдельной ВМ: часто они лишь отбирают совместимые хранилища. Разбираем изменение для ESA и No data reduction.
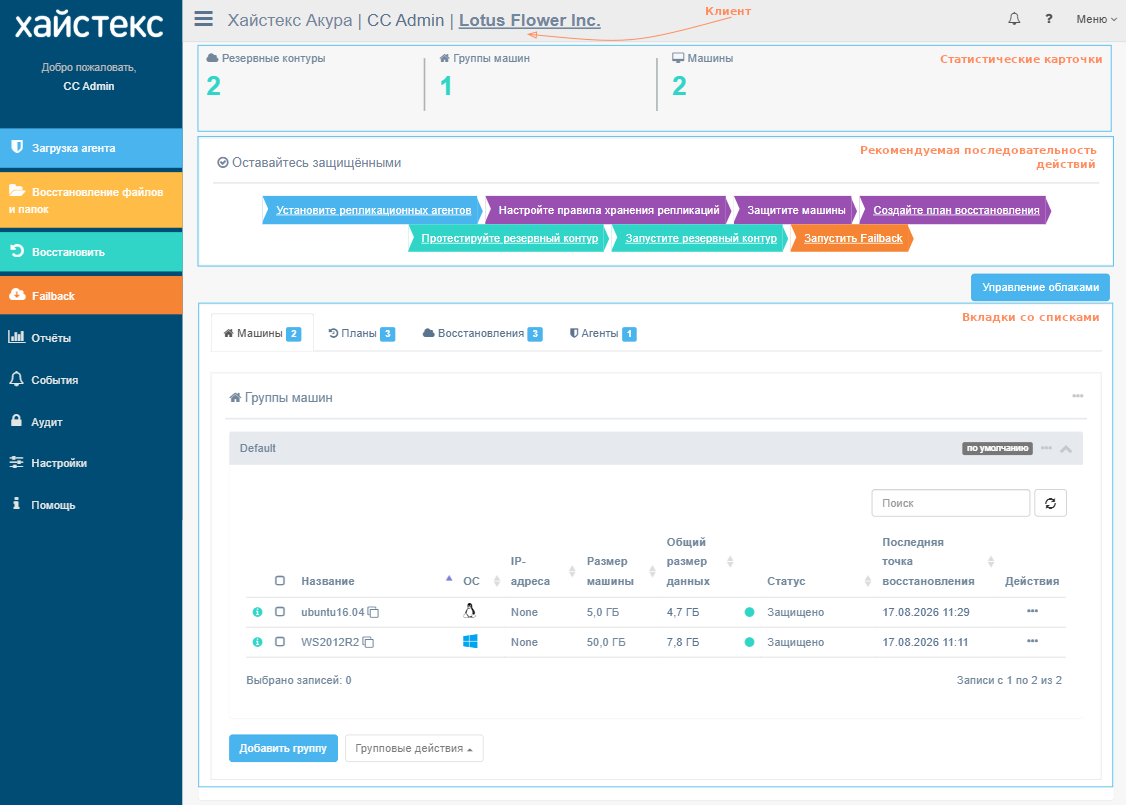
Как устроено аварийное восстановление в «Хайстекс Акуре»: панель ACP, создание DR-плана, порядок запуска машин, выбор хранилища и проверка восстановленного приложения.
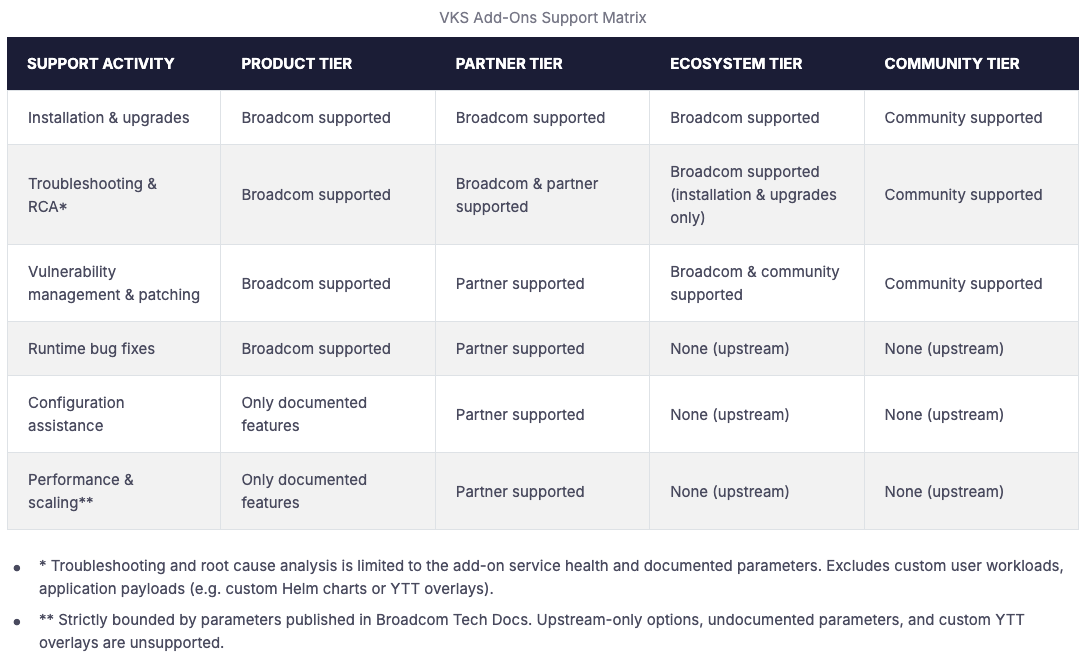
В VKS 3.7 для VMware Cloud Foundation 9.1 дополнения собраны в едином каталоге, появились новые компоненты, снижена нагрузка кластерного агента, а Policy Insights перенесён на сервер.
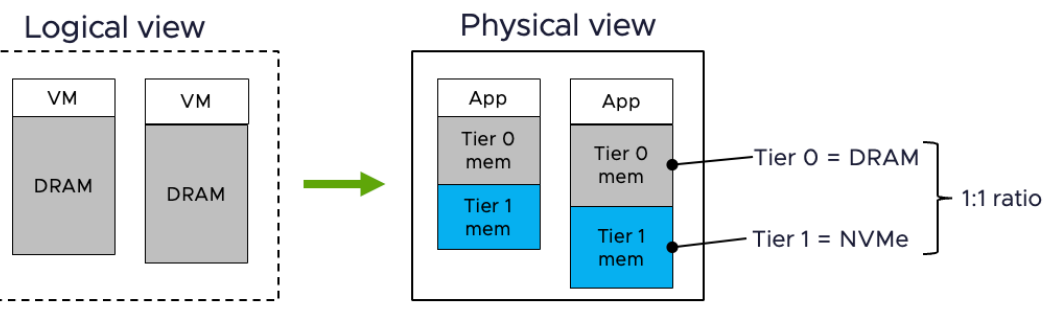
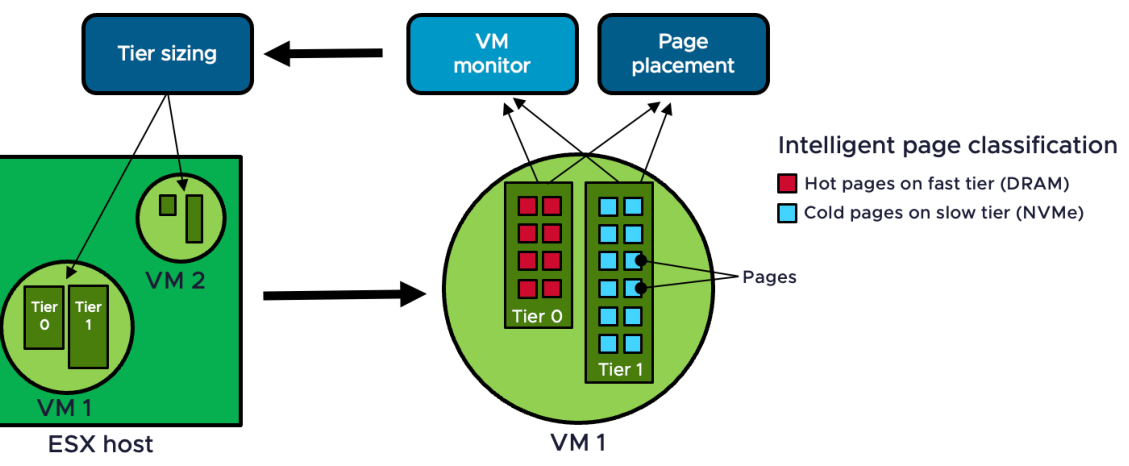
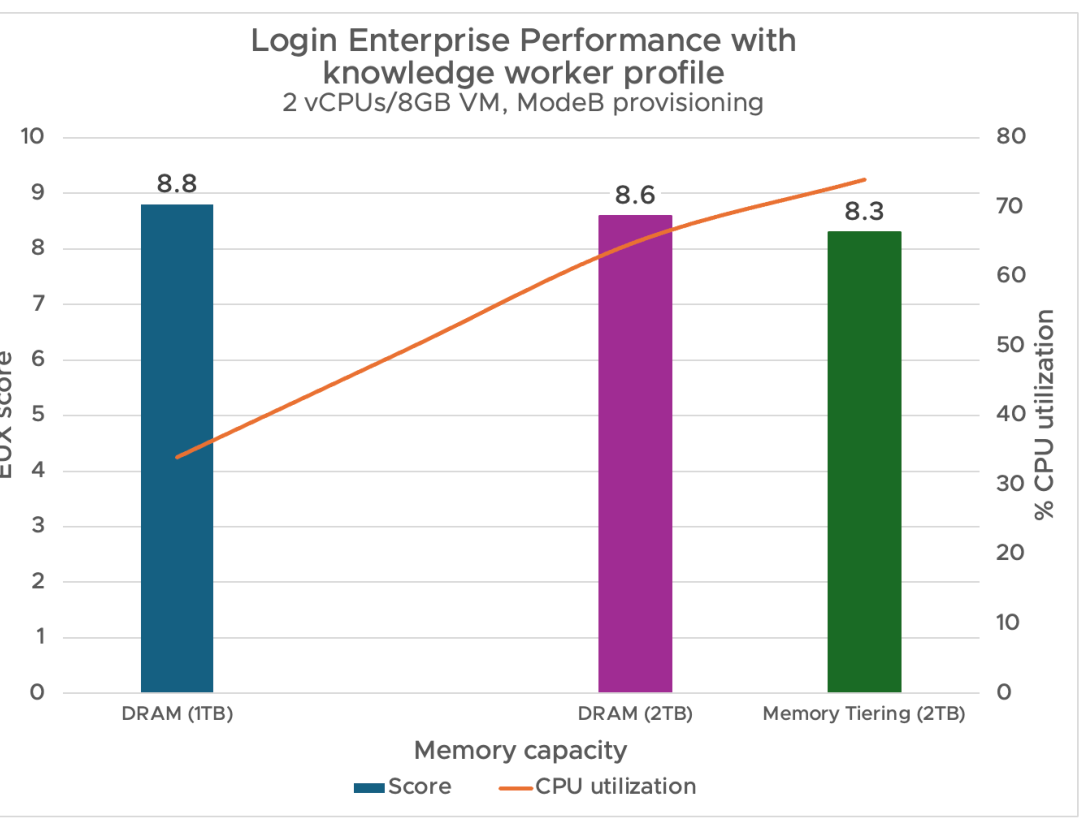
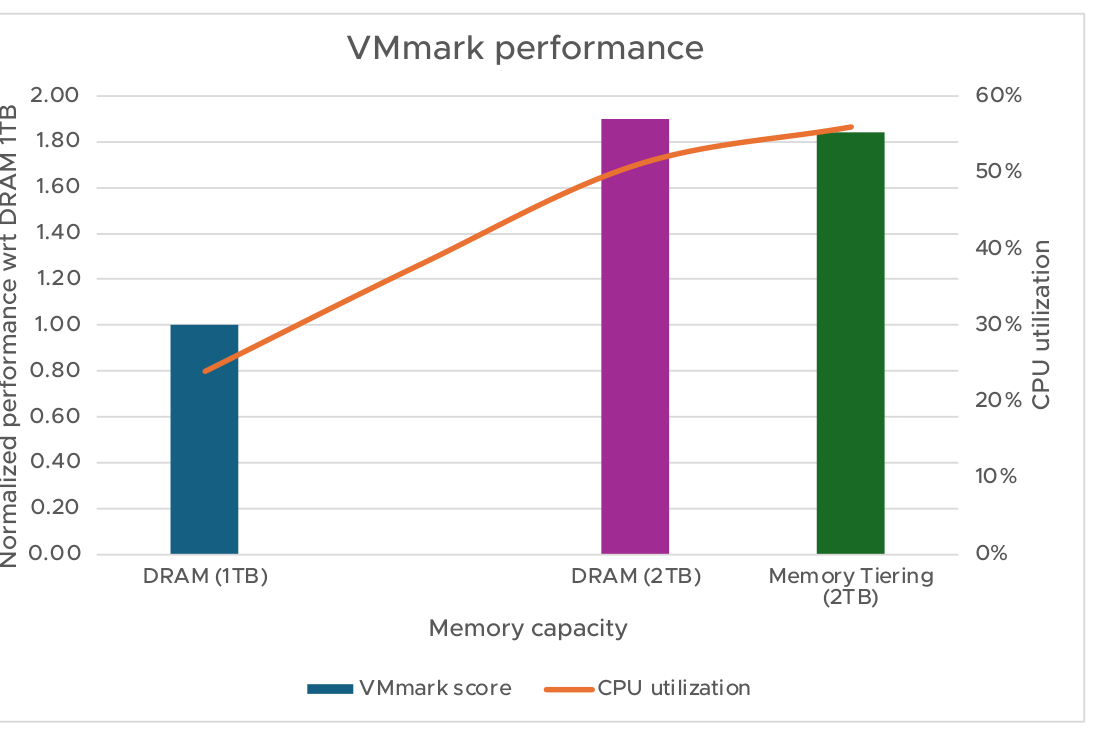
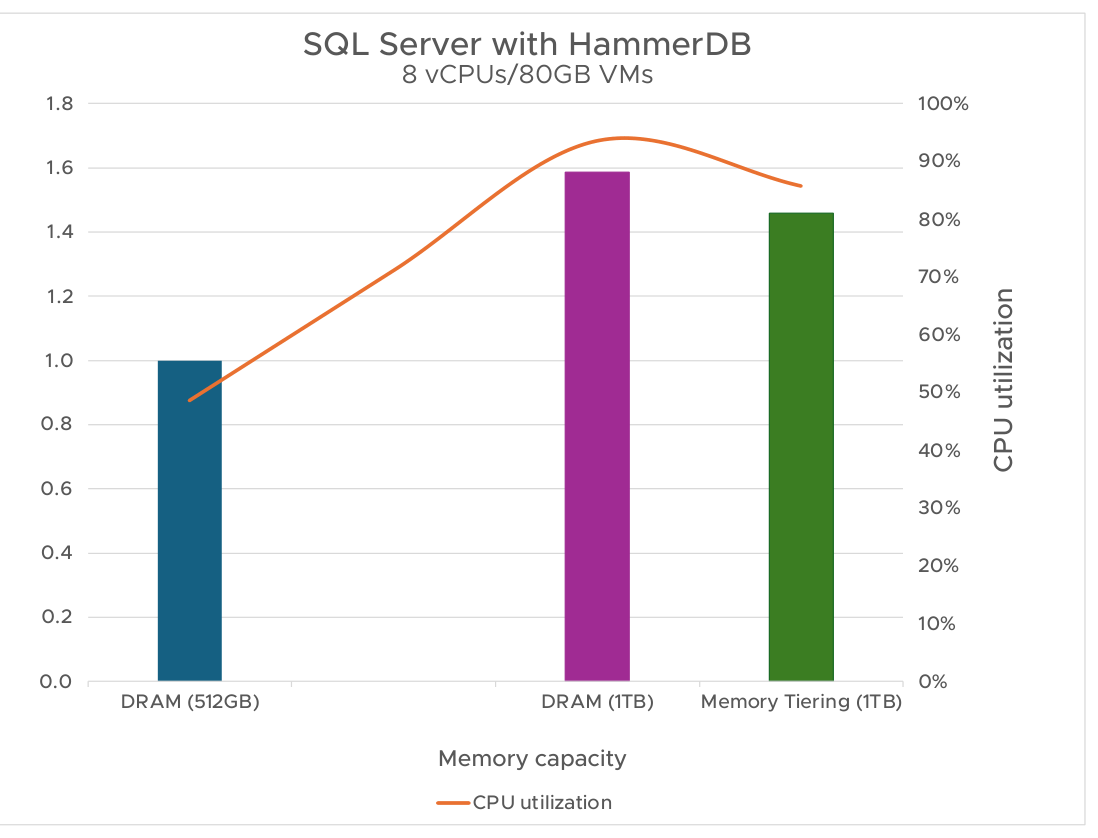
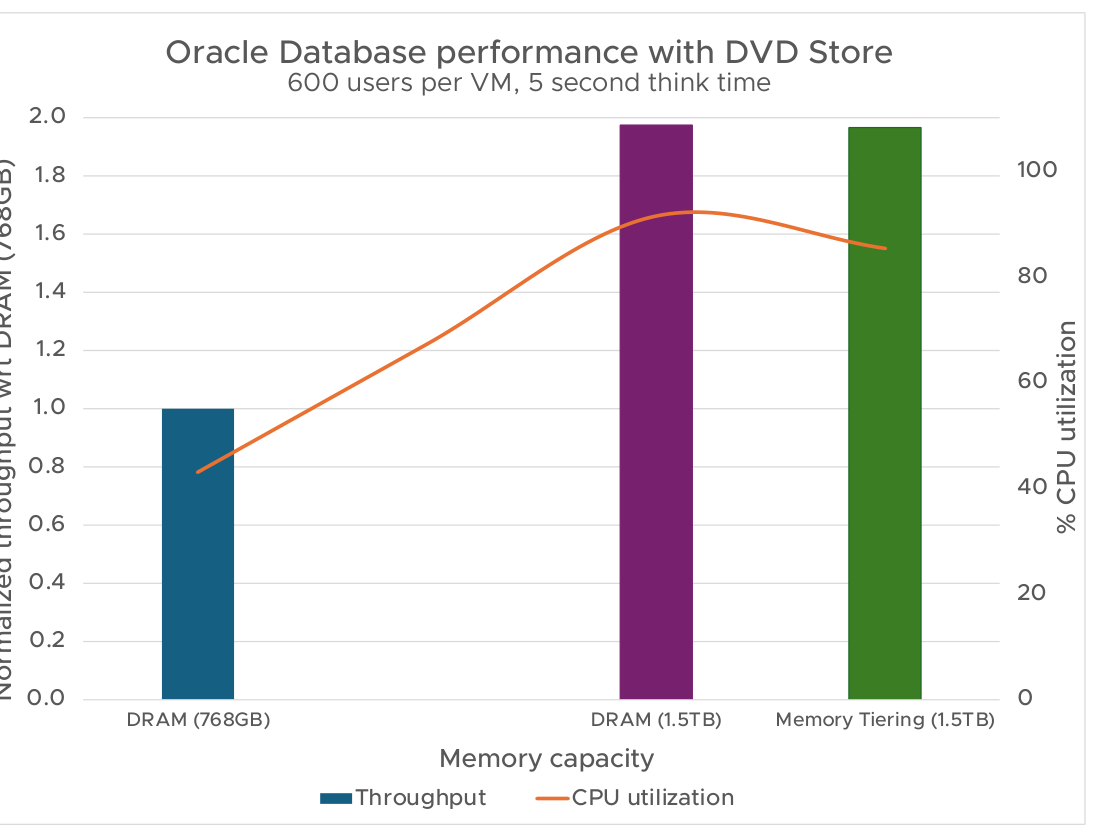
Memory Tiering — одна из тех возможностей, которые меняют сам подход к построению инфраструктуры. Она позволяет расширить системную память за счёт быстрых NVMe SSD, чтобы запускать более крупные нагрузки и консолидировать больше виртуальных машин, не докупая постоянно DRAM. Ценность здесь вполне реальная: лучшая утилизация ресурсов, более низкие затраты и возможность наращивать объём памяти по требованию. В паре с правильными накопителями технология обеспечивает стабильную производительность с низкой задержкой — создаётся ощущение, что памяти больше, чем было фактически куплено.
Memory Tiering — функция, которую нельзя игнорировать, однако получение от неё максимальной отдачи сводится к одному важному решению: выбору правильного накопителя. Ниже объясняется, почему этот выбор так важен.
Производительность против износостойкости
Представьте, что идёт подготовка нового сервера или проектирование архитектуры Memory Tiering. На столе — спецификации двух корпоративных NVMe SSD одного производителя. Оба относятся к одному и тому же «классу производительности». У обоих одинаковая скорость последовательного чтения 7 000 МБ/с, а пиковые показатели случайной записи приближаются к отметке в 1 миллион IOPS. Единственное отличие — один из них помечен как Read-Intensive (RI), а другой как Mixed-Use (MU).
Возникает соблазн предположить, что если у дисков одинаковый контроллер и одинаковые пиковые цифры на коробке, то и в нагрузочных тестах они поведут себя одинаково. В конце концов, рейтинг износостойкости говорит лишь о том, сколько проработает диск до выхода из строя, не так ли?
Нет. Если запустить на обоих накопителях продолжительный тест производительности, результаты окажутся совершенно разными. Класс износостойкости определяет гораздо больше, чем просто срок службы.
RI и MU: краткое сравнение
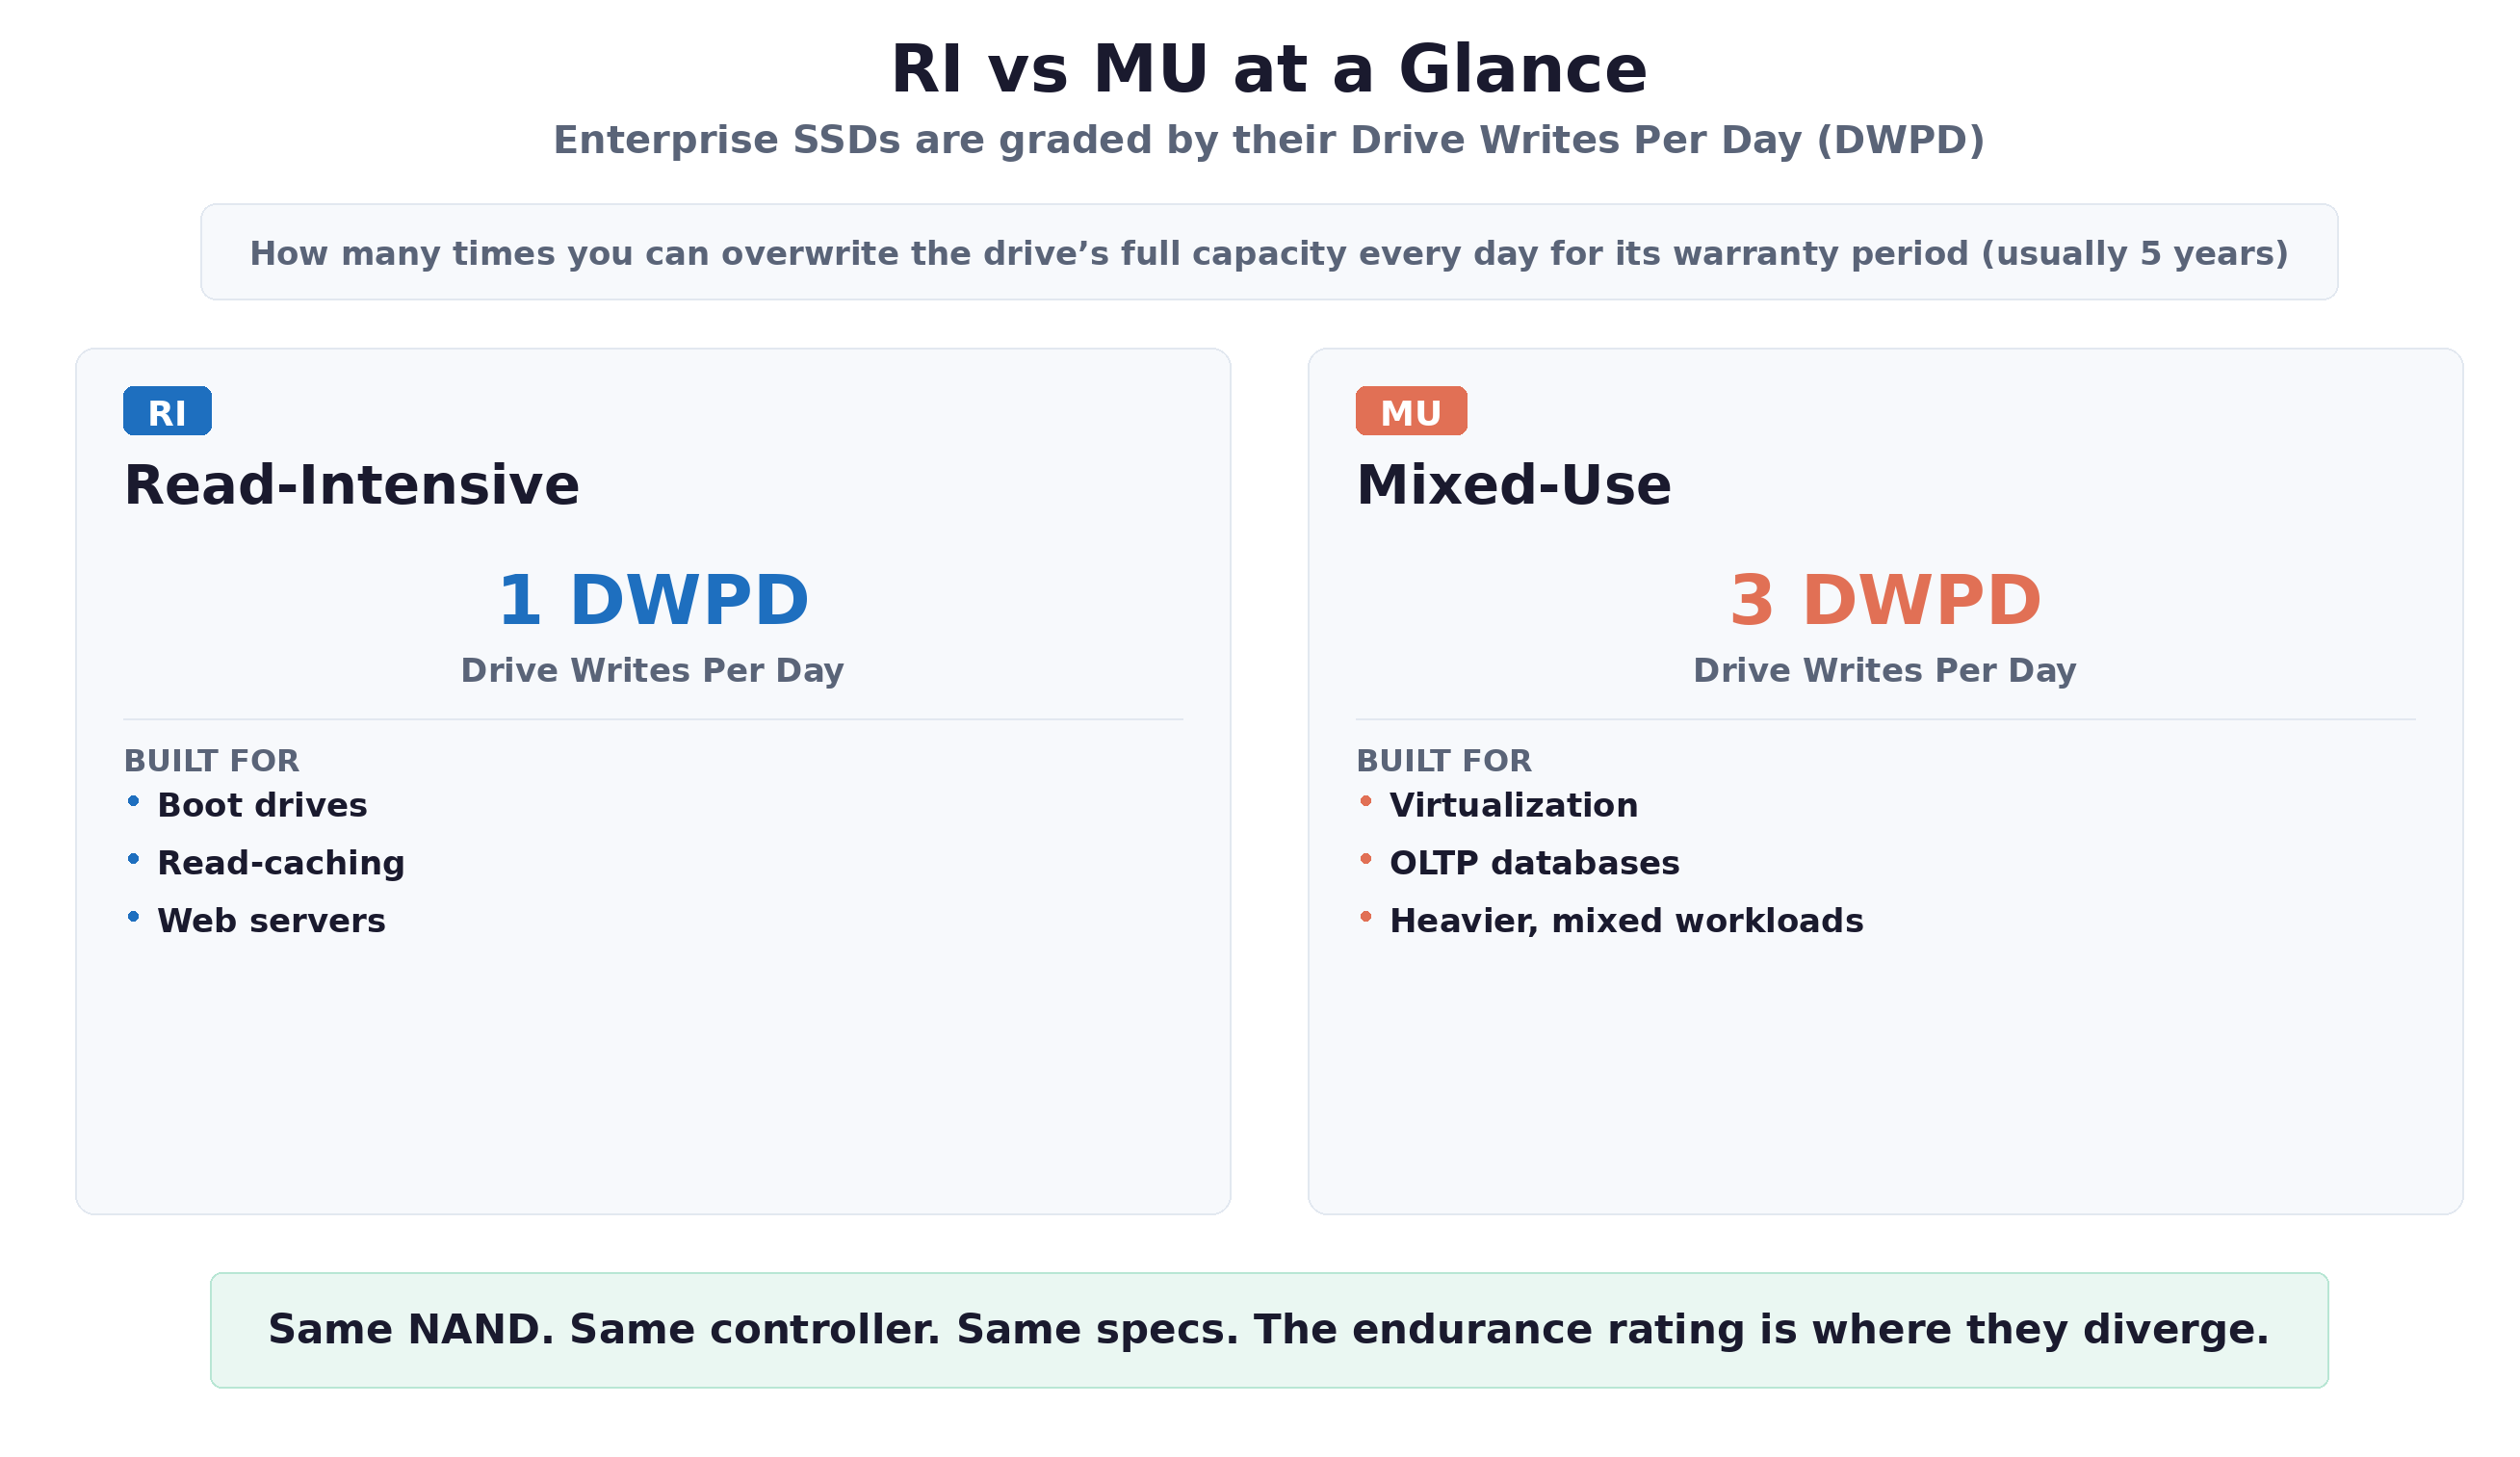
Корпоративные SSD классифицируются по показателю Drive Writes Per Day (DWPD) — это количество полных перезаписей всего объёма диска в день на протяжении гарантийного срока, который обычно составляет 5 лет.
Read-Intensive (RI) — как правило, рассчитаны на 1 DWPD или меньше. Предназначены для загрузочных дисков, кэширования чтения и веб-серверов.
Mixed-Use (MU) — как правило, рассчитаны на 3 DWPD. Предназначены для виртуализации, OLTP-баз данных и более тяжёлых смешанных нагрузок.
Пиковый режим против установившегося состояния
Если достать из коробки новенькие RI- и MU-накопители и прогнать короткий бенчмарк, они, скорее всего, покажут одинаково впечатляющие результаты. Причина в том, что диски находятся в состоянии Fresh Out of Box (FOB): все блоки флеш-памяти NAND пусты, и контроллер просто записывает данные настолько быстро, насколько позволяет интерфейс PCIe. Но это спринт, а корпоративное хранилище — это марафон.
Правильное тестирование доводит накопитель до установившегося состояния (Steady State) — момента, когда диск полностью заполнен. После заполнения SSD уже не может просто перезаписать старые данные. Он должен считать блок в память, стереть физический блок флеш-памяти и записать новые данные обратно. Этот процесс называется сборкой мусора (Garbage Collection). Именно в установившемся состоянии RI-накопитель упирается в стену, тогда как MU-накопитель продолжает уверенно работать.
Секретное оружие — Over-Provisioning
Всё объясняется резервированием ёмкости — Over-Provisioning (OP). Производители скрывают от операционной системы определённый процент физической флеш-памяти NAND, чтобы у контроллера было пространство для эффективной сборки мусора. Чем больше это рабочее пространство, тем быстрее контроллер может перемещать данные, не приостанавливая входящие операции записи от хоста.
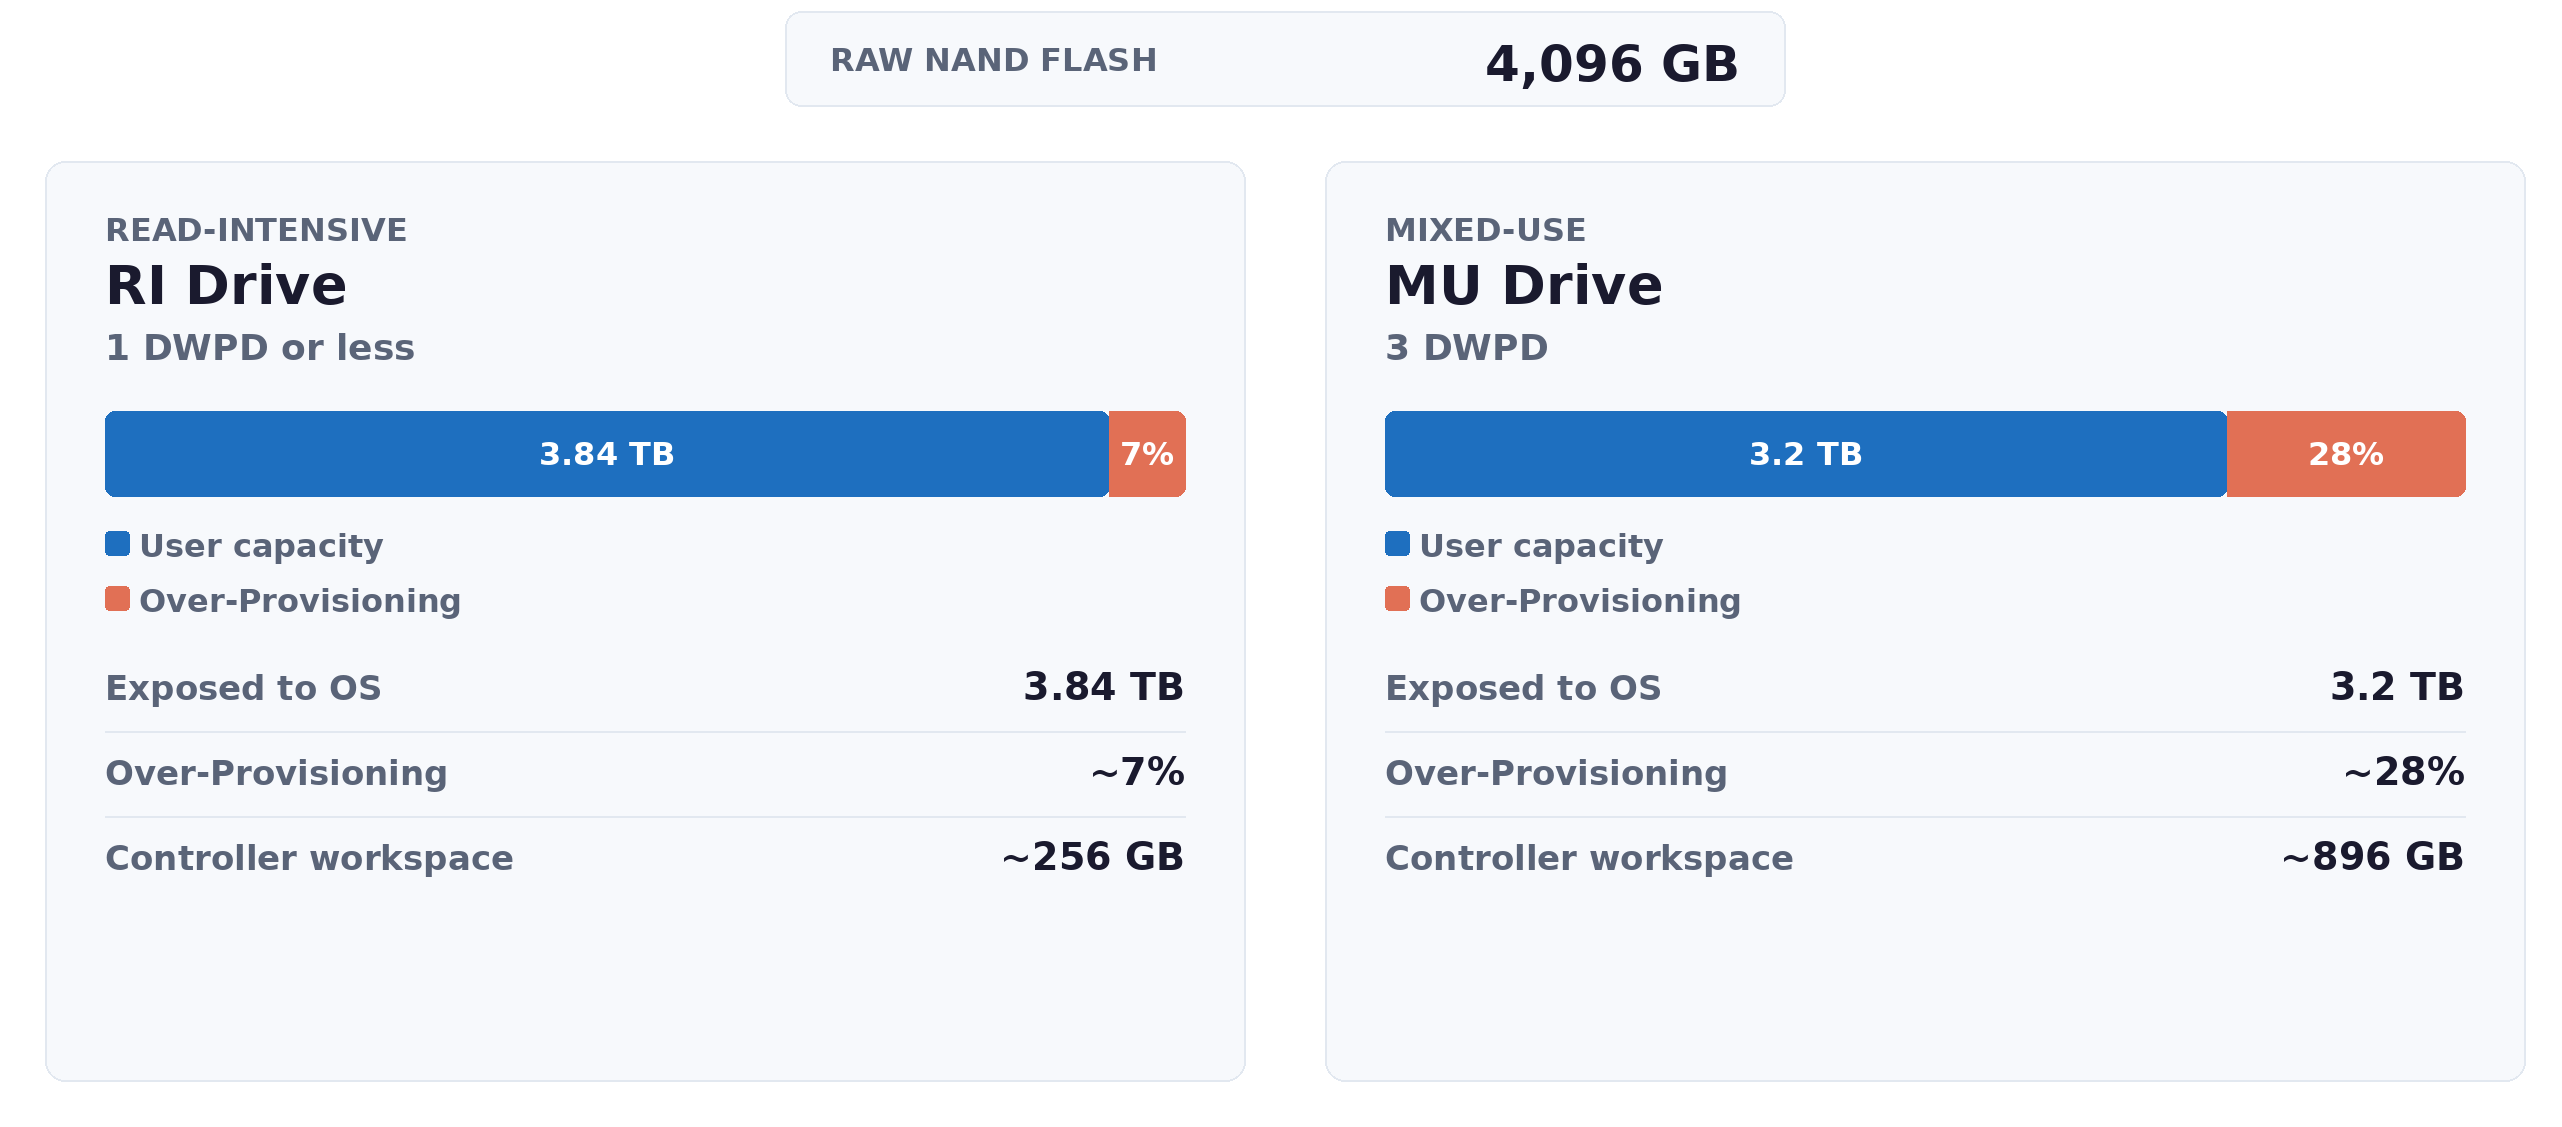
Накопители Read-Intensive (RI) обычно имеют около 7% Over-Provisioning.
Накопители Mixed-Use (MU) обычно имеют около 28% Over-Provisioning.
Даже если у обоих дисков одинаковые 4 096 ГБ физической памяти NAND, RI-накопитель предоставляет операционной системе около 3,84 ТБ, оставляя совсем небольшое рабочее пространство. MU-накопитель предоставляет лишь 3,2 ТБ, отдавая значительную часть ёмкости целиком под фоновое обслуживание. Именно это дополнительное рабочее пространство позволяет MU-накопителю стабильно работать под нагрузкой.
Почему Memory Tiering предпочитает MU-накопители
Именно здесь выбор накопителя становится критичным. Memory Tiering — это нагрузка с интенсивной записью и высокой степенью случайности. Система постоянно перемещает в фоне небольшие страницы памяти по 4 КБ между DRAM и NVMe. Это разумный и эффективный способ растянуть бюджет на память, но он действительно держит накопители постоянно занятыми.
Если выбрать RI-накопитель для Memory Tiering, ориентируясь только на его пиковые характеристики, эти цифры не отразят того, как диск ведёт себя при продолжительной интенсивной записи. RI-накопитель с ограниченным Over-Provisioning располагает меньшим фоновым рабочим пространством, и ему приходится чаще выполнять сборку мусора. Здесь этот эффект заметнее, чем в случае обычного файлового хранилища, поскольку каждое перемещение страницы чувствительно к задержкам.
28% OP у MU-накопителя — как раз то, что нужно. Такой объём даёт достаточное фоновое рабочее пространство для поддержания стабильной записи со сверхнизкой задержкой без остановок хост-системы. Сочетание Memory Tiering с корпоративными накопителями класса Mixed Use позволяет получить от функции максимальную отдачу.
Обрыв производительности
Следует уточнить: довести RI-накопитель до предела может любая продолжительная нагрузка с интенсивной записью, а не только Memory Tiering. Когда RI-накопитель долгое время получает непрерывный поток случайных операций записи блоками 4K, его контроллер может упереться в стену. Имея в распоряжении лишь около 7% Over-Provisioning, он вынужден часто приостанавливать входящие операции записи от хоста, чтобы выполнять циклы чтения-изменения-записи (read-modify-write) и освобождать место. Показатель IOPS может резко упасть — нередко до малой доли от заявленной скорости, — а хвостовая задержка (tail latency) возрастает.
У MU-накопителя тоже наблюдается падение, но благодаря 28% OP у контроллера есть обширное рабочее пространство для выполнения сборки мусора в фоне, и прерывать работу хоста ему приходится гораздо реже. Производительность снижается относительно пикового значения в состоянии FOB, но стабилизируется на устойчивом, предсказуемом и значительно более высоком базовом уровне. Это означает предсказуемую производительность — именно то, что требуется для Memory Tiering.
А что если использовать только треть RI-накопителя?
Логика рассуждений примерно такая. Если RI-накопитель рассчитан на 1 DWPD, а MU-накопитель — на 3 DWPD, то, оставив две трети RI-накопителя незаписанными, можно получить такую же эффективную износостойкость, как у MU. Вдобавок всё это пустое пространство работает как дополнительный Over-Provisioning, так что у сборки мусора будет достаточно места для работы. Проблема решена?
Действительно, такой подход решает две реальные проблемы. Ресурс износостойкости перестаёт вызывать беспокойство, а обрыв производительности в установившемся состоянии в основном исчезает. Но RI-накопитель всё равно не становится полноценным MU-накопителем. Разница заложена в прошивке и контроллере. Прошивка MU оптимизирована под нагрузки с интенсивной записью и отдаёт приоритет очередям записи, чтобы удерживать хвостовую задержку на низком уровне, тогда как прошивка RI отдаёт приоритет чтению. Внутренний кэш контроллера также распределяется иначе: MU-накопители выделяют больше высокоскоростной SRAM под буферизацию записи. При высокой нагрузке на запись хвостовая задержка RI-накопителя подскакивает выше даже тогда, когда сборка мусора не является узким местом. Для Memory Tiering MU-накопитель по-прежнему обеспечивает более стабильную задержку на уровне микросекунд, поскольку его контроллер и кэш специально спроектированы именно под такой профиль ввода-вывода.
Что касается стоимости, покупка RI-накопителя большего объёма с использованием лишь трети его ёмкости означает оплату пространства, которое никогда не будет задействовано, поэтому разница в цене заметно сокращается. MU-накопители по-прежнему остаются рекомендуемыми для Memory Tiering, а небольшая переплата — это инвестиция в предсказуемую производительность.
Итог
Memory Tiering — мощная функция, способная существенно изменить работу центра обработки данных, а также его бюджет. Она позволяет делать больше при меньшем объёме DRAM, а в сочетании с правильными накопителями обеспечивает стабильную производительность с низкой задержкой, на которую можно положиться. Выбор правильного накопителя во многом определяет, насколько хорошо Memory Tiering будет работать при продолжительных нагрузках. Нужны накопители с достаточным Over-Provisioning, чтобы справляться с интенсивной случайной записью, характерной для перемещения страниц памяти, без остановок. А это означает накопители Mixed-Use (MU) с рейтингом 3 DWPD.
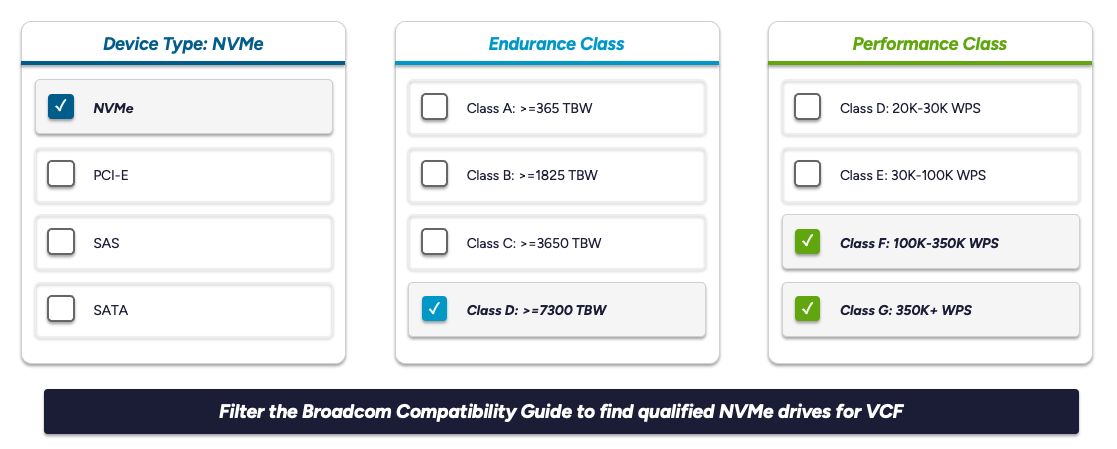
Как же найти подходящий накопитель? Самый надёжный способ — обратиться к Broadcom Compatibility Guide. Ищите накопители с классом производительности F или G и классом износостойкости D. Именно такие накопители спроектированы и сертифицированы для продолжительной нагрузки с интенсивной записью, которую создаёт Memory Tiering.
Если нужен быстрый способ, MU-накопители легко распознать с первого взгляда по их объёму. Как правило, ёмкость MU-накопителей кратна 800 ГБ: 800 ГБ, 1,6 ТБ, 3,2 ТБ и так далее. Если объём диска укладывается в эту закономерность, скорее всего, это MU-накопитель с рейтингом 3 DWPD и 28% Over-Provisioning, необходимыми для Memory Tiering.
Используйте Memory Tiering вместе с правильными MU-накопителями — и вы получите от этой функции максимум: стабильную производительность, более рациональное потребление ресурсов и инфраструктуру, которая делает больше меньшими средствами.
VMware Cloud Foundation (VCF) обеспечивает операционную эластичность и эффективность использования ресурсов, необходимые современным масштабируемым AI-средам, и помогает превратить аппаратную AI-систему в частную, гибкую и готовую к AI инфраструктуру корпоративного уровня. На фоне резкого роста стоимости оборудования для центров обработки данных за последний год ИТ-директора компаний стремятся выжать максимум из каждого компонента своих ЦОД. VCF помогает предприятиям повысить загрузку ресурсов и оптимизировать AI-инфраструктуру.
Платформа VMware Cloud Foundation (VCF) недавно получила сертификацию NVIDIA для гипервизоров. VMware vSphere 9.1 (и все последующие релизы vSphere 9.x) теперь является сертифицированным NVIDIA гипервизором (NVIDIA-Certified Hypervisor) с производительностью AI-нагрузок, близкой к bare metal.
Команда Broadcom Performance провела обширные тесты производительности, демонстрирующие эффективность и гибкость VCF при выполнении AI-нагрузок в различных конфигурациях. Для разъяснения результатов опубликован технический документ (white paper) и готовится серия из четырех статей:
Часть 1 (эта статья): максимальная производительность, эффективность и гибкость в мультитенантных средах
Часть 2: максимальная загрузка GPU для наилучшей совокупной стоимости владения
Часть 3: максимальная загрузка CPU и памяти для наилучшей совокупной стоимости владения
Часть 4: использование разделения времени (time-slicing) для оптимизации пропускной способности инференса
Ниже представлена первая часть этой серии.
В мультитенантной среде каждым тенантом может быть подразделение, проект или внешний заказчик, и все тенанты используют одно и то же оборудование. VCF предоставляет необходимые возможности изоляции, оптимизации ресурсов и самообслуживания, которые делают AI более эффективным и безопасным в эксплуатации.
Основные тезисы:
VCF позволяет гибко развертывать множество вариантов облачных AI-архитектур, отвечающих требованиям корпоративного управления и обеспечивающих максимальное использование облачных ресурсов.
Для строгой изоляции и безопасности рабочие нагрузки каждого тенанта можно развернуть в отдельной виртуальной машине. В качестве альтернативы они могут работать в одной ВМ, но быть изолированы в контейнерах. GPU могут выделяться виртуальным машинам через passthrough GPU, vGPU или MIG vGPU, и любой из этих способов применим как при совместном использовании ВМ тенантами, так и при размещении их в отдельных ВМ.
В экспериментах с инференсом LLM было показано, что две разные архитектуры развертывания обеспечивают практически одинаковую пропускную способность и задержку.
Оптимизация развертывания AI-нагрузок в мультитенантных средах
VCF поддерживает множество гибких архитектур развертывания ИИ-систем, которые помогают максимально загрузить GPU и сохранить высокую производительность, одновременно обеспечивая изоляцию, безопасность и высокую доступность частных ИИ-облаков.
Для ресурсоемких ИИ-нагрузок, полностью потребляющих вычислительные ресурсы и память сервера, ИТ-администраторы могут с помощью VCF выделять отдельные физические серверы, что повторяет развертывание на bare metal, но при этом сохраняет доступ ко многим возможностям VCF. В предыдущей публикации было показано, что VCF демонстрирует лидирующие в отрасли результаты в бенчмарках MLPerf Inference 5.1 на различных GPU и CPU, включая NVIDIA H200 и B200, а также Intel Xeon с ускорением AMX, и на различных типах AI-нагрузок, включая Speech-to-Text (Whisper), Text-to-Video (Stable Diffusion XL), большие языковые модели (Llama3.1 405B, Llama2 70B, Llama3 8B), графовые нейронные сети (R-GAT) и компьютерное зрение (RetinaNet).
Во многих реальных сценариях вычислительные ресурсы корпоративных частных облаков большую часть времени недозагружены, поскольку рабочие нагрузки легкие (например, низкая интенсивность запросов на инференс или малый размер батча). Выделение отдельного оборудования под такие нагрузки приводит к значительной неэффективности и раздувает операционные расходы. В подобных случаях консолидация нескольких рабочих нагрузок на общем оборудовании критически важна для устойчивой и экономически эффективной эксплуатации частных AI-облаков.
В мультитенантных средах VCF ИТ-администраторы могут развертывать тенантов и управлять ими вручную либо через VCF Automation (модели развертывания тенантов описаны здесь). В зависимости от требований предприятия к безопасности и изоляции, управлять AI-нагрузками можно следующими способами:
Нагрузки тенантов в отдельных ВМ (изоляция на уровне ВМ):
Безопасность и сценарий использования: оптимально при строгих требованиях к безопасности и изоляции.
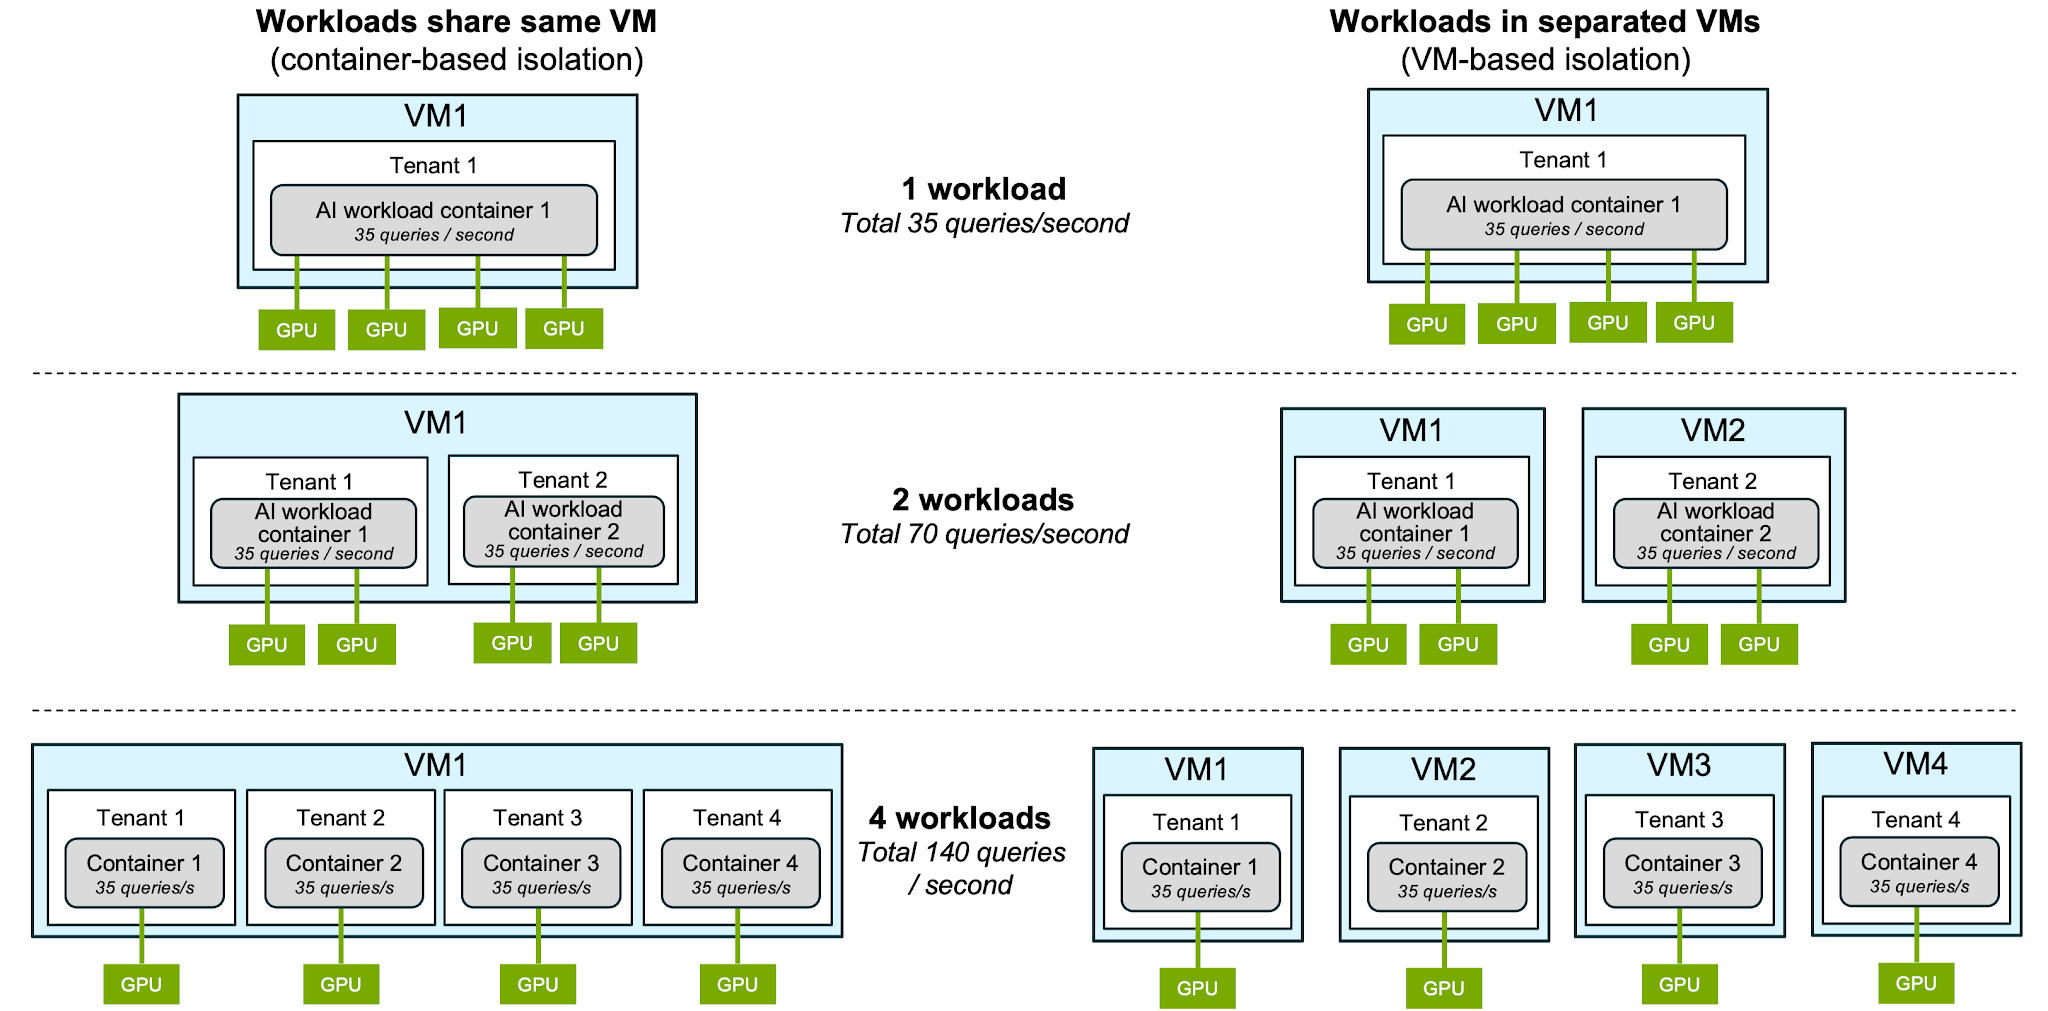
Конфигурация: рабочие нагрузки каждого тенанта развертываются в отдельных ВМ. GPU выделяются виртуальным машинам через прямой проброс (passthrough) GPU или NVIDIA vGPU. С vGPU виртуальной машине можно выделить целый GPU или его часть (дробное выделение), что позволяет совместно использовать ресурсы GPU между ВМ разных тенантов. Пример такой изоляции показан в правом столбце на рисунке 1. Эта конфигурация полностью поддерживается как VCF Automation, так и при ручном управлении.
Нагрузки тенантов в одной ВМ (изоляция на уровне контейнеров):
Безопасность и сценарий использования: оптимально для сред с более низкими требованиями к безопасности, где приоритетом являются консолидация нагрузок и упрощение управления AI-облаком.
Конфигурация: рабочие нагрузки разных тенантов консолидируются в одних и тех же ВМ, которым GPU могут назначаться через прямой проброс (passthrough) или vGPU. Пример такой изоляции показан в левом столбце на рисунке 1 (ниже). Совместное размещение нагрузок нескольких тенантов в одной ВМ поддерживается только при ручном управлении тенантами (VCF Automation требует, чтобы каждый тенант размещался в выделенной ВМ).
Сравнение производительности двух вариантов развертывания
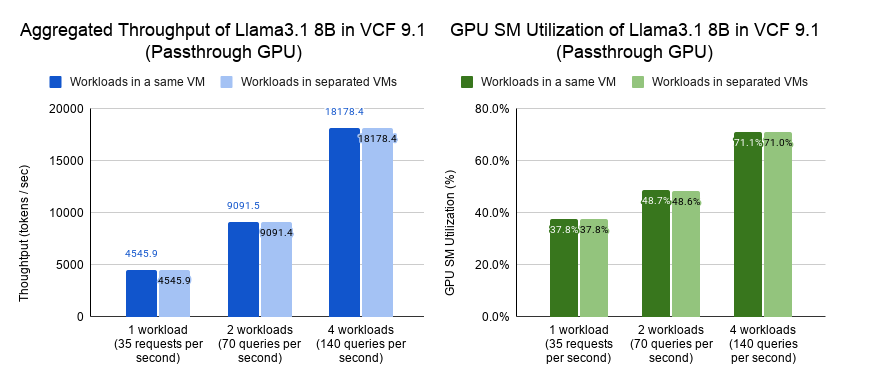
Для наглядности был проведен эксперимент, в котором рабочей нагрузке одного тенанта изначально выделяются все четыре GPU системы, как показано в первой строке рисунка 1 («1 workload»). Если предположить, что эта нагрузка сильно недозагружает GPU (как видно по загрузке потоковых мультипроцессоров GPU на рисунке 2), на сервере можно разместить больше нагрузок для повышения утилизации GPU, как показано во второй («2 workloads») и третьей («4 workloads») строках рисунка 1. В левом столбце представлены тестовые сценарии, в которых нагрузки всех тенантов находятся в одной ВМ, в правом — нагрузки каждого тенанта в отдельной ВМ.
Для имитации AI-нагрузки тенанта запускался MLPerf Inference с нагрузкой Llama3.1 8B при интенсивности 35 запросов на инференс в секунду на системе Dell PowerEdge XE7745 с двумя 64-ядерными процессорами AMD EPYC 9555 (всего 256 логических ядер), 768 ГБ памяти и четырьмя GPU NVIDIA RTX Pro 6000 96 ГБ. Каждая из этих нагрузок инференса выполняется внутри контейнера. Поскольку при такой легкой нагрузке GPU были недозагружены, на том же сервере удалось разместить до четырех аналогичных нагрузок, как показано на рисунке 1. При одновременной работе всех четырех нагрузок суммарная нагрузка на серверы составляет 140 запросов в секунду. Подробности экспериментальной установки, включая программное обеспечение, оборудование, конфигурацию ВМ и рабочие нагрузки, приведены в техническом документе.
Рисунок 1: тестовые сценарии с нагрузками в одной ВМ и нагрузками в отдельных ВМ. В обоих случаях GPU назначаются ВМ через passthrough GPU или vGPU.
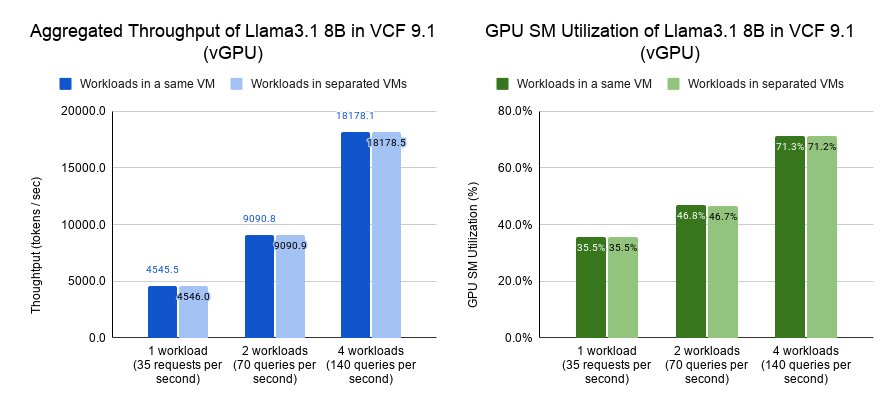
Эксперименты проводились как с passthrough GPU (рисунок 2), так и с vGPU (рисунок 3), чтобы продемонстрировать, что VCF поддерживает оба варианта для мультитенантных развертываний.
Основные результаты экспериментов:
Увеличение числа одновременных нагрузок на одном сервере с 1 до 4 позволило повысить пропускную способность инференса системы почти в четыре раза (примерно с 4500 до 18000 токенов в секунду), как показано на рисунках 2 и 3. Нагрузка определяется количеством одновременных запросов к движку инференса.
Загрузка потоковых мультипроцессоров (Streaming Multiprocessor) GPU выросла до 71% при четырех тенантах вместо 36–38% при развертывании только одного тенанта.
Разница в пропускной способности между двумя способами изоляции нагрузок (изоляция на уровне ВМ и изоляция на уровне контейнеров) практически отсутствовала.
Сравнение производительности при развертывании с passthrough GPU
Рисунок 2: производительность тенантов в отдельных ВМ и тенантов в общей ВМ с passthrough GPU.
Сравнение производительности при развертывании с vGPU
Рисунок 3: производительность тенантов в отдельных ВМ и тенантов в общей ВМ с vGPU.
Заключение
VCF — гибкая, эффективная и безопасная платформа для управления частным AI (Private AI) в мультитенантных корпоративных средах. Предоставляя ИТ-администраторам выбор между изоляцией на уровне ВМ для строгих требований безопасности и изоляцией на уровне контейнеров внутри общей ВМ для упрощения управления, VCF отвечает самым разным операционным и инфраструктурным потребностям.
Результаты экспериментов наглядно показывают, что консолидация нескольких легких, недозагруженных рабочих нагрузок на общем оборудовании решает распространенную проблему недоиспользования ресурсов практически без потерь производительности — независимо от того, распределены ли тенанты по отдельным ВМ или объединены в одной ВМ.
VCF позволяет предприятиям оптимизировать AI-инфраструктуру, обеспечивая высокую доступность, надежную безопасность и максимальную эффективность использования GPU. Это помогает компаниям контролировать затраты на AI-инфраструктуру.
После насыщенной событиями конференции VMware Explore 2026 в Лас-Вегасе и прозвучавших там анонсов каталог VMware Hands-on Labs был обновлён - теперь в нём представлена платформа VMware Cloud Foundation (VCF) 9.1.
Новые лабораторные работы дают администраторам, архитекторам и инженерам платформ возможность напрямую, на практике познакомиться с единой операционной моделью частного облака, улучшениями механизма memory tiering и значительным ростом масштабируемости, которые появились в VCF 9.1.
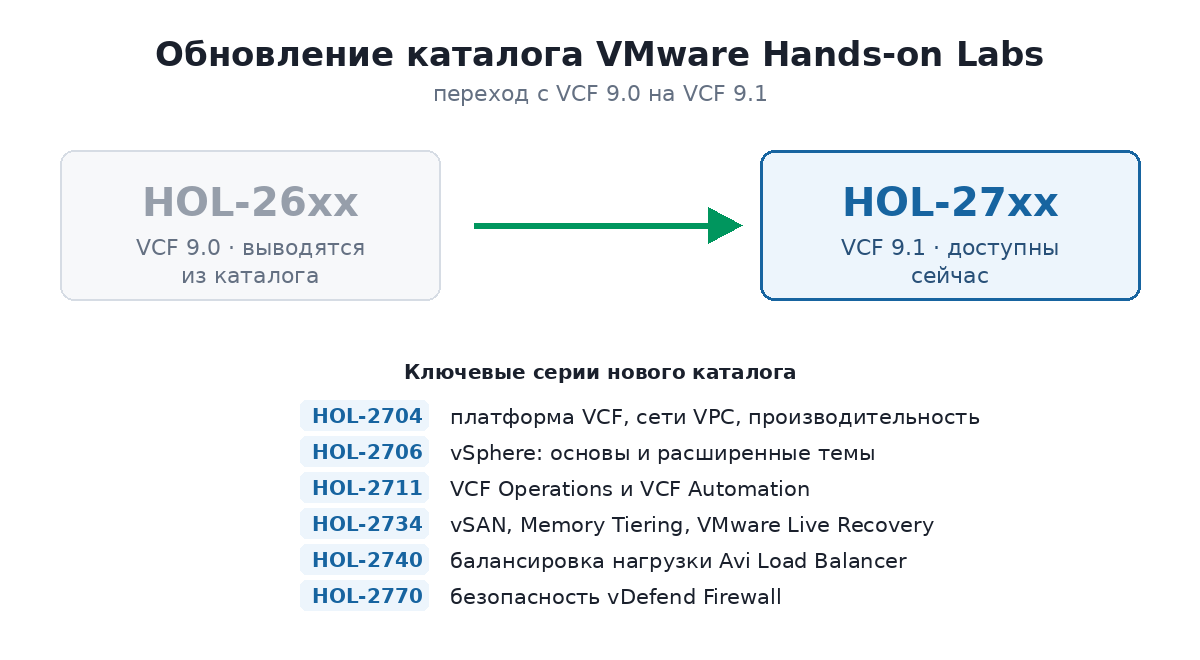
В рамках этого обновления прошлогодние лабораторные работы по VCF 9.0 (серия HOL-26xx) выводятся из каталога и заменяются обновлённой серией HOL-27xx.
Если планировалось пройти конкретную лабораторную работу прошлого года или идёт поиск определённой темы, приведённая ниже таблица соответствия поможет найти эквивалентный SKU для VCF 9.1.
Миграция устаревшей балансировки нагрузки с помощью Avi Conversion Tool
HOL-2740-05-ANS-L
Готовы попробовать?
Чтобы начать знакомство с этими возможностями, не нужно разворачивать собственную вложенную инсталляцию. Достаточно перейти в каталог VMware Hands-on Labs и запустить выбранную лабораторную работу прямо в браузере. Будь то проверка нового интерфейса VCF Operations, эксперименты с NVMe memory tiering или погружение в Private AI — все эти среды полностью подготовлены и доступны уже сегодня.
Полный каталог новых лабораторных работ доступен здесь: каталог VCF 9.1.
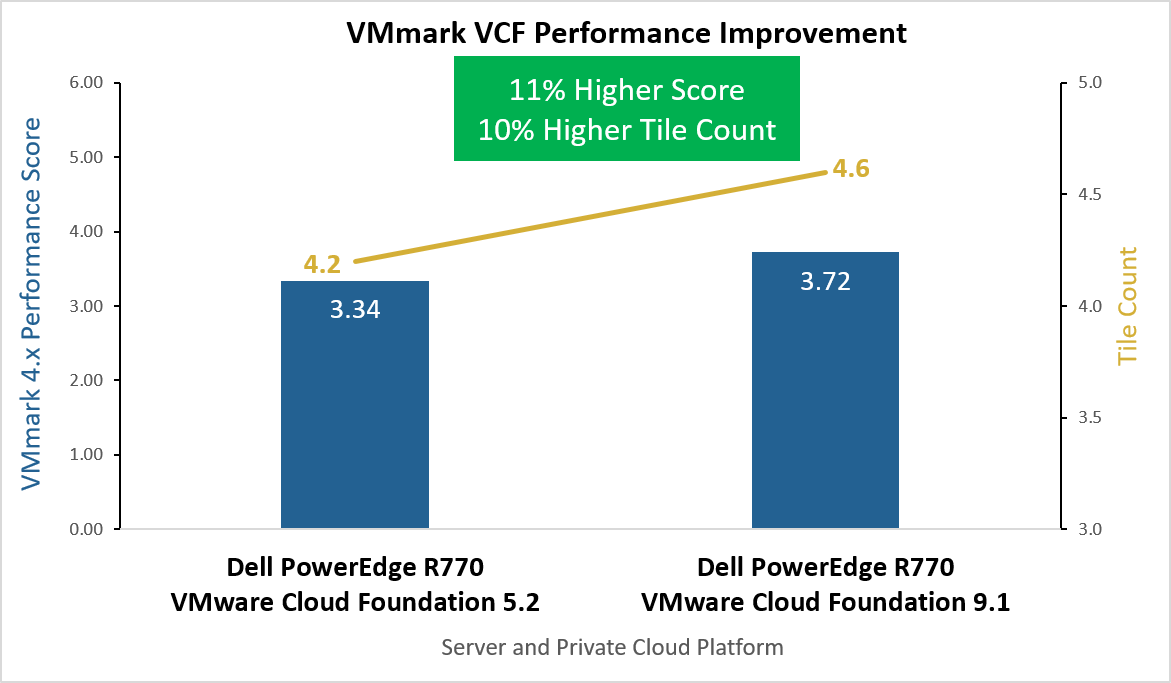
Первые результаты VMmark 4.1: эти результаты также стали первыми, полученными с помощью VMmark 4.1 — новейшего выпуска бесплатного инструмента для тестирования корпоративных сред виртуализации. Если VMmark 4.0 измеряет производительность и масштабируемость частного облака, то VMmark 4.1 добавляет измерение энергопотребления через показатель Performance Per Kilowatt (PPKW). Например, новый результат Dell в категории Server Power-Performance составляет 1,5255 PPKW при 4,6 тайла. Это помогает понять и сравнить, сколько энергии требуется разным средам для выполнения одного и того же объёма работы.
При использовании абсолютно тех же серверов, процессоров и массива хранения новые результаты на VCF 9.1 превзошли показатели VCF 5.2: оценка производительности оказалась выше на 11%, а количество тайлов — на 10%. Это означает, что в данной среде простое обновление до VCF 9.1 позволило запустить больше виртуальных машин и выполнить ещё больший объём работы. Конфигурация оборудования и сравнение результатов тестирования приведены ниже:
VMware VMmark 4 — это бесплатный инструмент тестирования на уровне кластера, который применяют производители оборудования и другие организации для измерения производительности и масштабируемости корпоративных сред виртуализации; он стал стандартным средством для решения этой задачи. Дополнительные сведения о VMmark 4 приведены в материалах ниже:
Одна из функций VMware Cloud Foundation (VCF) 9.1.1, которые вызывают особый интерес — новый AI Assistant for VCF. Встраивание AI непосредственно в VCF — отличная новость для инфраструктурных команд. И хотя речь пока идёт лишь о первом релизе, можно ожидать, что он откроет множество интересных возможностей для устранения неполадок, подготовки отчётов, получения аналитики по эксплуатации и, в конечном счёте, для повышения операционной эффективности, ведь у инфраструктурных команд высвободится ценное время.
Ещё важнее то, что по мере наступления эпохи, в которой AI-агенты действуют в таких масштабах и с такой скоростью, с которыми человеку просто не сравниться, подобные возможности будут приобретать всё большее значение. AI не только поможет инфраструктурным командам масштабировать свою работу, но и позволит им лучше подготовиться к защите от угроз, действующих с машинной скоростью, и к реагированию на них.
В настоящее время AI Assistant for VCF поддерживает как облачных провайдеров LLM-моделей, так и VCF Private AI Services (PAIS). Для простоты настройки и быстрого знакомства с новой возможностью ниже описана конфигурация с использованием Google Gemini — на данный момент это единственный поддерживаемый облачный провайдер LLM.
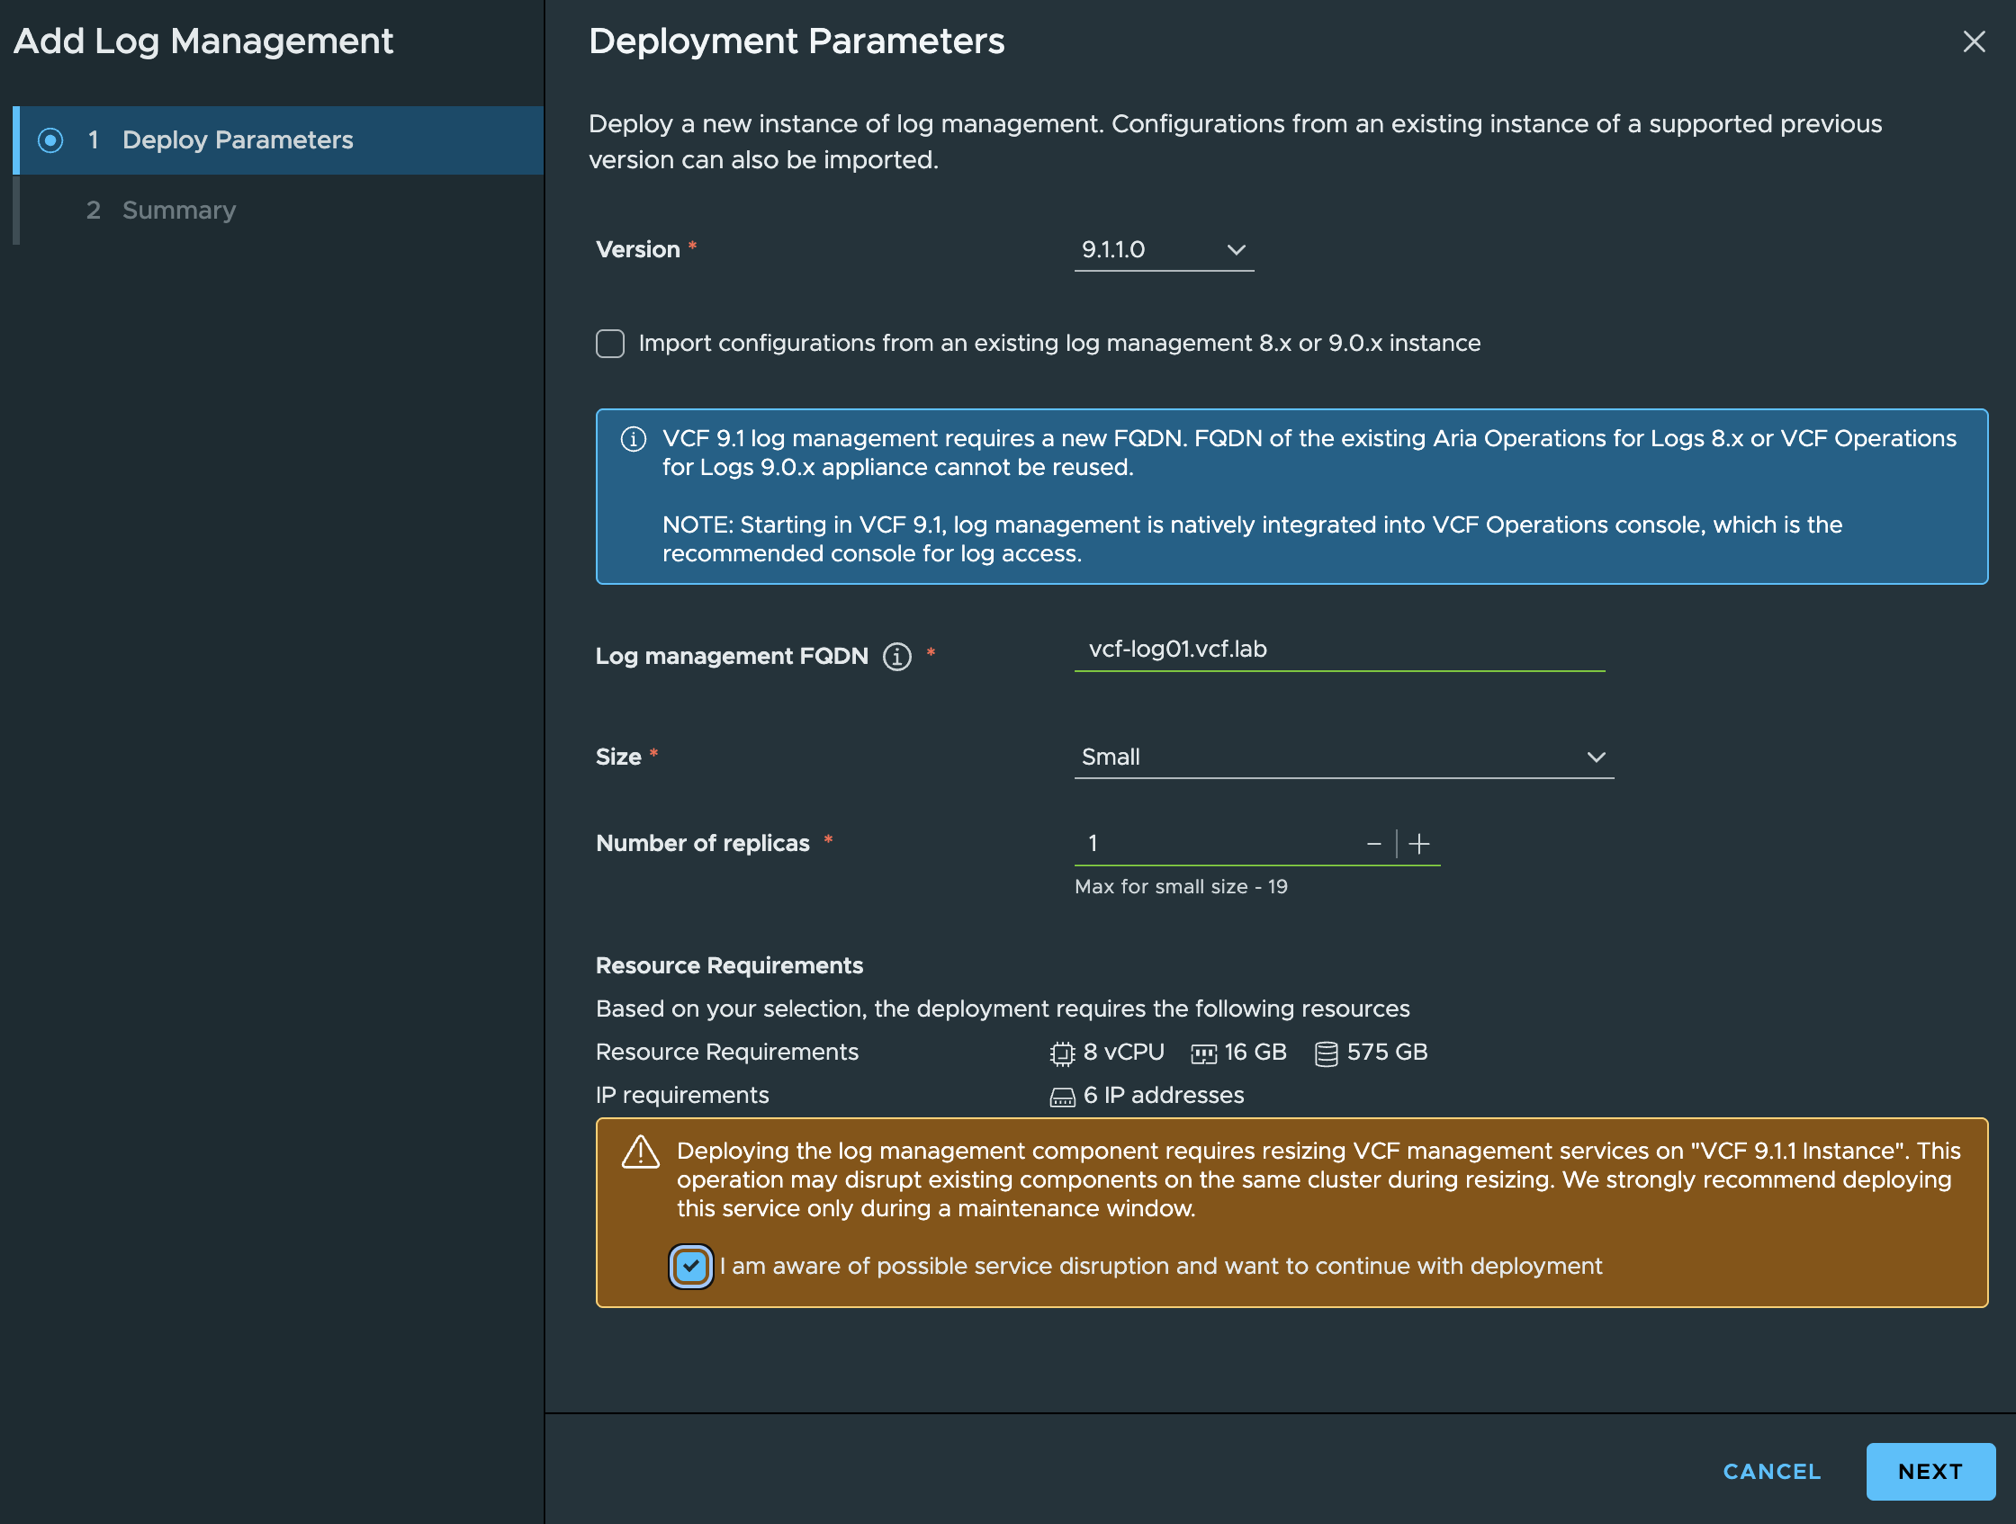
Шаг 1 — включите Log Management: войдите в VCF Operations и перейдите в раздел Build > Lifecycle > VCF Management > Add Component, чтобы запустить развёртывание.
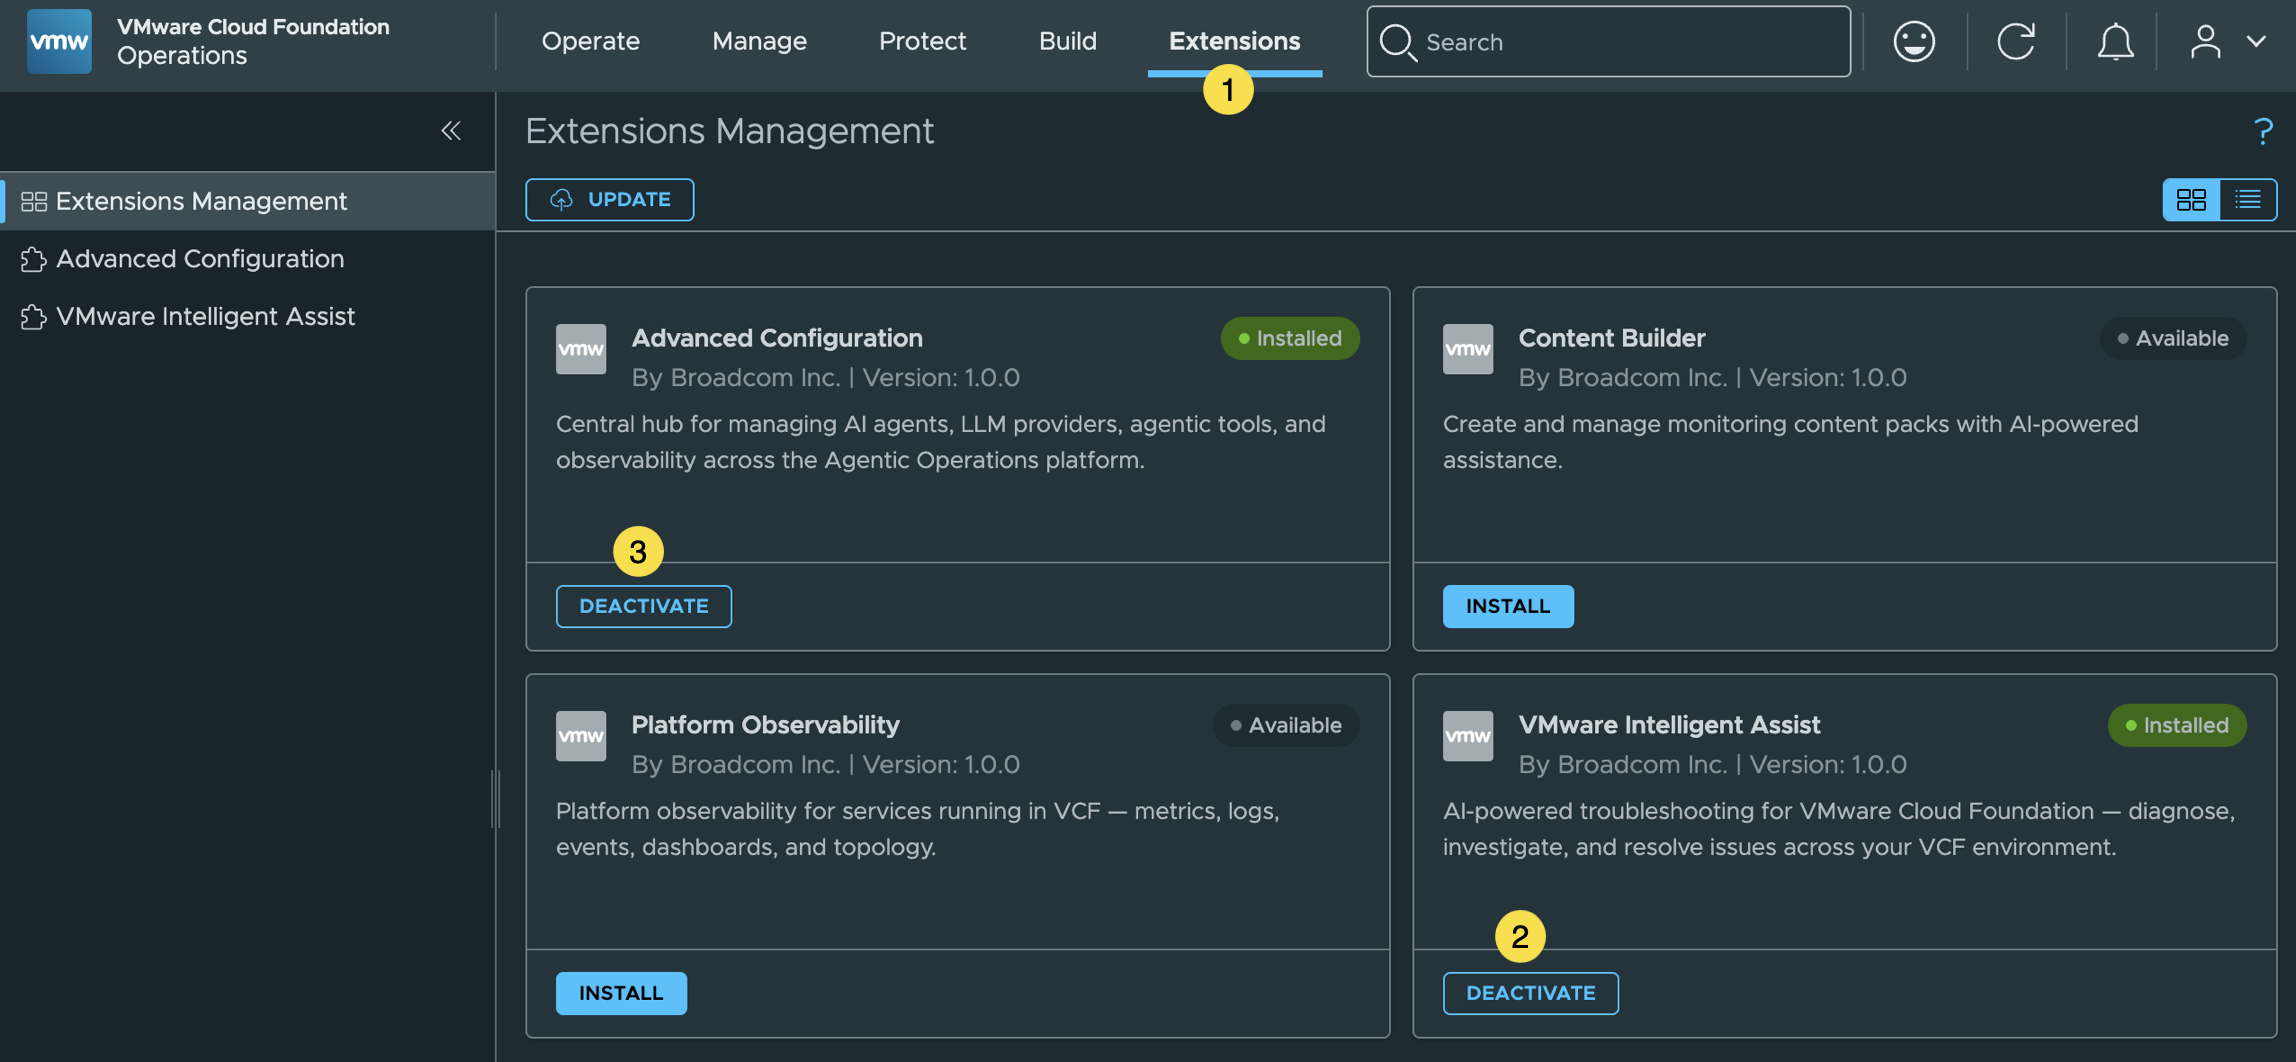
Шаг 2 — в интерфейсе VCF Operations перейдите в раздел Extensions > Extension Management и активируйте оба расширения: VMware Intelligent Assist и Advanced Configuration.
Примечание: если настроен VCF SSO, разрешение, необходимое для отображения плитки Extensions, по умолчанию не включено. В этом случае можно либо войти под локальной учётной записью admin, чтобы просматривать, настраивать и использовать AI Assistant for VCF, либо изменить роль Administrator: для этого нужно перейти в раздел Operate > Administration > Control Panel > Access Control > Roles > Administrator и включить разрешение Extensions.
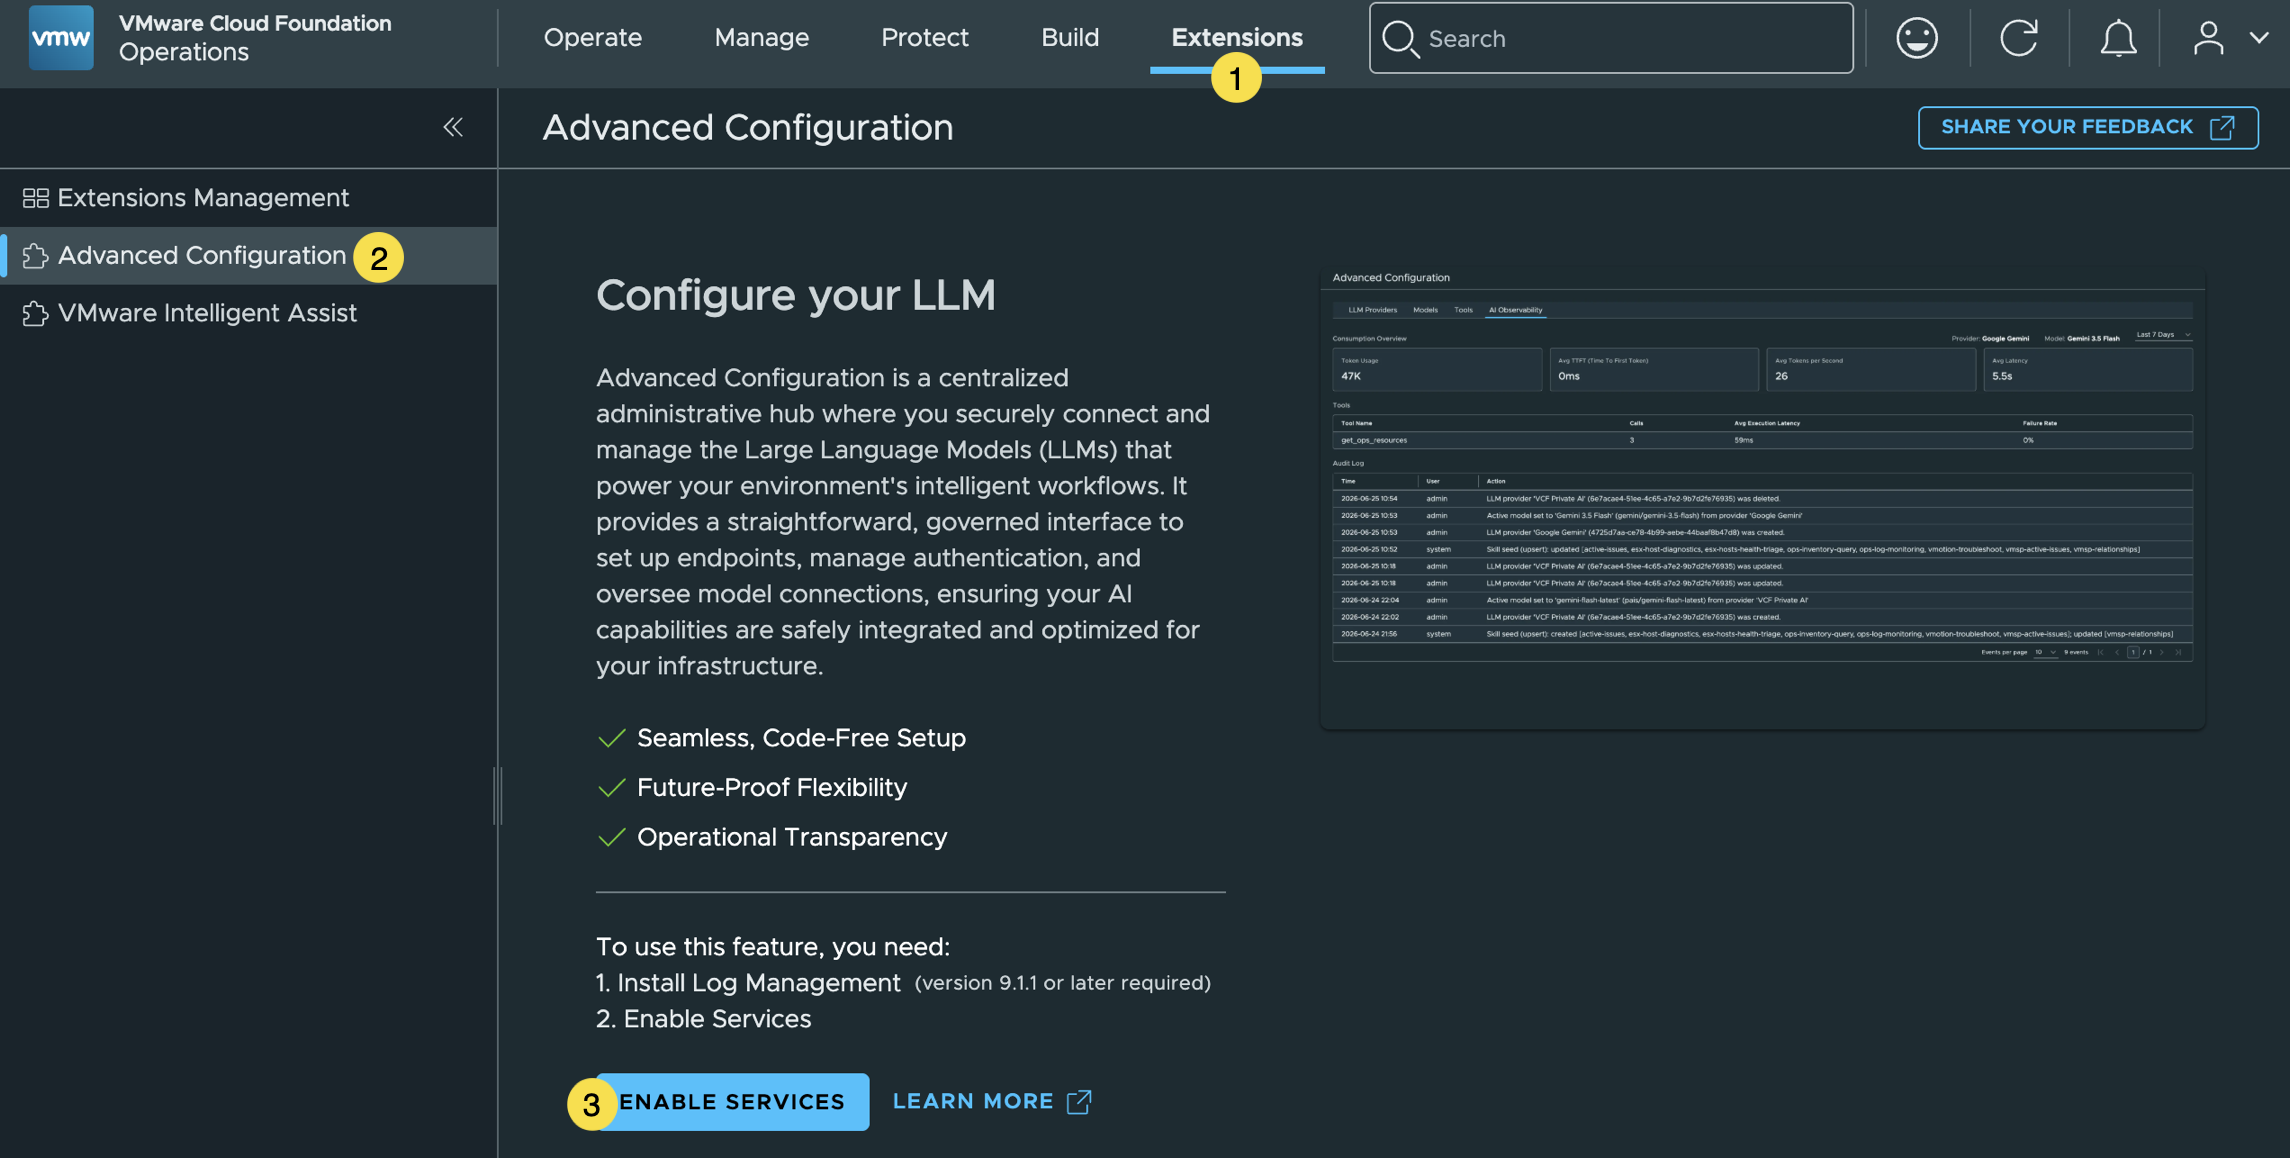
Шаг 3 — перейдите в раздел Extensions > Advanced Configuration и включите сервис VMware Intelligent Assist.
Шаг 4 — перейдите в раздел Extensions > Advanced Configuration > LLM Providers, чтобы добавить провайдера LLM: им может быть PAIS или Google Gemini. В данном примере используется Google Gemini. Выберите Google Gemini в качестве провайдера и введите свой ключ API Gemini, чтобы завершить настройку.
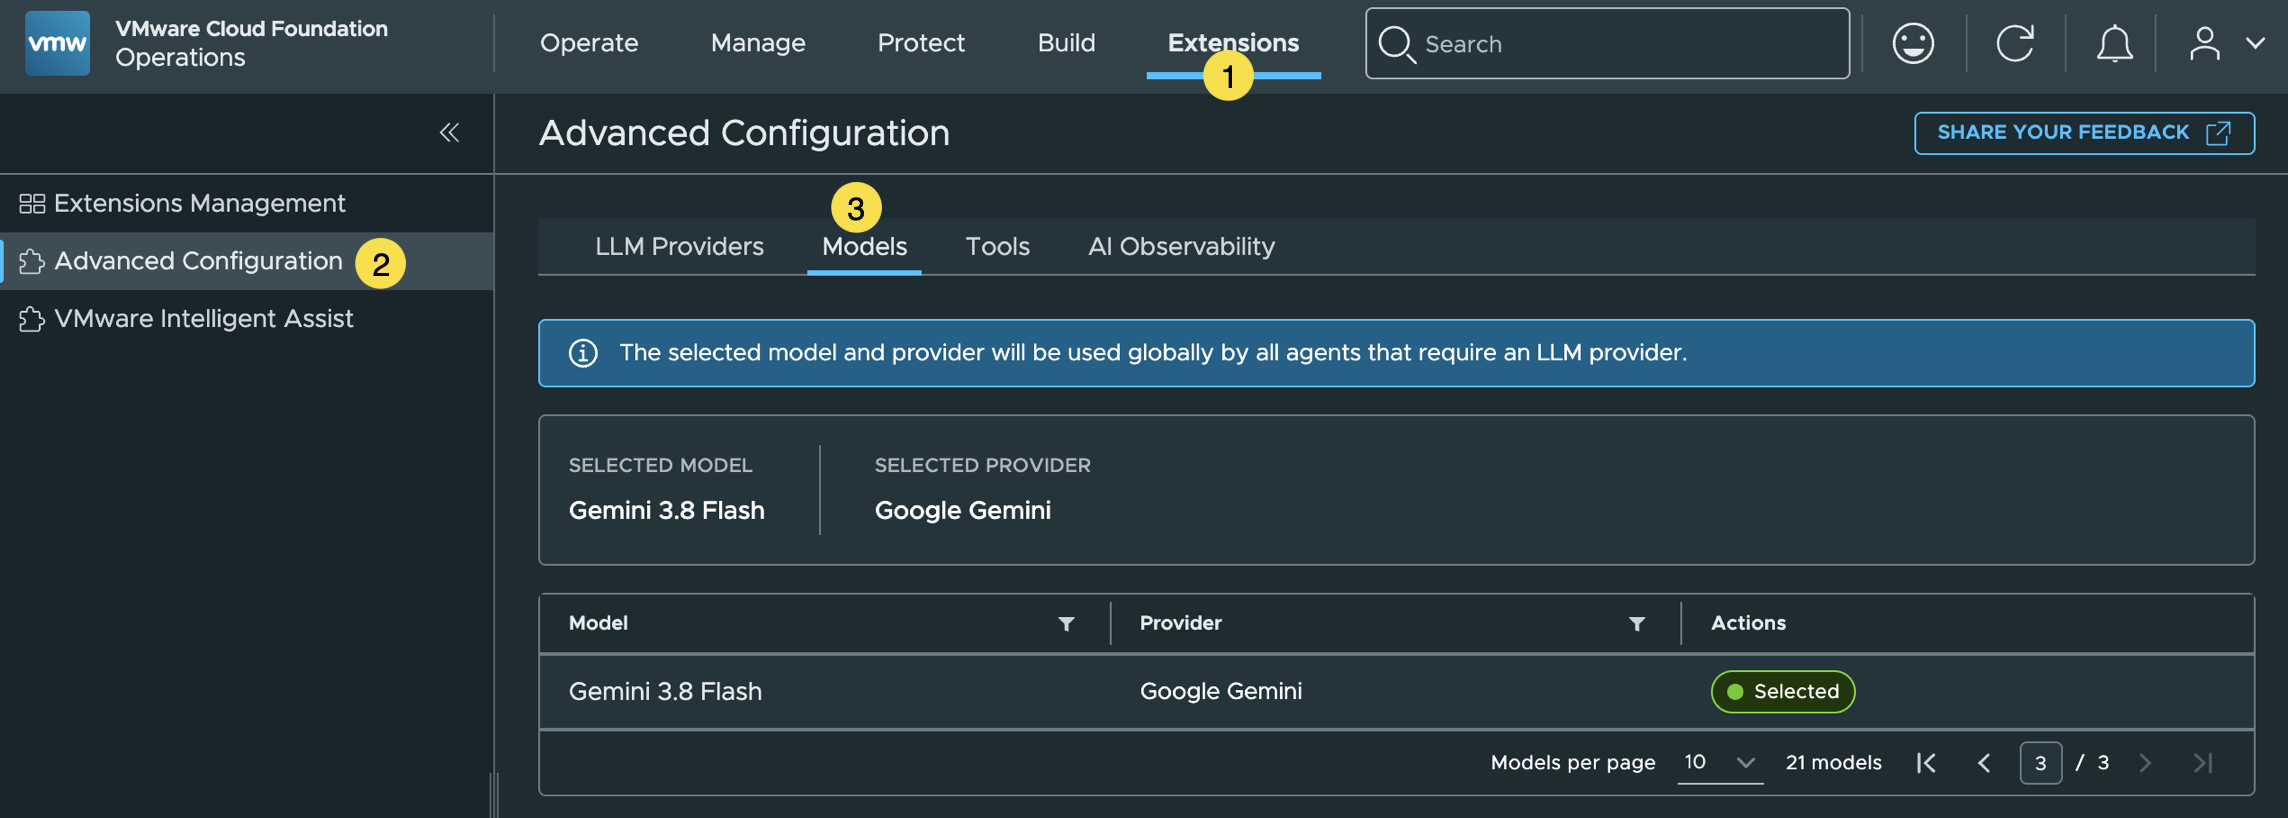
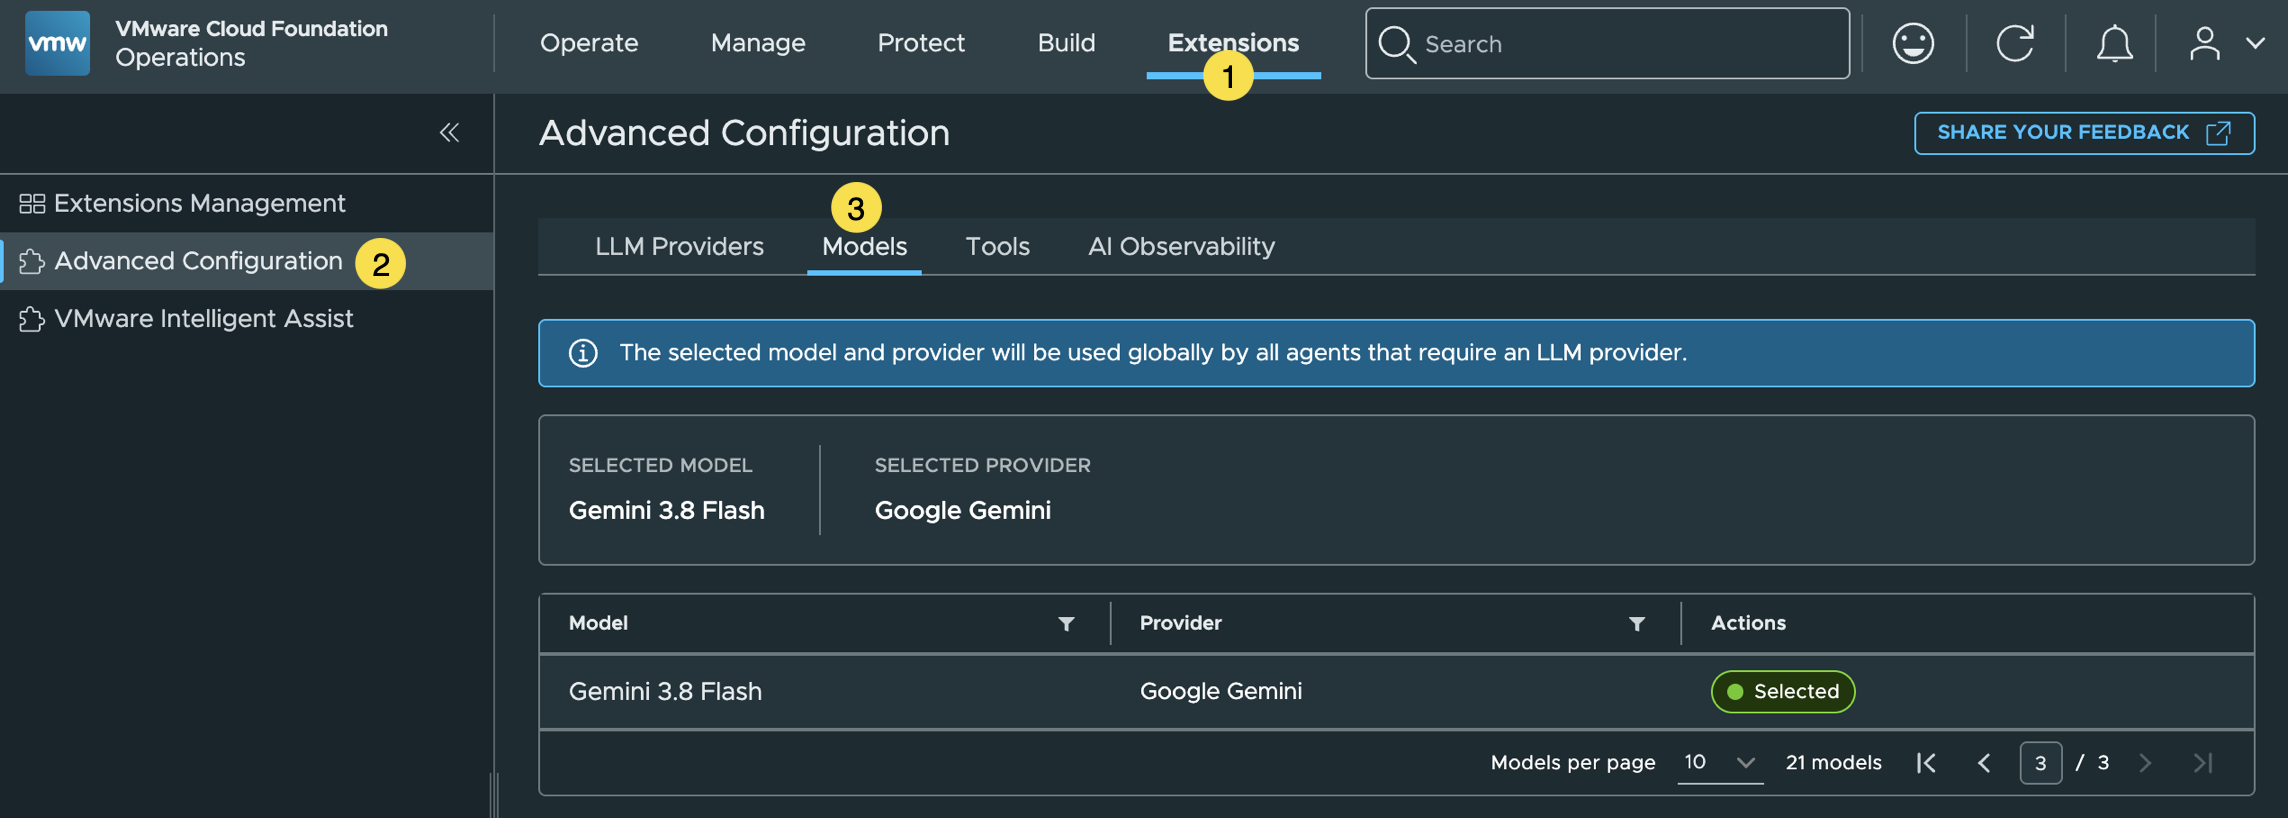
Шаг 5 — перейдите в раздел Extensions > Advanced Configuration > Models и выберите нужную модель Google Gemini.
Примечание: хотя провайдер выводит для выбора список всех доступных моделей, на деле использовать удаётся не все из них. Такая проблема возникла после выбора первой модели в списке: позднее выяснилось, что она уже устарела (deprecated). К сожалению, сервис не выдал никакой ошибки, поэтому причина проблемы оказалась далеко не очевидной.
Теперь всё готово, чтобы опробовать VMware Intelligent Assist в деле!
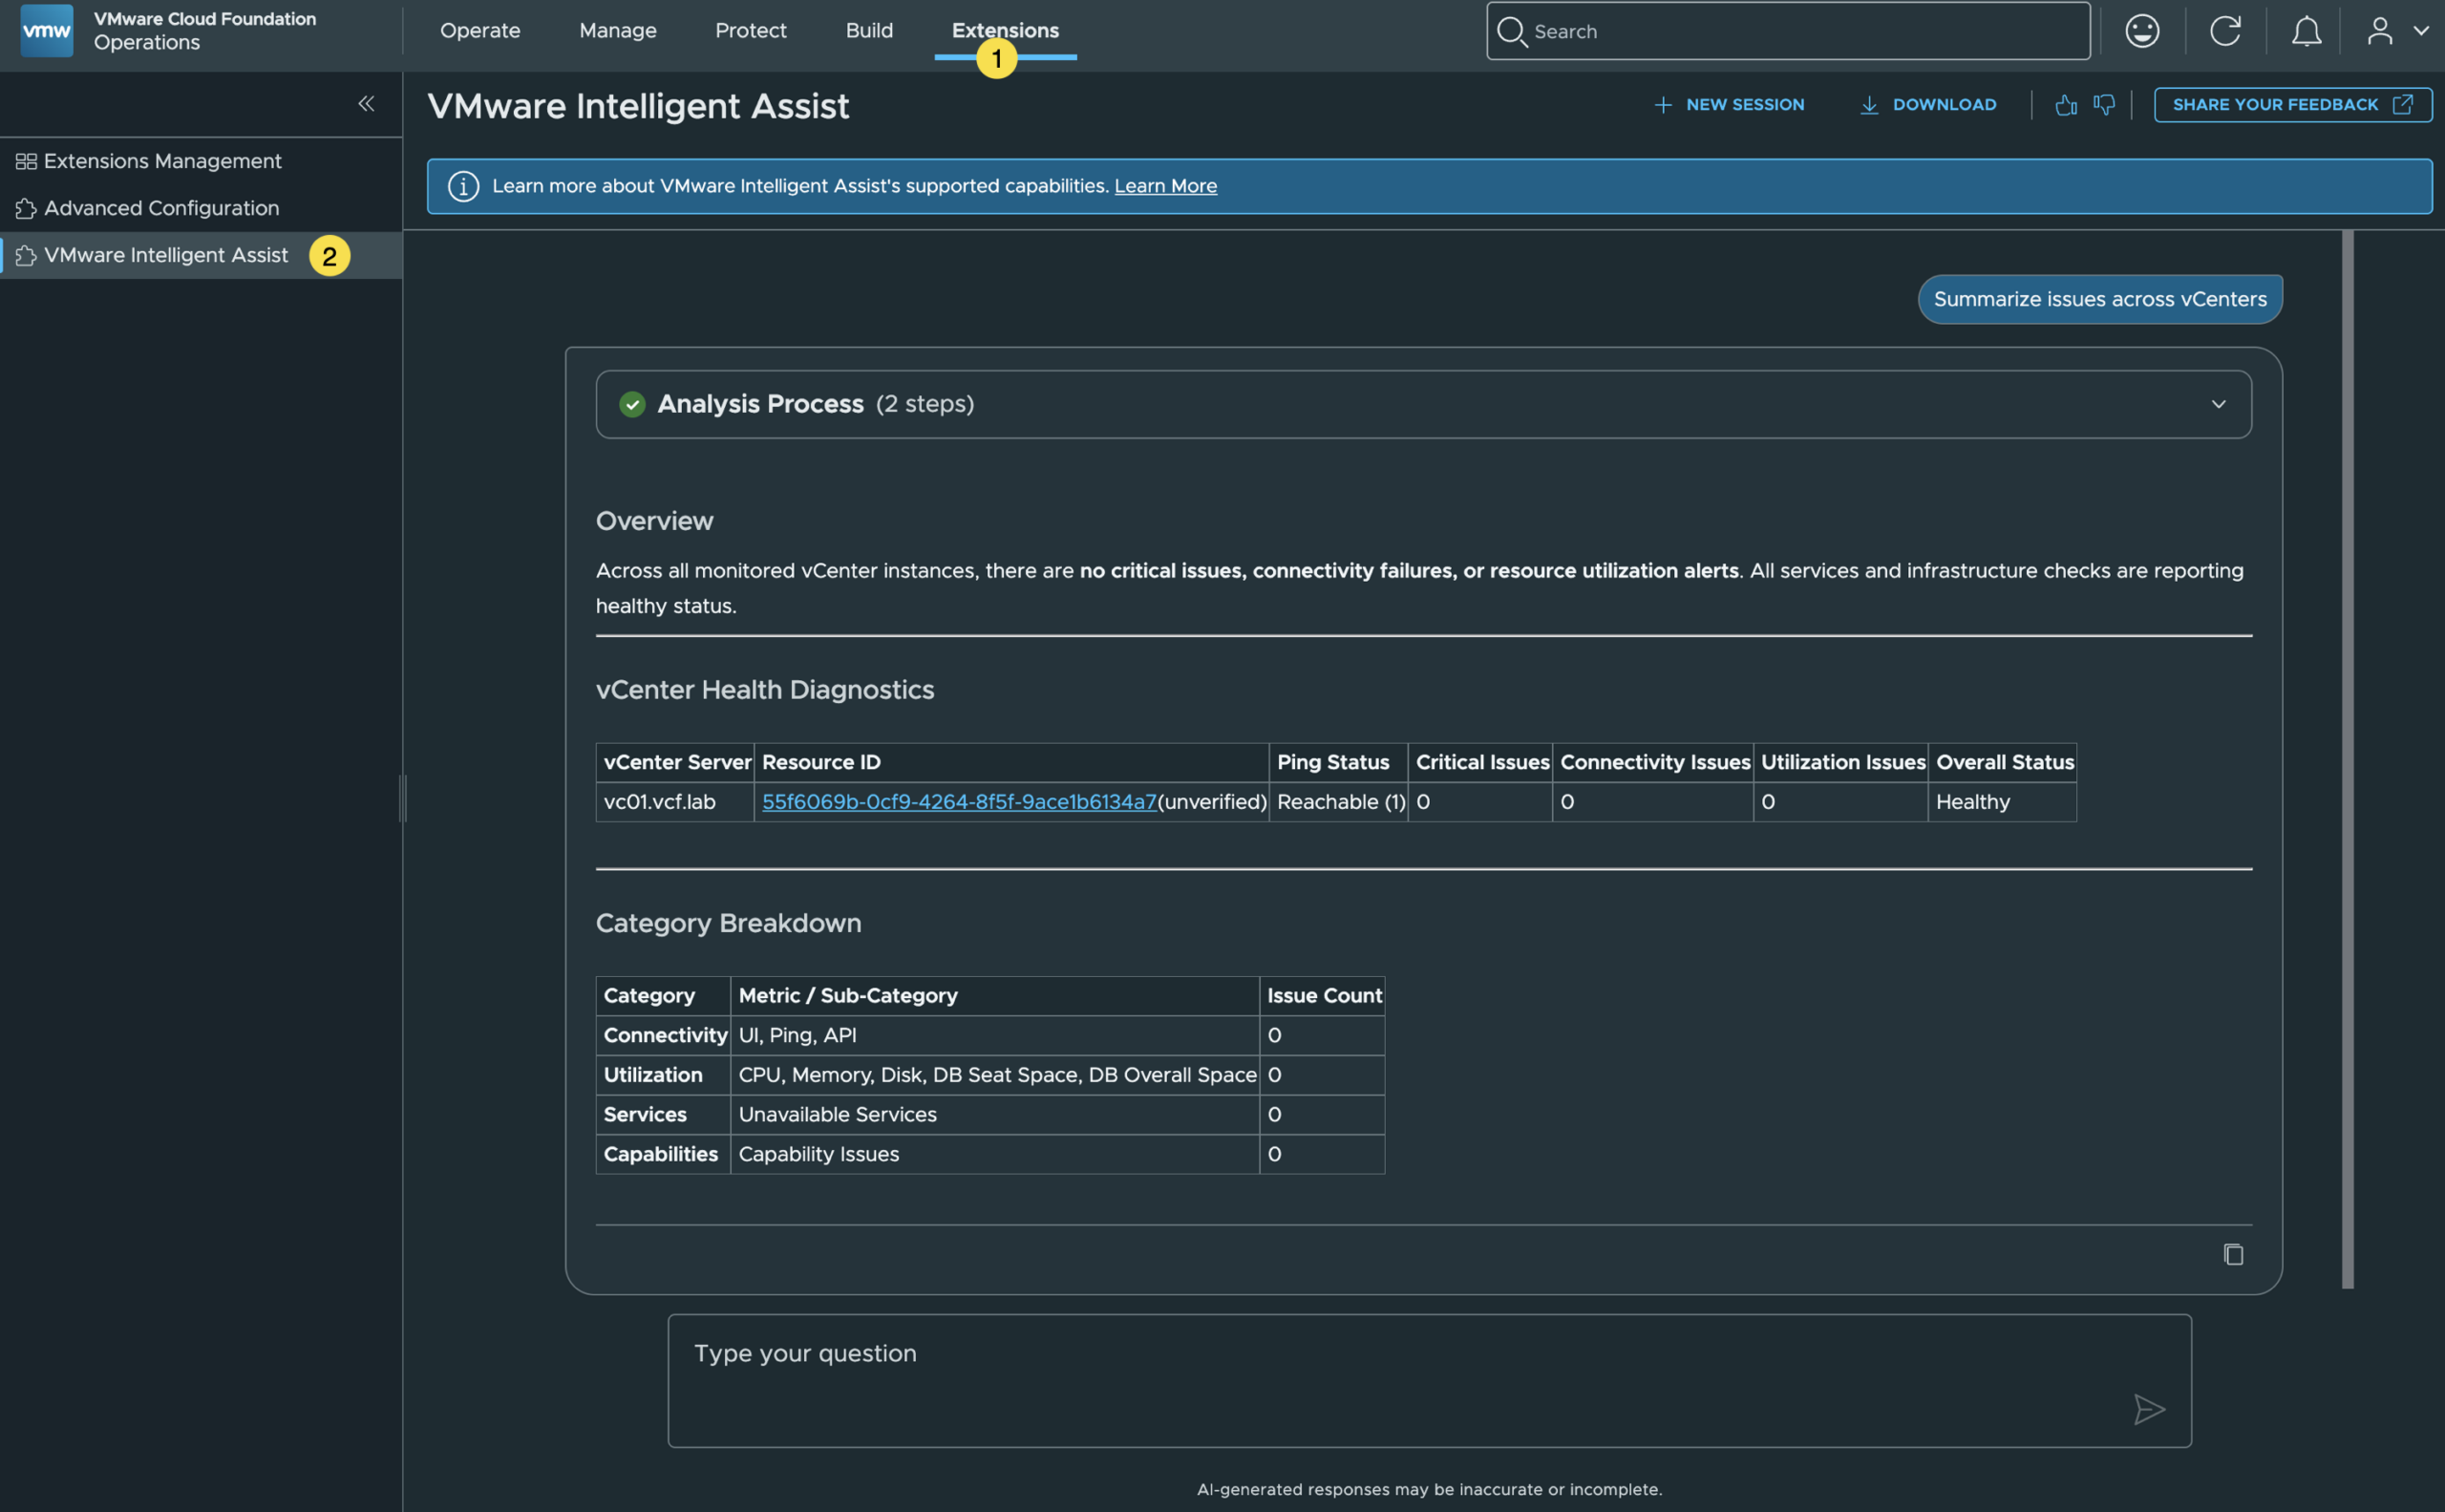
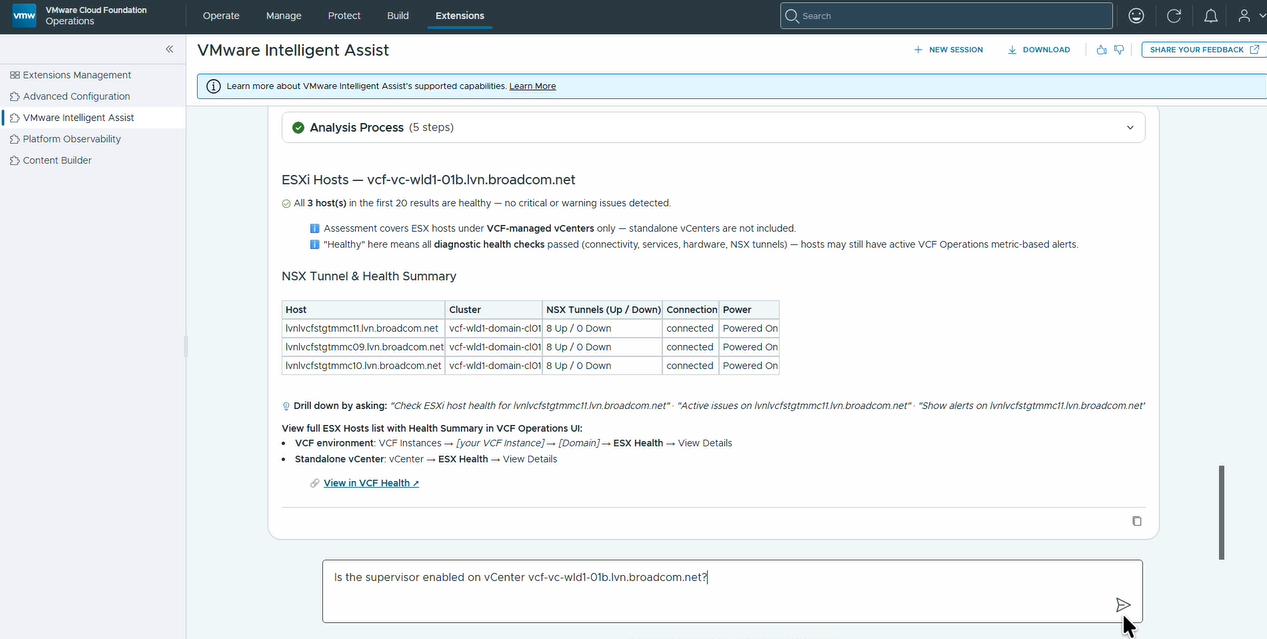
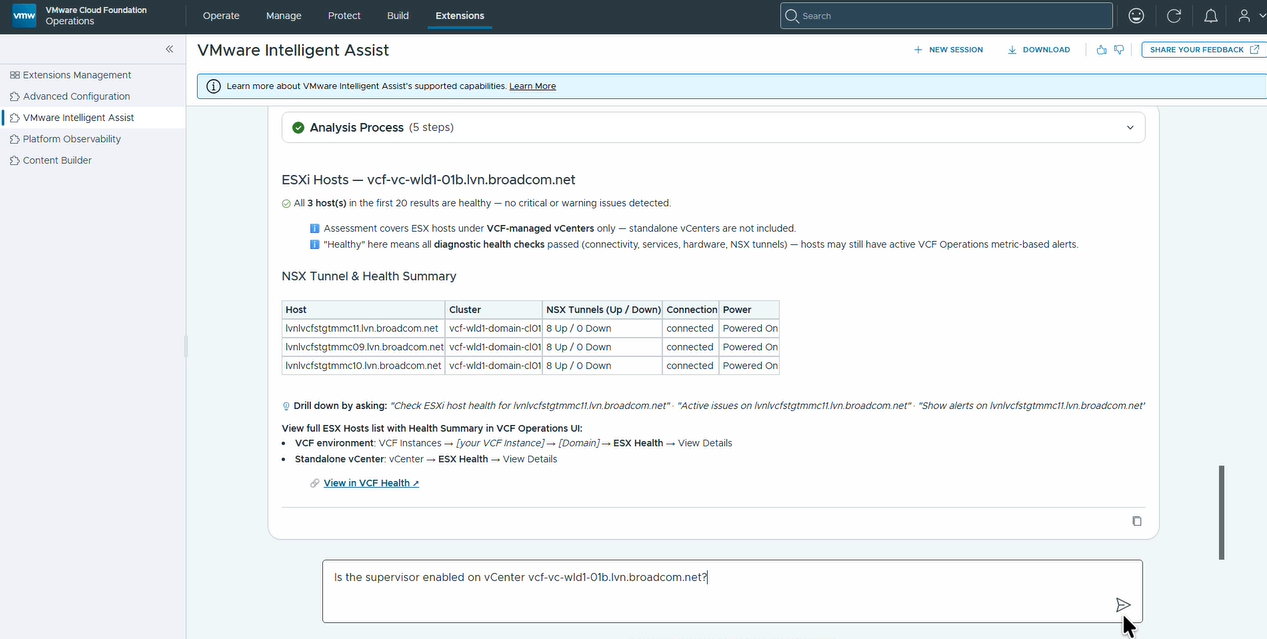
Перейдите в раздел Extensions > VMware Intelligent Assist и начните общаться со своей инфраструктурой VCF. Можно вывести список доступных навыков (skills) — они также отображаются в разделе Extensions > Advanced Configuration > Tools — или воспользоваться одним из готовых запросов, как в примере ниже, где формируется сводка по всем проблемам vCenter Server.
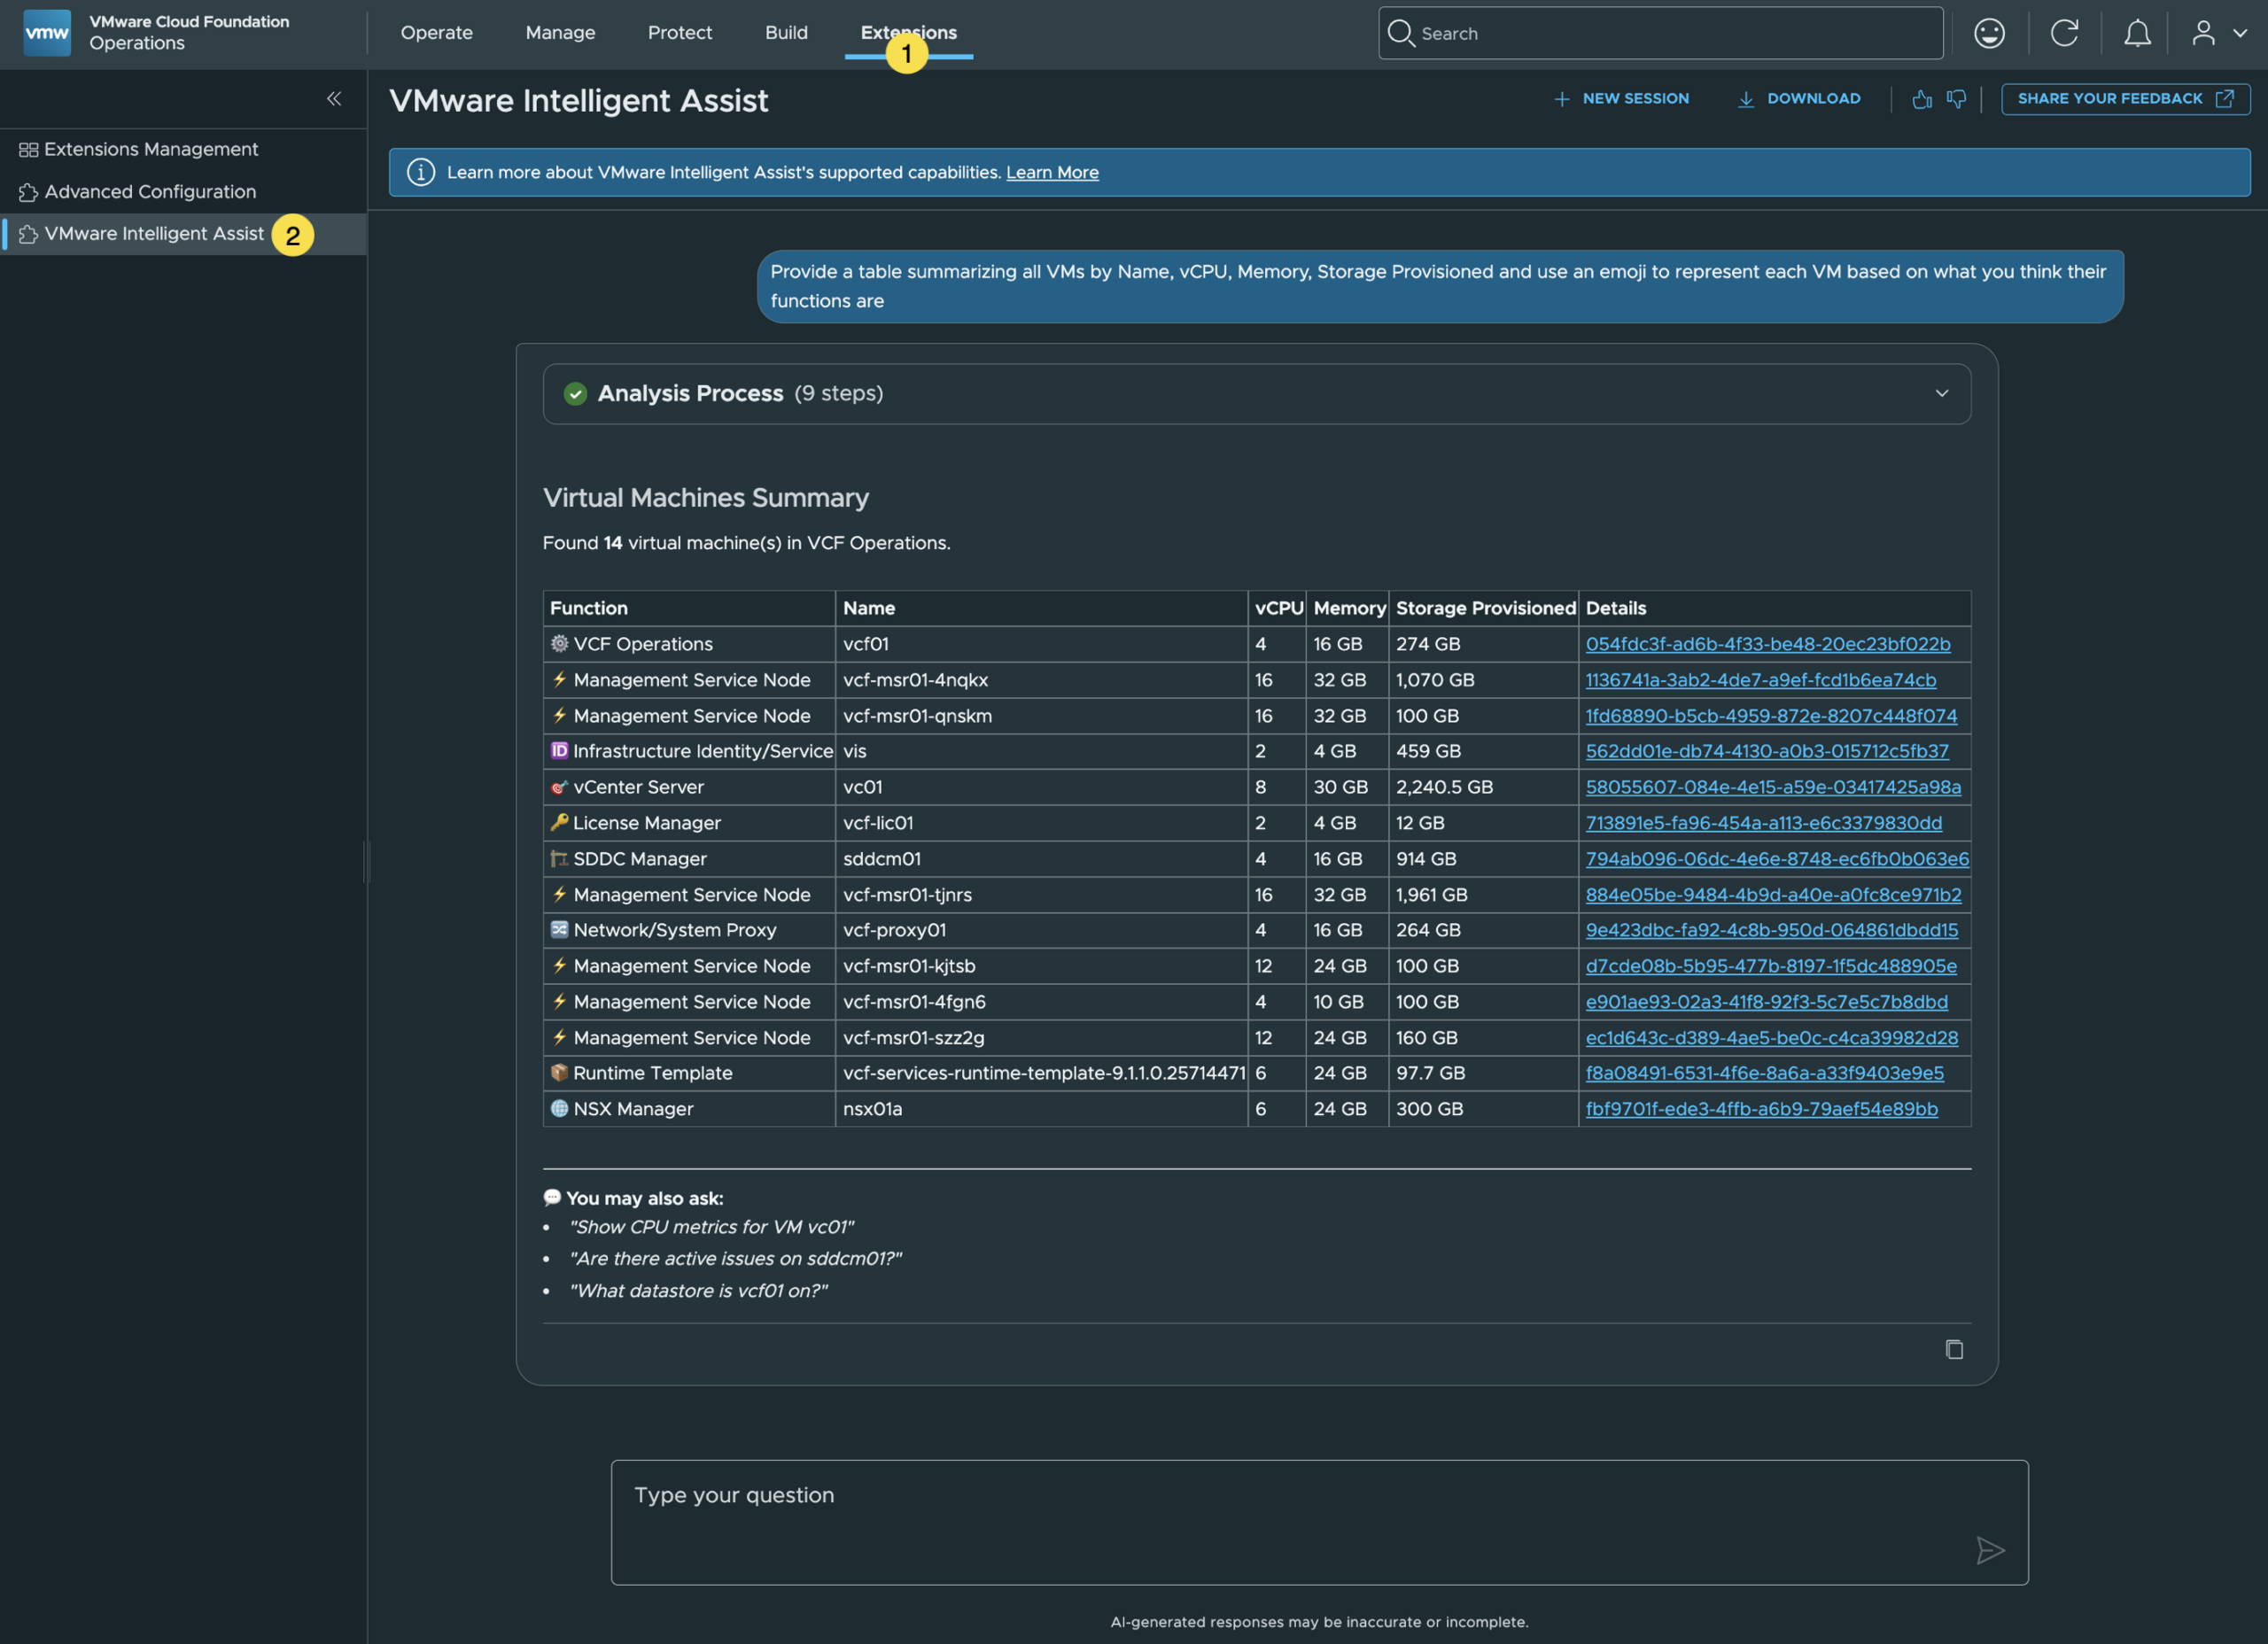
К составлению запросов можно подойти и более творчески — например, попросить сформировать таблицу со сводкой по всем ВМ с указанием имени, числа vCPU, объёма памяти и выделенного хранилища (Storage Provisioned), а заодно обозначить каждую ВМ эмодзи в зависимости от того, какую функцию она, по мнению ассистента, выполняет. Такой запрос выглядит следующим образом:
Provide a table summarizing all VMs by Name, vCPU, Memory, Storage Provisioned and use an emoji to represent each VM based on what you think their functions are
Как видно по результату, VMware Intelligent Assist не только представил ответ в запрошенном формате, но и добавил контекстные ссылки на каждый найденный ресурс в VCF Operations. Благодаря этому инструмент становится исключительно полезным для устранения неполадок, анализа проблем и формирования отчётов.
Примечание: пока сессия чата VMware Intelligent Assist не сохраняется. Если перейти в другое представление, а затем вернуться, история предыдущего диалога будет утеряна. Это замечание уже передано команде разработчиков, и есть надежда, что в одном из будущих обновлений пользователи смогут просматривать все прошлые чаты — так же, как это реализовано в других платформах для работы с AI-агентами.
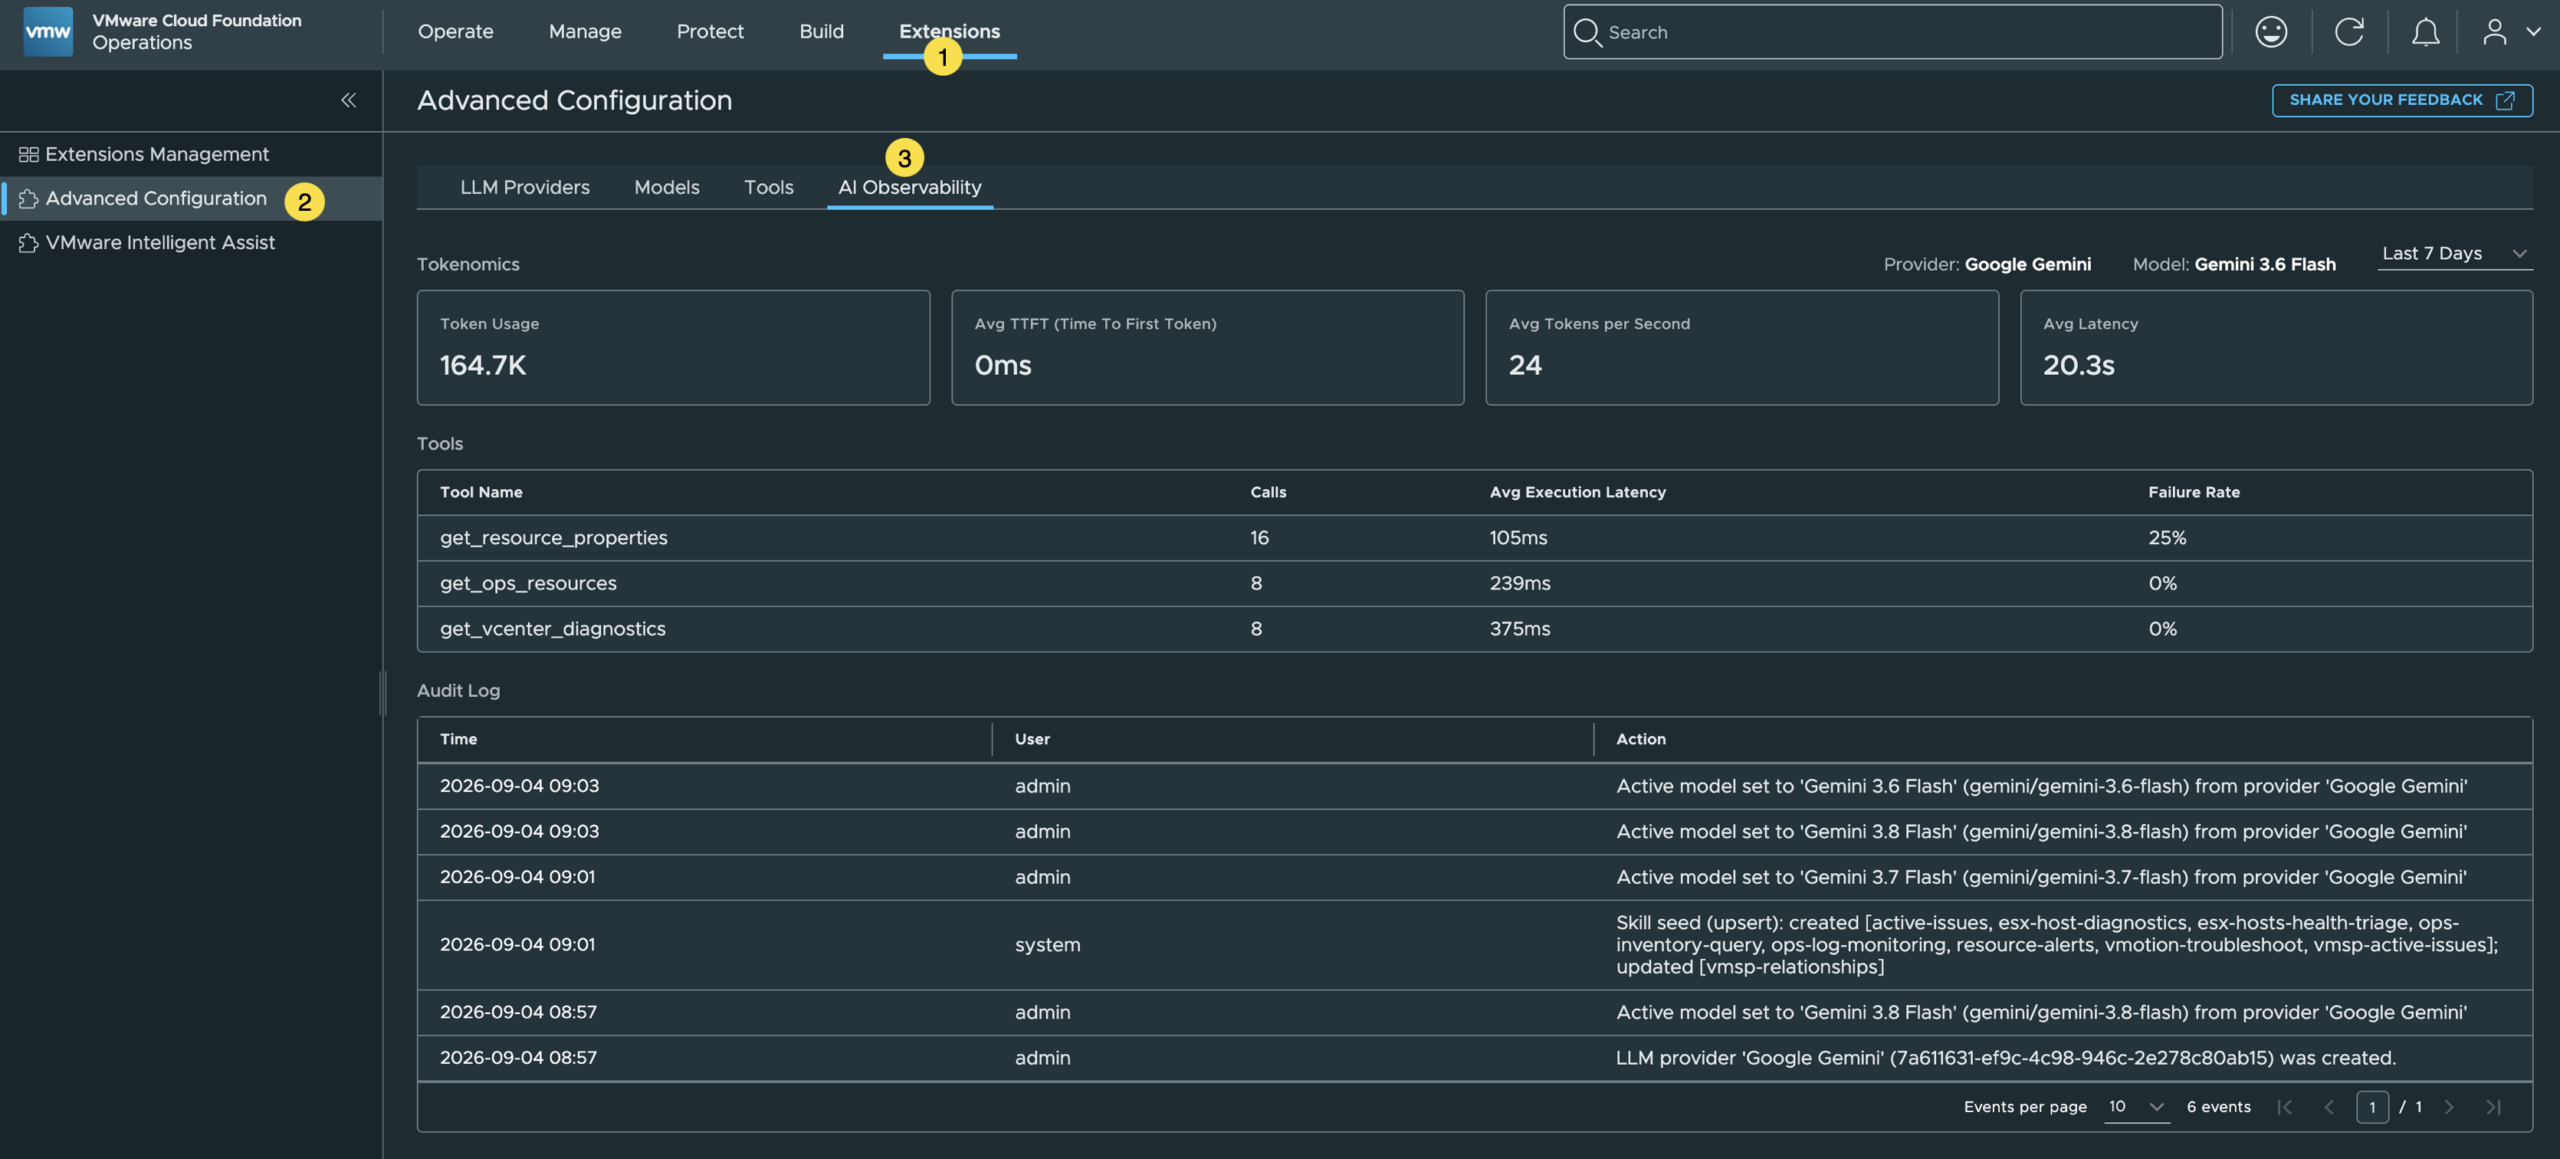
Кроме того, в разделе Extensions > Advanced Configuration > AI Observability можно посмотреть различную статистику использования моделей. Здесь доступны такие метрики, как расход токенов, среднее число токенов в секунду (TPS) и средняя задержка запросов, а также сведения о типах используемых навыков и журналы аудита сервиса.
Искусственный интеллект несёт в себе потенциал для преобразования бизнеса, однако его промышленное внедрение на предприятиях по-прежнему ограничено. Приватность, защита интеллектуальной собственности и соответствие нормативным требованиям представляют собой серьёзные экзистенциальные угрозы. Организациям приходится устанавливать детальные границы доступа и оберегать проприетарные данные. Стремительный переход к агентному AI многократно усиливает эти исходные точки трения, порождая критически важные проблемы эксплуатации, стоимости и управления. В отличие от традиционных моделей вывода с одиночным вызовом, автономные агенты работают в динамических циклах, что приводит к непредсказуемому нелинейному росту затрат на токены и перегружает унаследованную ИТ-инфраструктуру.
Новые вызовы эпохи агентного AI
В эпоху агентного AI перед предприятиями встают дополнительные задачи, которые необходимо решать.
Эксплуатационная сложность: агентные рабочие нагрузки ведут себя не так, как традиционные запросы на вывод. Агенты выстраивают цепочки из десятков вызовов моделей, обращений к инструментам и циклов рассуждений. Традиционная инфраструктура попросту не создавалась под такой устойчивый и динамичный характер спроса. К трудностям развёртывания относятся:
Развёртывание Day 0: вычислительные ресурсы, сети, хранилище, Kubernetes и сетевая инфраструктура.
Эксплуатация Day 2: управление жизненным циклом, включая установку исправлений, обновления, версионирование моделей и миграции между фреймворками, — всё это превращается из отдельных проектов в непрерывные, накладывающиеся друг на друга циклы.
Рост затрат на токены: AI-агенты работают в итеративных циклах, поэтому потребление токенов масштабируется нелинейно. Более того, по прогнозам, к 2030 году стоимость токенов вырастет вплоть до 24 раз. Раздувание контекста, обмен сообщениями между несколькими агентами, исправление ошибок и рефлексия, а также внутренние промпты «размышления» — всё это примеры причин непредсказуемого удорожания токенов. Облачные LLM тарифицируются по числу токенов, и их пользователи уже сталкивались с неожиданным ростом расходов.
Пробелы в управлении: инженерные команды создают приложения и разворачивают автономных агентов быстрее, чем за ними успевают процессы приватности, безопасности, управления и эксплуатации. В результате возникла разрозненная среда, в которой у руководителей может не быть централизованной картины того, какие модели, инструменты и агенты используются и каким именно образом. Инфраструктура обязана обеспечивать детальный контроль приватности, а также доступа к инфраструктуре и данным, ограничивая то, что каждый агент может читать и изменять, — даже если сама базовая модель считается доверенной.
VMware Private AI Cloud
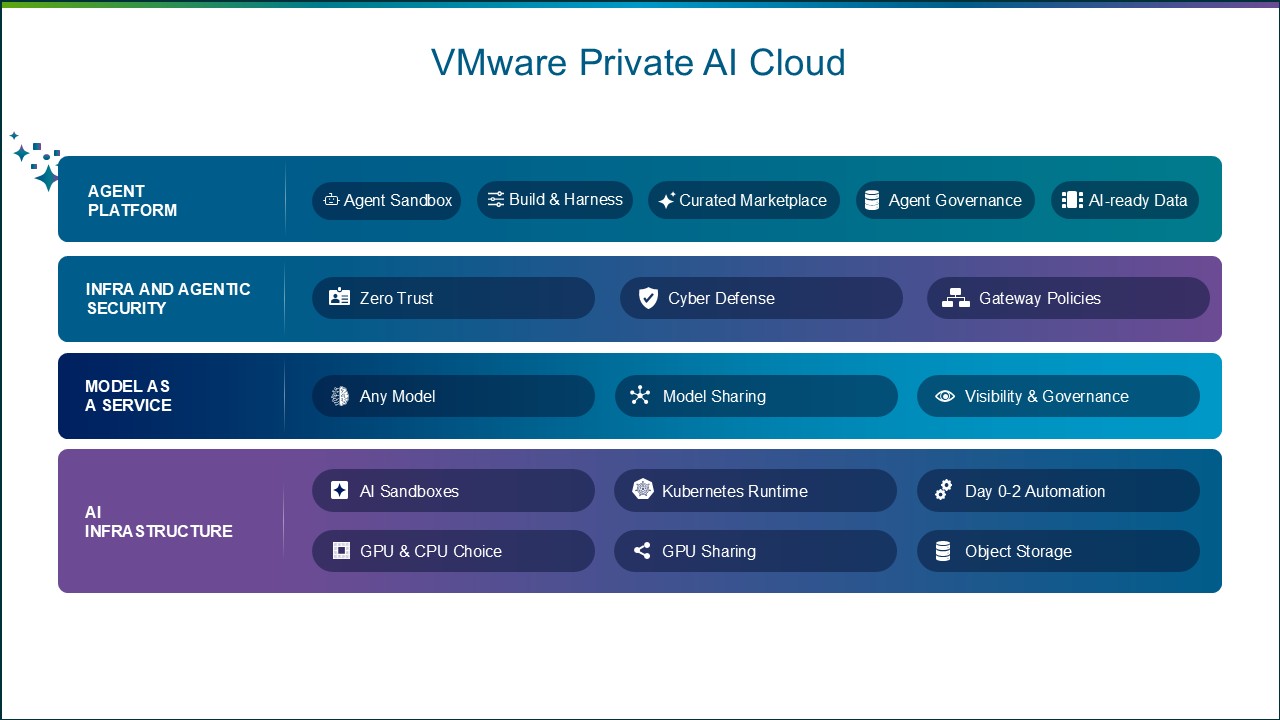
Для решения этих задач компания Broadcom представила VMware Private AI Cloud — решение, позволяющее предприятиям экономично масштабировать AI, работать более безопасно и быстро внедрять инновации. Построенный на передовых программных возможностях Broadcom, VMware Private AI Cloud даёт организациям готовый к промышленной эксплуатации путь к безопасной разработке, запуску и управлению нагрузками вывода, агентными приложениями и традиционными корпоративными нагрузками — совместно, на платформе VCF, с широким выбором оборудования, моделей и ускорителей.
Экономичное масштабирование AI: VMware Private AI Cloud охватывает три основных источника затрат на AI — капитальные вложения в оборудование, эксплуатационную сложность и экономику токенов (токеномику). VCF поддерживает графические процессоры, CPU и ускорители ведущих производителей, а также серверное оборудование крупных OEM- и ODM-поставщиков, что позволяет заказчикам экономично эксплуатировать гетерогенные кластеры. Для оптимизации токеномики и использования ресурсов предусмотрены мониторинг токенов, мультитенантное совместное использование моделей, расширенный учёт GPU/vGPU и панель наблюдаемости AI-метрик. Одна из ключевых инноваций VMware Private AI Cloud — VMware AI Factory, обеспечивающая быстрый путь от развёртывания на «голом железе» до запуска первой модели.
Более безопасная эксплуатация: платформа VCF построена по принципу эшелонированной защиты в соответствии с NIST CSF 2.0 и противостоит угрозам, усиленным средствами AI, за счёт минимизации поверхности атаки и обеспечения непрерывного соответствия требованиям. Автоматические обновления, не нарушающие работу сервисов, поддерживают системы в актуальном состоянии, а VMware vDefend применяет виртуальное патчирование и горизонтальную защиту на уровне гипервизора с микросегментацией, реализуя принцип Zero Trust и блокируя эксплойты. Кроме того, многоуровневая защита от угроз vDefend, а также межсетевой экран уровня веб-приложений и защита API в VMware Avi Load Balancer предотвращают сложные атаки.
Быстрые инновации для эпохи агентного AI: в отличие от традиционных приложений, автономные AI-агенты способны действовать бесконтрольно, выходить за рамки своих полномочий или неверно истолковывать инструкции. Соответственно, доверие к ним зависит от надёжных механизмов контроля и целостности данных. VMware Tanzu Platform в связке с VMware vDefend формирует основу для доверенных корпоративных агентов за счёт архитектуры с запретом по умолчанию, готовой обвязки (harness) и курируемого маркетплейса.
Ниже — подробности о VMware AI Factory, ключевой инновации в составе VMware Private AI Cloud.
VMware AI Factory: движущая сила VMware Private AI Cloud
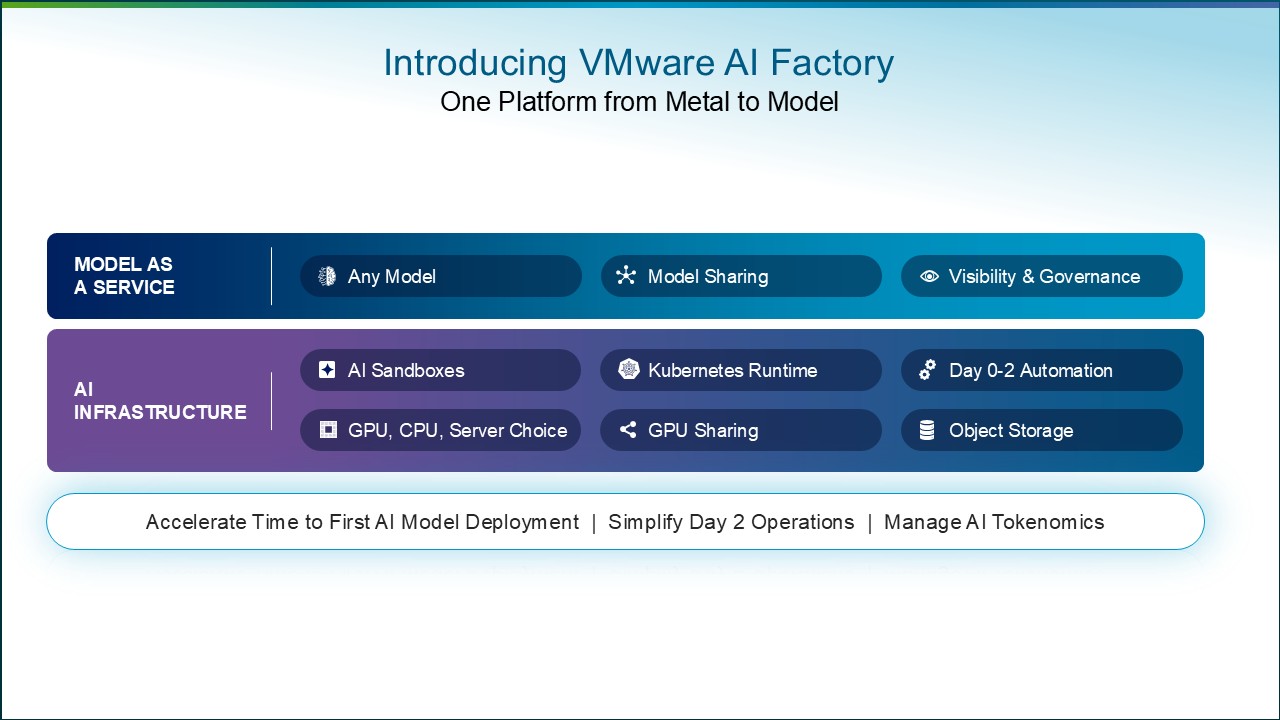
VMware AI Factory — это программно-определяемый фундамент VMware Private AI Cloud. Он даёт заказчикам упрощённый путь к промышленному AI благодаря новым средствам автоматизации развёртывания инфраструктуры, готовой к ИИ-нагрузкам, и поддержки операций Day 2. С VMware AI Factory заказчики могут быстрее выйти на развёртывание первой модели и эффективнее управлять токеномикой AI.
VMware AI Factory приближает AI-приложения непосредственно к корпоративным приватным данным внутри защищённой среды частного облака. Уникальные возможности автоматизации инфраструктуры в VCF позволяют сократить время от развёртывания сервера на «голом железе» до обслуживания первой AI-модели с недель до считанных часов. VMware AI Factory упрощает управление AI-инфраструктурой, полностью автоматизируя выделение оборудования, включение программного стека и сквозное управление жизненным циклом. Объединяя операции с оборудованием и программным обеспечением в единое автоматизированное решение, организации получают возможность быстро масштабировать AI-нагрузки при минимальной эксплуатационной сложности.
Партнёрства, обеспечивающие работу VMware AI Factory
VMware AI Factory сочетает VCF с сертифицированными серверами Dell PowerEdge и узлами VCF AI ReadyNodes от Cisco, Lenovo, Supermicro и других вендоров, а также с предпочитаемыми заказчиком программными средствами AI и архитектурами ускорителей.
Broadcom и AMD совместно работают над вариантом VMware AI Factory, объединяющим VCF с графическими процессорами AMD Instinct и открытой программной экосистемой AMD ROCm. Технология zero-touch provisioning будет оркестрировать сквозное развёртывание всего стека — от vSphere и vSAN до Kubernetes и оператора AMD GPU, — а драйвер AMD DVX сможет подключать графические процессоры к крупным виртуальным машинам, которые использует кластер VMware vSphere Kubernetes Service.
Для дальнейшего упрощения развёртывания VCF AI Factory Broadcom объявила о новом партнёрстве с MetalSoft, в рамках которого будет реализована интегрированная гетерогенная автоматизация работы с «голым железом» для VCF, сокращающая время подготовки физических серверов с недель до минут. Интеграция поможет ИТ-специалистам выделять или переразвёртывать физические серверы разных производителей напрямую через консоль управления VCF, объединяя жизненный цикл программного обеспечения и оборудования в единую операционную модель и снимая необходимость в специфичных для каждого вендора инструментах управления оборудованием и прошивками.
Новые возможности VMware AI Factory
Сервисы VCF Private AI Services помогают сделать AI управляемым, контролируемым и экономически эффективным и входят в состав VMware Cloud Foundation (VCF). Число сервисов, предлагаемых в рамках VCF Private AI Services, будет и дальше расширяться. Рассмотрим эти возможности подробнее.
Доступно в общем релизе
Мультитенантное совместное использование моделей
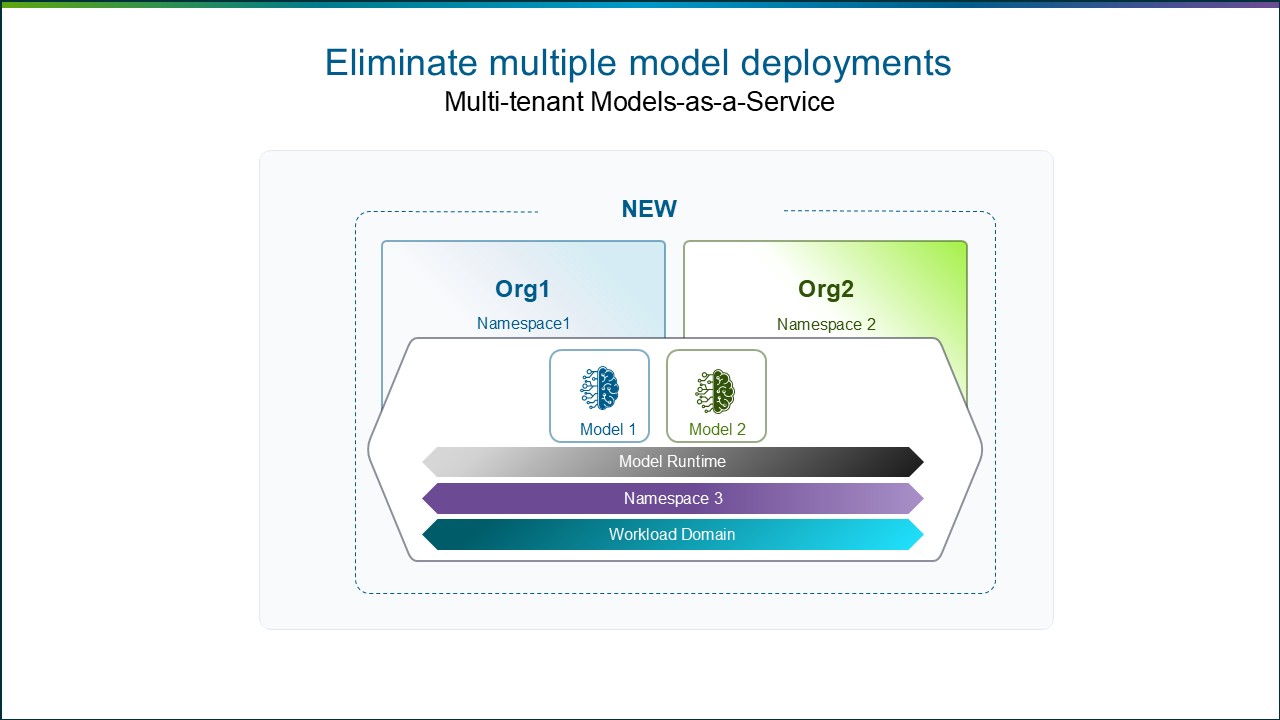
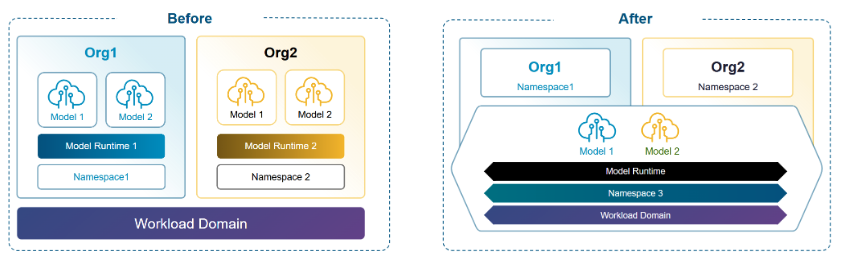
В релизе VCF 9.1.1 компонент Model Runtime был доработан так, чтобы обеспечить безопасное совместное использование AI-моделей между тенантами или отдельными направлениями бизнеса в их пространствах имён при полном сохранении приватности данных каждого из них. На практике это означает, что предприятия и облачные провайдеры теперь могут иметь один запущенный сервис Model Runtime, который обслуживает и масштабирует модели для всей организации, тогда как каждая команда или подразделение располагает отдельным приватным и защищённым пространством имён для своих данных. Эта возможность устраняет необходимость разворачивать избыточные копии модели, впустую расходуя выделенные GPU и инфраструктурные ресурсы. Одновременно сохраняются приватность и изоляция данных при оптимизации совокупной стоимости владения.
Возможности будущих релизов
AI Gateway
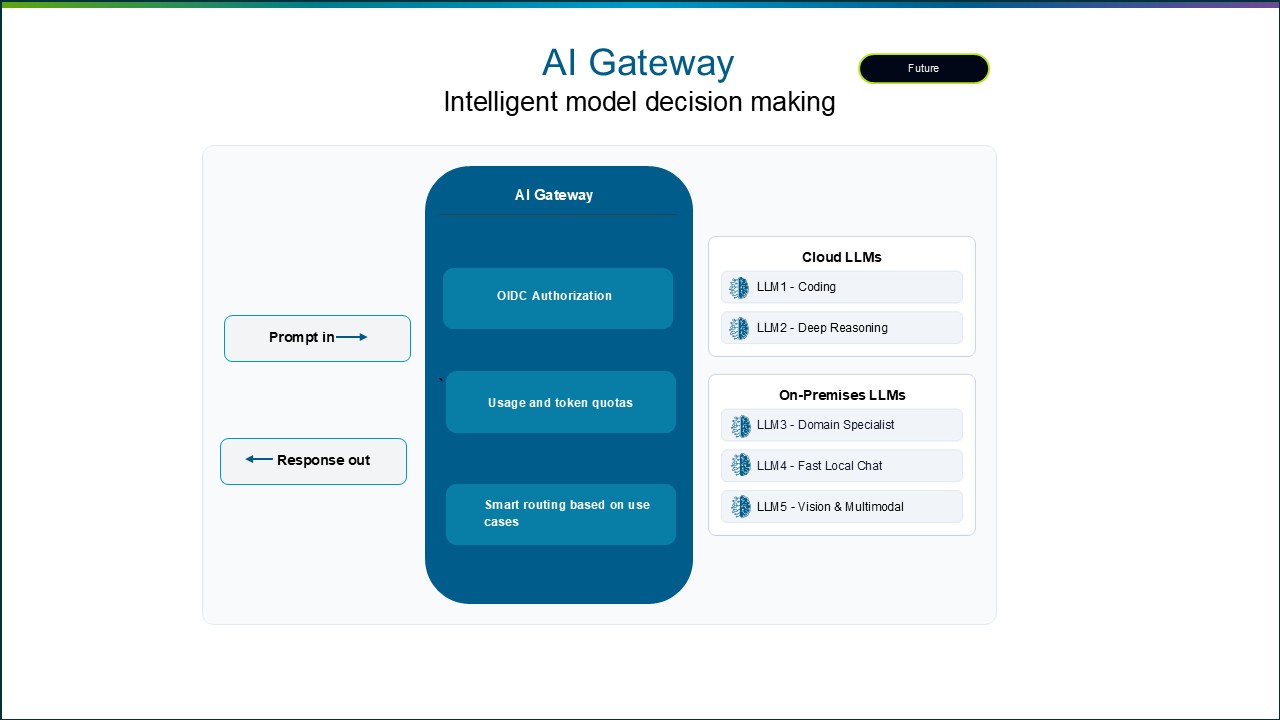
Чтобы сбалансировать сегодняшние потребности в оптимизации стоимости токенов, сценариях использования и производительности, предприятиям нужны модели, развёрнутые и в облаке, и локально. Облачные LLM могут потреблять большое количество токенов, поэтому управление ими приобретает первостепенное значение. Возможность AI Gateway существенно поможет в разрешении этих конкурирующих компромиссов. Вот конкретные детали:
Интеллектуальная маршрутизация промптов: динамически сопоставляет и распределяет входящие запросы между наиболее подходящими локальными или облачными моделями с учётом таких факторов, как сценарий использования, специализация в предметной области и стоимость токенов, — для оптимизации производительности.
Ограничение использования и токенов: ограничение потребления и числа токенов на уровне пользователя помогает минимизировать расход токенов.
Авторизация приложений: определяет приложение, отправившее запрос, до маршрутизации промпта. AI Gateway использует авторизацию на основе токенов OpenID Connect для применения политик доступа.
Secure Agent Framework
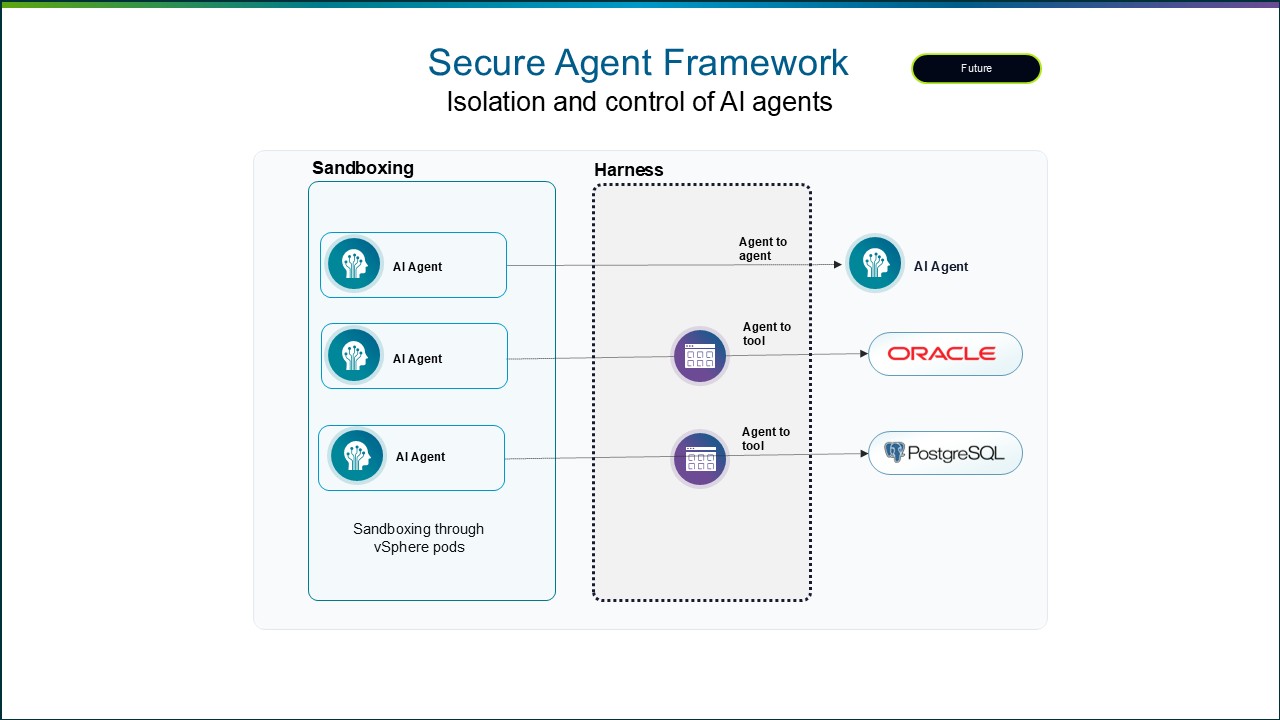
Автономные AI-агенты динамически генерируют и выполняют код, что без строгого контроля создаёт значительные риски безопасности. Бесконтрольный агент — не имеющий детерминированных ограничений на то, к чему он может обращаться, — способен случайно выполнить катастрофические команды, например удалить виртуальные машины или стереть локальные базы данных, как это продемонстрировали тестовые агенты нескольких облачных AI-провайдеров, вышедшие из-под контроля.
Будут выпущены две связанные возможности, обеспечивающие контроль и защитные механизмы для AI-агентов:
Sandboxing: создаёт защищённое виртуализированное контейнерное пространство, в котором динамически сгенерированный агентом код изолируется и исполняется без влияния на остальную среду.
Agent Harness: формирует уровень управления, определяющий, как вызываются агенты, к каким инструментам они имеют доступ, как они взаимодействуют друг с другом и как проверяются результаты их работы, прежде чем по ним будут предприняты действия.
Автоматическое масштабирование моделей
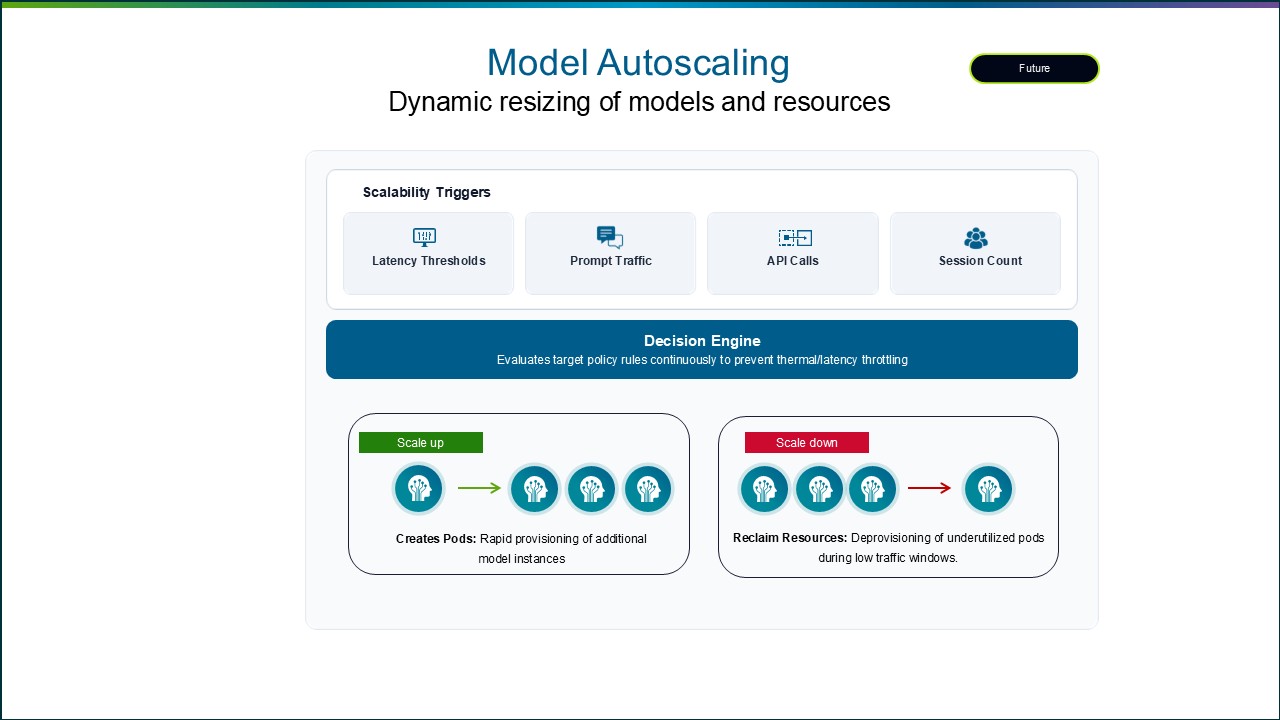
AI-нагрузки не умеют динамически реагировать на внезапные всплески запросов или агентные циклы. Для решения этой проблемы будет представлена возможность Model Autoscaling. С её помощью администратор или AI-оператор сможет задать пороговые значения по задержке и числу сессий, и при их достижении AI-модель будет масштабироваться автоматически, чтобы соблюдались SLA по задержке и производительности. Когда нагрузка опускается ниже порогового значения, рабочая нагрузка масштабируется в обратную сторону.
Благодаря этой возможности предприятия получат прирост производительности и снижение совокупной стоимости владения за счёт событийно-управляемого масштабирования, которое удерживает задержку по токенам на низком уровне, и смогут избежать избыточного выделения ресурсов GPU. Кроме того, организации смогут дополнительно оптимизировать вложения в AI за счёт более эффективного совместного использования дорогостоящих графических процессоров разными рабочими нагрузками.
Другие AI-новинки и анонсы с Explore
Поддержка Broadcom широкого спектра моделей в составе VCF
Стремительно развивающаяся область ИИ требует доступности разных моделей. Потребность в разнообразии AI-моделей вытекает из нескольких конкурирующих факторов: приватность, безопасность, управление, стоимость токенов, а также специализация и экспертиза в предметной области.
Broadcom намерена помогать предприятиям справляться с этими конкурирующими факторами, поддерживая как модели с открытыми весами, так и строго коммерческие решения. VMware AI Factory даёт предприятиям готовый к промышленной эксплуатации путь к запуску ведущих AI-моделей локально. Использование vLLM в качестве среды исполнения моделей по умолчанию позволяет заказчикам запускать на VCF более 150 моделей с открытым исходным кодом с оптимизацией по производительности. Broadcom объявила, что на работоспособность в VCF протестированы следующие модели:
Nemotron 3: семейство открытых мультимодальных моделей NVIDIA Nemotron 3 обеспечивает ведущую точность и эффективность, помогая агентам быстрее выполнять задачи. Сочетание гибридной архитектуры Mamba-Transformer MoE, контекстного окна в один миллион токенов и обучения с подкреплением в нескольких средах позволяет Nemotron 3 поддерживать масштабируемые длительные агентные рабочие процессы в корпоративных приложениях.
Gemma 4: новейшее семейство мультимодальных моделей Google DeepMind с открытым исходным кодом и открытыми весами, созданное специально для разработчиков и исследовательского сообщества, обеспечивающее локальное исполнение и позволяющее предприятиям создавать и разворачивать автономных AI-агентов.
cotomi: проприетарная AI-модель компании NEC, оптимизированная для японского языка и обученная на тщательно отобранных, высоконадёжных наборах данных. Она сочетает высокую скорость обработки с повышением эффективности использования токенов на 40%.
Qwen3.8-27B: разработанная Alibaba модель Qwen3.8-27B — плотная визуально-языковая модель с открытыми весами от команды Qwen. Она подходит для написания кода, профессиональных рабочих процессов, исследований, мультимодального взаимодействия и длительных агентных задач, а режим «размышления» в ней можно включать и отключать. Это нативно мультимодальная плотная модель на 27 млрд параметров, рассчитанная на эффективное локальное развёртывание и коммерческое использование.
GLM 5.2: General Language Model с открытым исходным кодом от Z.ai (ранее Zhipu AI) позволяет предприятиям локально разворачивать агентов для написания кода и рассуждений в многошаговых автономных сценариях с соблюдением суверенитета данных и оптимальной производительностью оборудования.
VCF получила сертификацию NVIDIA: производительность AI-нагрузок подтверждена на уровне, близком к «голому железу»
Недавно NVIDIA запустила программу NVIDIA-Certified Hypervisors. Она удостоверяет, что участвующие в ней гипервизоры обеспечивают для AI- и HPC-нагрузок производительность, близкую к «голому железу».
VMware vSphere 9.1 (и все будущие релизы vSphere 9) получили сертификат NVIDIA-Certified Hypervisor. Таким образом, ИИ- и HPC-нагрузки на VCF теперь официально сертифицированы на работу с производительностью, близкой к «голому железу». Эта сертификация позволяет заказчикам уверенно использовать VCF в качестве оптимизированной по производительности платформы частного облака с поддержкой со стороны основных партнёров экосистемы — для обеспечения работы AI-приложений и приложений ускоренных вычислений в корпоративных центрах обработки данных. Более подробно об этом рассказано в недавно опубликованной статье.
Новые партнёры экосистемы VCF Private AI Services
Работа по укреплению корпоративной экосистемы ИИ продолжается. Помимо развития базовых функций, VCF Private AI Services расширяет охват за счёт новых стратегических альянсов. К числу новых партнёров относятся:
Appian: Appian предоставляет AI-автоматизацию для критически важных задач, автоматизируя сложные процессы в крупных предприятиях и государственных структурах. Платформа Appian известна своей надёжностью и масштабируемостью, подкреплёнными более чем 25-летним опытом в области корпоративных операций. Документация по установке Appian на VCF доступна на этой странице.
ClearML: ClearML предоставляет уровень оркестрации AI, управляющий доступом к GPU, моделями и агентами в рамках VMware Cloud Foundation. Это повышает утилизацию графических процессоров и снижает стоимость выполнения AI-нагрузок, давая предприятиям встроенный путь к модели AI-as-a-Service. Подробнее о ClearML можно узнать здесь.
Eve Security: Eve обеспечивает управление, наблюдаемость и контроль времени исполнения, необходимые предприятиям для безопасного масштабирования AI-агентов. Её агент, встроенный в контур, автоматически проверяет высокорисковую или аномальную активность, обогащает решения контекстом из систем управления идентификацией, DLP и нижележащих систем, а при необходимости применяет средства контроля в реальном времени. Подробнее об Eve Security — здесь.
Solo.io: Solo.io создаёт агентную инфраструктуру с открытым исходным кодом для предприятий, эксплуатирующих AI в продуктивной среде. Среда исполнения kagent и плоскость данных agentgateway дают платформенным командам возможность разворачивать AI-агентов и контролировать каждый вызов модели, инструмента и обращение агента к агенту — на инфраструктуре, которой они владеют и управляют. Дополнительные сведения о сотрудничестве Solo.io и Broadcom приведены в этой статье.
TrueFoundry: TrueFoundry предоставляет AI Gateway корпоративного уровня, объединяющий LLM Gateway, MCP Gateway и Agent Gateway, что позволяет предприятиям подключать, наблюдать и контролировать агентные AI-приложения разных провайдеров из единой плоскости управления. Дополнительные подробности о TrueFoundry доступны здесь.
Недавно в Лас-Вегасе прошла конференция VMware Explore 2026 — со встречами с заказчиками и партнёрами, техническими сессиями и воркшопами. К мероприятию приурочен анонс общей доступности VMware Cloud Foundation (VCF) 9.1.1 — первого maintenance-релиза для ветки VCF 9.1.
Примечание: хотя для maintenance-релизов и экспресс-патчей (EP) жёсткая последовательность установки не задана, для релиза VCF 9.1.1 предусмотрено особое исключение — несколько компонентов необходимо обновлять в строго определённом порядке (соответствующие предварительные проверки уже встроены в релиз). В одном из будущих maintenance-релизов эти исключения будут сняты, но пока о них следует помнить.
Fleet LCM необходимо обновить до 9.1.1 прежде, чем обновлять до 9.1.1 остальные компоненты VCF.
VCFMS необходимо обновить до 9.1.1 прежде, чем обновлять до этой же версии Identity Broker и компонент Salt Master/RaaS.
VCF Automation (VCFA) необходимо обновить до 9.1.1 прежде, чем обновлять компонент VCD Migrator.
Как maintenance-релиз он включает все накопленные исправления ошибок и обновления безопасности из ранее вышедших экспресс-патчей (EP), а также улучшения стабильности платформы и доработки, упрощающие переход на VCF 9.1.
Улучшений в этом релизе много, но ниже разобраны десять, которые заслуживают отдельного внимания.
2. Поддержка актуальных версий компонентов VCF в VCF Download Tool (VCFDT)
Экспресс-патчи (EP) для компонентов VCF выходят всё чаще, и определить актуальные версии всех компонентов, необходимых для новой установки или обновления VCF, становится всё сложнее. VCF Download Tool (VCFDT) позволяет без труда узнать последнюю версию отдельного компонента, но с определением актуальных версий по всему программному стеку VCF всё обстояло не так просто.
В VCFDT 9.1.1 задачу упрощает новый флаг --latest: он автоматически отбирает необходимые компоненты VCF в их последних версиях с экспресс-патчами — как для сценария установки, так и для сценария обновления.
Команда для вывода списка последних бинарных файлов VCF 9.1.0, необходимых только для первоначальной установки:
vcf-download-tool binaries list --depot-download-token-file=/Users/lamw/vcf_download_token.txt --vcf-version=9.1.0 --sku=VCF --type=INSTALL --automated-install --latest
Команда для загрузки последних бинарных файлов VCF 9.1.0, необходимых только для первоначальной установки:
3. Поддержка OCI-артефактов, а также образов vSphere Supervisor, VKS и VKR в VCF Download Tool
Унифицированный VCF Software Depot представляет собой единый репозиторий, в котором хранятся все бинарные файлы, используемые развёртыванием VCF, — OVA, ZIP-архивы, PAK-файлы и артефакты в формате OCI. VCFDT остаётся основным инструментом взаимодействия с онлайновым VCF Software Depot: с его помощью загружают содержимое и создают офлайновый VCF Software Depot. Однако одно ограничение сохранялось — инструмент не умел работать с артефактами в формате OCI, включая vSphere Kubernetes Releases (VKR).
В VCF 9.1.1 в VCFDT появилась новая команда artifacts, которая упрощает загрузку сервисов vSphere Supervisor, включая vSphere Kubernetes Service (VKS), и, что особенно важно, релизов vSphere Kubernetes Releases (VKR). Новая команда позволяет выбрать, какие именно VKR нужно загрузить. Раньше подписка на онлайновую библиотеку контента VKR делала доступными для развёртывания сразу все релизы VKR, и у операторов платформы не было простого способа контролировать, какие из них используются.
В составе подкоманды artifacts появился также фильтр по категориям, который позволяет быстро отобрать конкретный тип бинарных файлов для просмотра или загрузки:
SUPERVISOR — обновления управляющего уровня vSphere Supervisor
4. Уменьшенный ресурсный след VCF Management Services (VCFMS)
Когда в VCF 9.1.0 появился компонент VCF Management Services (VCFMS), размеры его виртуальных машин подбирались с расчётом на самый крупный из опциональных сервисов Day-N. Это снижало вероятность того, что при включении дополнительных сервисов потребуется переход на более крупную конфигурацию ВМ. Но в средах, где такие опциональные сервисы Day-N не разворачивались, часть виртуальных машин VCFMS оказывалась больше, чем необходимо.
В VCF 9.1.1 размеры VCFMS оптимизированы под первоначальное развёртывание Day-0. Кроме того, отдельные компоненты VCFMS были дополнительно перенастроены так, чтобы каждый сервис резервировал только те ресурсы, которые ему действительно требуются, — это повышает общую эффективность использования ресурсов. Например, при развёртывании Simple (без высокой доступности) теперь будет на один рабочий узел VCFMS меньше (12 vCPU / 24 ГБ памяти).
У тех, кто обновляет существующее развёртывание VCF 9.1 до версии 9.1.1, текущие размеры VCFMS останутся без изменений. При этом воспользоваться уменьшенным футпринтом VCFMS всё же можно — запустив после обновления скрипт перенастройки размеров, когда все компоненты VCFMS будут обновлены до 9.1.1.
5. Поддержка развёртывания Small HA для VCF Management Services (VCFMS) в VCF Installer
В VCF 9.1.0 конфигурация Small для VCFMS поддерживалась, но была доступна только в модели развёртывания Simple (без высокой доступности). В результате тем, кому требовалась высокая доступность управляющих узлов VCFMS, приходилось разворачивать следующий по размеру вариант VCFMS, обменивая дополнительное потребление ресурсов на повышенную доступность.
В VCF 9.1.1 для VCF Management Services (VCFMS) появился новый вариант развёртывания Small HA: высокой доступности можно добиться, не выходя за пределы ресурсов самой компактной конфигурации.
Если эта возможность используется через JSON API VCF Installer, в качестве значения размера развёртывания в секции vspClusterSpec, описывающей конфигурацию VCF Management Services (VCFMS), указывается small_ha.
Если VCF Fleet развёрнут в варианте Small без высокой доступности, масштабировать его до Small HA можно как операцию Day-N — через интерфейс VCF Operations в разделе Build > Lifecycle > VCF Management > Components > VCF Services Runtime, выбрав Action > Scale.
6. Поддержка HTTP и произвольного URL для офлайнового депо в интерфейсе VCF Installer
Возможность настроить офлайновый депозиторий VCF через HTTP-эндпоинт, включая поддержку произвольного пути в URL, появилась в API VCF Installer ещё в VMware Cloud Foundation (VCF) 9.1.0. Начиная с VCF 9.1.1 то же самое доступно непосредственно в интерфейсе VCF Installer: средам, которым не нужен HTTPS и/или которые используют собственный URL офлайнового депо, больше не требуется обращаться к API VCF Installer.
7. Поддержка дисков вне HCL vSAN ESA в интерфейсе VCF Installer
В лабораторных и пилотных развёртываниях доступ к NVMe-накопителям, сертифицированным для vSAN ESA, есть далеко не всегда. По умолчанию VCF Installer допускает использование с vSAN ESA только сертифицированных NVMe-устройств. Раньше это поведение можно было переопределить, добавив соответствующую настройку в VCF Installer. Начиная с VCF 9.1.1 поддержка несертифицированных NVMe-устройств с vSAN ESA встроена непосредственно в VCF Installer, и ручная настройка больше не нужна.
Важно: в продуктивных средах VVF и VCF с vSAN ESA поддерживаются только NVMe-устройства, перечисленные в Broadcom Compatibility Guide (BCG).
Для использования этой возможности через JSON API VCF Installer в секцию vsanSpec добавлено новое свойство skipHclAutoDiskClaim. Установка его в true включает то же поведение, что и в интерфейсе VCF Installer.
8. Поддержка развёртывания на одном хосте ESX в интерфейсе VCF Installer
В лабораторных и пилотных средах с ограниченными аппаратными ресурсами выполнить минимальные требования к количеству хостов ESX удаётся не всегда. Хотя обходной путь через переопределение настройки доступен ещё с VCF 5.x, интерфейс VCF Installer всё равно требовал соблюдения минимального числа хостов и блокировал развёртывание даже при заданном переопределении. В результате развёртывание приходилось выполнять через Cloud Builder или JSON API VCF Installer.
Начиная с VCF 9.1.1 интерфейс VCF Installer учитывает такое переопределение, и подобные развёртывания можно выполнять прямо из UI. Для тех, кто только начинает знакомиться с VCF в лабораторных и пилотных средах, это заметно упрощает работу.
9. Поддержка дисков вне HCL vSAN ESA в процедуре ввода хостов в эксплуатацию
При добавлении нового домена рабочей нагрузки VCF или расширении существующего, если в нём используется vSAN ESA, для ввода в эксплуатацию хостов ESX с несертифицированными NVMe-устройствами раньше требовалось дополнительное переопределение настроек. Продолжая линию на упрощение работы, заданную в VCF 9.1.1, ввод хостов ESX в эксплуатацию теперь выполняется прямо из интерфейса vCenter Server или SDDC Manager без этого дополнительного переопределения.
Прежде чем добавлять введённый в эксплуатацию хост ESX с несертифицированными NVMe-устройствами в кластер vSAN ESA, необходимо убедиться, что функция vSAN Managed Disk Claim отключена. По умолчанию она автоматически захватывает сертифицированные NVMe-устройства для использования с vSAN ESA. Несертифицированные устройства требуют ручной обработки, поэтому в противном случае операция будет заблокирована.
Важно: в продуктивных средах VVF и VCF с vSAN ESA поддерживаются только NVMe-устройства, перечисленные в Broadcom Compatibility Guide (BCG).
10. Поддержка VPC на базе VLAN без Overlay Tunnel Endpoint (TEP)
С появлением Distributed Transit Gateway (DTGW) для начала работы с Virtual Private Cloud (VPC) достаточно распределённой группы портов (DVPG) на базе VLAN, однако дополнительно всё равно приходилось настраивать overlay-сеть для Tunnel Endpoint (TEP) между хостами ESX. В VCF 9.1.1 у DTGW появился ещё один вариант — на базе VLAN и без необходимости настраивать сеть TEP на каждом хосте ESX, что сокращает объём конфигурации, требуемой для начала работы с VPC.
Примечание: новый вариант развёртывания VPC на базе VLAN полностью совместим с vSphere Kubernetes Service (VKS) и VCF Automation (VCFA), но имеет ряд ограничений. В их числе — отсутствие приватных подсетей VPC, сервисов SNAT/DNAT/VPN и поддержки протоколов, отличных от IP (например, VRRP и Multicast).
С выпуском VMware Cloud Foundation (VCF) 9.1.1 стали доступны новые возможности по эксплуатации инфраструктуры. За счёт расширения средств наблюдаемости, появившейся опции настроить диалогового AI-ассистента в помощь повседневным рабочим процессам, а также усиления безопасности VCF 9.1.1 помогает ИТ-командам быстрее устранять неполадки и масштабировать инфраструктуру.
По мере роста инфраструктуры частного облака перед командами эксплуатации встаёт сразу несколько препятствий: управление смешанными средами из виртуальных машин (VM), контейнеров и Kubernetes, поддержание безопасности в масштабах всего парка систем и удержание среднего времени устранения инцидента (MTTR) на низком уровне. Компонент VMware Cloud Foundation Operations в составе VCF 9.1.1 предоставляет операции с использованием искусственного интеллекта, сквозную наблюдаемость Kubernetes на всех уровнях стека и расширенные средства обеспечения безопасности. Ниже приведены подробности о новых возможностях, доступных в VCF Operations в релизе VCF 9.1.1.
AI Assistant for VCF
Рисунок 1. Функция AI Assistant for VCF упрощает операции Day-2 за счёт диалогового поиска неисправностей и диагностики.
В VCF 9.1.1 появилась функция, которая даёт возможность встроить диалоговый AI-интерфейс непосредственно в пользовательский интерфейс VCF Operations, настроив его локально с выбранной моделью. Эта функция изначально поддерживает различные большие языковые модели (LLM), работающие на Private AI Services (PAIS), либо частный экземпляр Google Gemini. Требуется ли администратору помощь в поиске причин проблем инфраструктуры или в управлении сторонними интеграциями — функция AI Assistant for VCF способна содержательно и безопасно помогать в эксплуатации частного облака.
Диалоговая диагностика. Функция AI Assistant for VCF даёт администраторам любого уровня подготовки возможность управлять средами частного облака с помощью простых запросов на английском языке.
Интеллектуальная видимость состояния. Функция AI Assistant for VCF также может помочь администратору в устранении проблем с работоспособностью VCF. Новые возможности обеспечивают диагностическую видимость для VMware vSphere и служб управления VCF. Администраторы могут сопоставлять проактивные оповещения о состоянии, конфигурацию и журналы.
Конструктор пакетов управления. Администраторы, использующие функцию AI Assistant for VCF, могут повысить видимость сторонней инфраструктуры, чтобы быстрее находить первопричины сбоев. Возросшая видимость помогает выстраивать связи между VCF и смежными валидированными средами и тем самым снижать взаимные обвинения между поставщиками при возникновении проблем. Кроме того, администраторы могут создавать пакеты управления с помощью искусственного интеллекта, не обладая экспертизой в области API.
Больше подробностей содержится в записи следующей сессии VMware Explore 2026:
Рисунок 2. VCF Operations обеспечивает наблюдаемость VKS и поиск неисправностей в реальном времени.
Поскольку контейнеры быстро масштабируются и так же быстро завершают работу, традиционный опрос инфраструктуры оставляет слепые зоны. VCF 9.1.1 обеспечивает выполнение операций Kubernetes в реальном времени в рамках управления инфраструктурой.
Наблюдаемость VMware vSphere Kubernetes Service (VKS). Администраторы могут сопоставлять метрики вычислительных ресурсов, сети и хранилища, получаемые в реальном времени, с системными журналами и событиями, чтобы быстро изолировать первопричины. Стандартные пятиминутные интервалы опроса теперь можно сократить до секунд. В VCF Operations появилась потоковая передача метрик в реальном времени с интервалом 2 секунды для кластеров VKS. Используя стандарт OpenTelemetry, команды могут оперативно обнаруживать короткоживущие поды, всплески потребления памяти и кратковременные узкие места производительности.
Мониторинг нескольких кластеров VKS. Администраторы получают централизованную видимость всех кластеров Kubernetes благодаря автоматизированному сбору данных OpenTelemetry без написания кода.
Импорт дашбордов Grafana. Администраторы могут беспрепятственно импортировать существующие дашборды Grafana или дашборды из библиотеки сообщества Grafana, чтобы отслеживать рабочие нагрузки Kubernetes из VCF Operations и одновременно просматривать нативные дашборды VKS.
Больше подробностей содержится в записи следующей сессии VMware Explore 2026.
Расширенные средства безопасности и управления идентификацией
Управление доступом, учётными данными и соответствием требованиям в больших масштабах требует бесшовного централизованного контроля.
Динамическое управление идентификацией по запросу. При настройке единого входа (SSO) для доступа к различным компонентам VCF необходимость в предварительно созданных учётных записях пользователей осталась в прошлом. VCF 9.1.1 поддерживает запросы к Active Directory и OpenLDAP (Lightweight Directory Access Protocol) в реальном времени. Членство пользователя в группах вычисляется динамически ровно в момент входа в систему, что упрощает выдачу временного группового доступа и обеспечивает соответствие прав текущему состоянию каталога.
Упрощённое управление паролями. VCF Operations выступает единой точкой для управления парольными политиками и их применения в рамках всего парка систем. Применять парольные политики стало проще, поскольку в рабочем процессе доступно больше компонентов. Администраторы могут отслеживать актуальность учётных данных по компонентам, включая теперь и учётные записи приложений для VMware vCenter, VMware Cloud Foundation Automation, средств управления парком VMware Cloud Foundation Operations и коллекторов VMware Cloud Foundation Operations for Networks.
Расширенное управление сертификатами. Управление жизненным циклом сертификатов теперь охватывает NSX Edges, супервизоры VMware vSphere, серверы лицензирования, cloud proxy для VCF Operations и коллекторы VCF Operations for Networks. Система обеспечивает непрерывное отслеживание сроков истечения, автоматические оповещения о сбоях автоматического обновления и интеграцию со сторонними удостоверяющими центрами (CA). Также реализована поддержка сертификатов, не относящихся к TLS. Эта возможность даёт расширенную видимость компонентов VCF и помогает свести к минимуму перебои во взаимодействии настроенных компонентов при истечении срока действия сторонних сертификатов. С помощью VCF Operations администраторы могут заменять самоподписанные сертификаты на сертификаты, выпущенные удостоверяющим центром.
VMware Salt for VCF Component APIs. Новые для VCF интерфейсы VMware Salt for VCF Component APIs построены на базе VMware Salt и дают командам всесторонний программный контроль над управлением конфигурациями. Опираясь на нативные конструкции Salt, эта новая возможность задействует целый ряд встроенных параметров конфигурации, которые единообразно работают во всём VCF. Более 300 доступных настроек позволяют администраторам поддерживать согласованное операционное состояние всего стека.
Больше подробностей содержится в записи следующей сессии VMware Explore 2026:
Компактный форм-фактор. Для организаций, которым нужно развернуть частное облако меньшего размера, в VCF 9.1.1 предложен новый компактный форм-фактор, сокращающий требования к процессорным ресурсам и памяти до 40%. Он включает конфигурацию из двух узлов для обеспечения высокой доступности. Кроме того, такая упрощённая архитектура позволяет импортировать в VCF существующие экземпляры VMware vCenter из brownfield-сред без перенастройки сетевых портгрупп.
Поддержка IPv6 на сервере лицензирования. Развёртывание современного частного облака можно ускорить благодаря нативной поддержке IPv6 в сервере лицензирования. В этот релиз также вошли дашборды состояния лицензирования и оповещения о лицензировании в VCF Operations.
Больше подробностей содержится в записи следующей сессии VMware Explore 2026:
Компонент VCF Operations в составе VCF 9.1.1 приносит наблюдаемость Kubernetes на базе OpenTelemetry, управление идентификацией в масштабах всего парка систем и автоматизацию работы с сертификатами. Встроенный AI-ассистент помогает эффективно строить, обслуживать, эксплуатировать и защищать частное облако, а гибкая интеграция с LLM сохраняет суверенитет данных. Полное описание новых возможностей VCF Operations приведено в документации Broadcom и заметках о выпуске.
Разработчик отечественной observability-платформы Proto перешёл под контроль «Базиса». Proto Observability Platform в России рассматривают как импортонезависимую замену американской Dynatrace.
Условия сделки
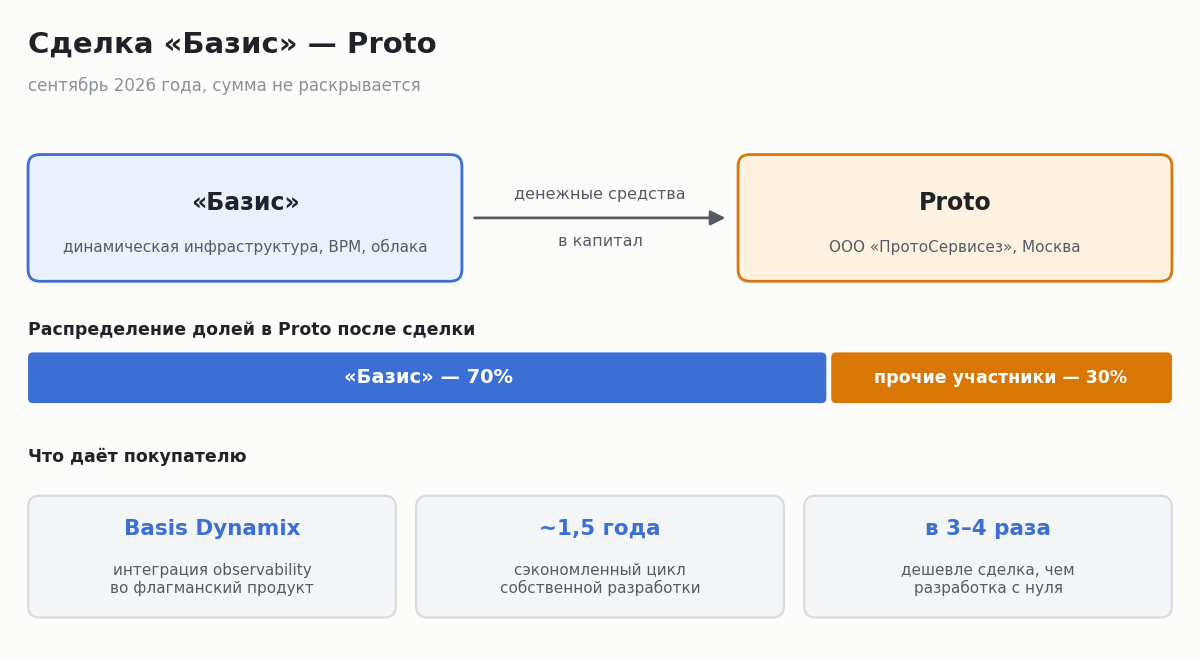
«Базис», поставляющий решения для динамической инфраструктуры, виртуальных рабочих мест и облачных сервисов, забрал себе Proto — команду, которая делает платформу наблюдаемости и аналитики операционных данных на базе искусственного интеллекта. Покупателю досталась доля в 70%. Оформлено приобретение через внесение денег в капитал Proto, и эти средства пойдут на доработку AI-платформы и её встраивание в экосистему «Базиса». Сумму и прочие параметры стороны раскрывать не стали.
Смысл покупки для «Базиса» двоякий: усилить собственное предложение в сегменте серверной виртуализации и обзавестись внутренним центром компетенций по мониторингу. Proto войдёт в структуру группы на правах дочерней компании, а её коллектив обещают не только сохранить, но и нарастить.
Сегодня платформы наблюдаемости и аналитики операционных данных становятся важной частью современной ИТ-архитектуры. По мере роста распределённых систем, контейнерных сред и облачных платформ заказчикам уже недостаточно мониторинга отдельных компонентов, им необходима сквозная видимость инфраструктуры, приложений и связанных с ними бизнес-процессов в едином контуре. Именно поэтому мы рассматриваем приобретение Proto как стратегически значимое для дальнейшего развития экосистемы «Базиса», — прокомментировал сделку генеральный директор «Базиса» Давид Мартиросов.
Сама Proto видит в новом владельце сильного союзника — с солидным запасом ресурсов и широкой клиентской базой.
Партнерство с таким игроком позволяет нам быстрее реализовать наше видение развития Proto и масштабировать продукт вместе с одной из ведущих российских ИТ-компаний, — отметил генеральный директор и сооснователь Proto Денис Безкоровайный.
Что умеет Proto Observability Platform
Класс observability-решений нужен для того, чтобы разобраться в происходящем с объектом наблюдения на глубинном уровне. Достигается это за счёт сбора метрик, журналов и трассировок — собранные данные систематизируются, анализируются и позволяют вычленить проблемные участки.
В Proto Observability Platform встроены средства анализа, работающие на машинном обучении. AI-модуль пропускает через себя метрики, логи, трейсы и события инфраструктуры, вычисляет первопричину инцидента и оформляет рекомендации в том виде, который понятен инженеру. Кроме того, он сопоставляет между собой телеметрию, подсказывает вероятные источники сбоев и тем самым сокращает время разбора происшествий.
Расчёт покупателя
Интерес «Базиса» сосредоточен именно на технологиях Proto: их предстоит встроить в собственную программную экосистему. Такой путь избавляет компанию от расходов на создание аналогичной по возможностям разработки с чистого листа.
Приобретение Proto позволило сократить цикл самостоятельной разработки технологий наблюдаемости примерно на полтора года. По внутренней оценке, создание собственного продукта обошлось бы компании в три-четыре раза дороже M&A-сделки, без учета возможного роста себестоимости разработки в будущем, — заявил Давид Мартиросов.
Технологии Proto планируется перенести во флагманские продукты вендора, и прежде всего в Basis Dynamix — платформу виртуализации серверов и контейнеров. За счёт этого заказчики получат предиктивную аналитику состояния ИТ-инфраструктуры и прогнозирование инцидентов средствами искусственного интеллекта. Тем, кто инфраструктурными продуктами «Базиса» не пользуется, оставят возможность настраивать платформу самостоятельно.
Профиль Proto
Proto — российская компания, специализирующаяся на мониторинге и поддержании стабильности цифровых сервисов. В этой области она работает свыше 12 лет, занимаясь в том числе контролем производительности высоконагруженных систем и отслеживанием киберугроз.
На домашнем рынке компании противостоят «Ключ-Астром», Monq, Volgablob, Gmonit и Sage. Если смотреть шире, зарубежными аналогами продукта выступают Dynatrace, Instana Observability, Datadog и New Relic.
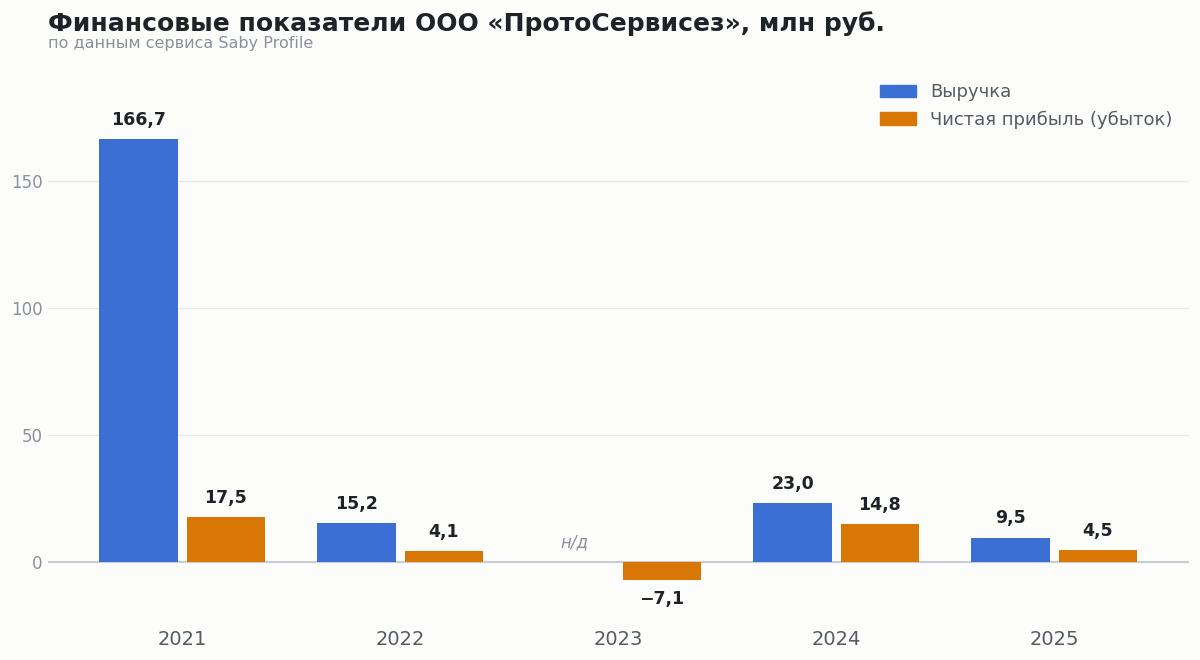
Юридическое лицо — ООО «ПротоСервисез» — зарегистрировано в Москве в мае 2014 г. Уставный капитал составляет 25 тыс. руб. и поделён поровну между Надеждой Борисовной Фердман и Денисом Игоревичем Безкоровайным; последний занимает пост генерального директора. За 2025 г. выручка ООО «ПротоСервисез» составила 9,5 млн руб. при чистой прибыли 4,5 млн руб. Годом ранее показатели были заметно выше: 23 млн руб. доходов и 14,8 млн руб. прибыли.
Рекордным для компании остаётся 2021 г. — тогда выручка достигла 166,7 млн руб., а чистая прибыль — 17,5 млн руб. Уже в 2022 г. доходы просели примерно в десять раз, до 15,2 млн руб., прибыль опустилась до 4,1 млн руб., а 2023 г. и вовсе завершился убытком в 7,1 млн руб.
Одноимённую платформу Proto Observability Platform компания представила рынку в 2022 г. Продукт предназначен для сквозного контроля бизнес-систем, приложений, пользовательского опыта и ИТ-инфраструктуры. В Единый реестр отечественного ПО Минцифры России его внесли в начале августа 2022 г.
Чем известен «Базис»
Выручка «Базиса» по итогам 2025 г. прибавила 37% и достигла 6,3 млрд руб. Показатель OIBDA составил 3,84 млрд руб., чистая прибыль в годовом сопоставлении выросла на 8,6%, до 2,22 млрд руб. В декабре 2025 г. компания вышла на биржу с IPO.
Платформа Basis Dynamix Enterprise возглавила рейтинг российских платформ виртуализации CNewsMarket 2026. Для флагманского продукта вендора это третья победа кряду: он набрал 695 баллов и оторвался от ближайшего преследователя на 25 баллов. Двумя годами ранее, в 2024 г., «Базис» забрал себе «Рустэк» — на тот момент одного из лидеров отечественного рынка средств виртуализации. Разработка «Рустэка» ещё в 2023 г. занимала первую строчку среди российских платформ по версии CNews.
В мае 2026 г. материнская структура «Базиса» — «РТК-ЦОД», компания «СкайФолл Лабс» (SkyFLabs) и Proto подписали соглашение о технологическом партнёрстве. Партнёры договорились строить общую платформу управления ИТ-инфраструктурой и сервисами, которая сведёт воедино инструменты ITSM/ESM, ITAM, мониторинга, наблюдаемости, автоматизации и сервисного взаимодействия.
Вслед за успешно прошедшей конференцией VMware Explore в Лас-Вегасе и майским запуском VMware Cloud Foundation (VCF) 9.1 объявлено о переходе в стадию общей доступности версии VCF 9.1.1. Этот релиз развивает возможности VCF 9.1 и приносит усиленную защиту, объектное хранилище vSAN Object Storage (в статусе технического превью, о чём сообщалось ранее), а также новые функции, призванные сделать частное облако лучшей площадкой для запуска AI-нагрузок, управления ими и их защиты — при одновременном снижении совокупной стоимости владения (TCO) и операционной сложности.
Рассмотрим, что нового появилось в этой версии.
Multi-Tenant Model Sharing: безопасное совместное использование AI-моделей
По мере того как организации разворачивают всё больше моделей AI в разных бизнес-подразделениях, они сталкиваются с хорошо знакомым противоречием: команды хотят самостоятельно и без ограничений использовать модели, тогда как MLOps-специалисты и платформенные инженеры обязаны обеспечивать конфиденциальность данных и соблюдение регламентов. Поддержка отдельного стека моделей для каждого тенанта увеличивает затраты и порождает разрастание инфраструктуры.
Механизм Multi-Tenant Model Sharing решает эту задачу, позволяя безопасно делиться моделями между тенантами или отдельными направлениями бизнеса с сохранением конфиденциальности данных. Команды получают доступ к общим моделям без раскрытия чувствительных обучающих данных и без необходимости создавать изолированные инфраструктурные «острова».
Рисунок 1: Multi-Tenant Model Sharing в VMware Cloud Foundation
К операционным преимуществам такого подхода относятся:
Снижение TCO за счёт общей инфраструктуры моделей вместо дублирующих развёртываний для каждого тенанта.
Упрощение операционной сложности благодаря единой плоскости управления доступом к моделям и политиками.
Сохранение конфиденциальности данных за счёт изолированных по тенантам средств контроля доступа.
Именно так выглядит платформа, изначально спроектированная под AI, а не дополненная соответствующими функциями постфактум.
AI Assistant for VCF: диагностика и конструктор management packs
Инфраструктурные команды тратят значительное время на анализ первопричин сбоев и на поиск проблем в смежной инфраструктуре. По мере роста среды до сотен хостов и кластеров Kubernetes эти трудозатраты только накапливаются.
Помощник AI Assistant for VCF берёт на себя диагностику и построение пакетов управления (management packs). Диагностика на базе AI сокращает среднее время устранения неисправностей (MTTR), помогая командам быстрее выявлять первопричины. С помощью AI пользователи могут разбирать инциденты — например, конкуренцию за ресурсы процессора и память на ESX или иные диагностические аномалии — не обладая узкоспециализированными навыками. Другой пример работы помощника при устранении неполадок — совместный анализ множества ошибок vMotion, позволяющий точно определить, почему миграция vMotion даёт сбой в рамках всей среды vCenter.
AI Assistant for VCF также помогает заказчикам создавать интеграции со сторонними продуктами: конструктор контента задействует API для формирования management packs и content packs, которые в противном случае пришлось бы готовить вручную.
Сочетание диагностики на основе AI с более глубокой видимостью сторонних систем позволяет современным частным облакам устранять операционные узкие места, благодаря чему инфраструктурные команды работают на опережение, а не в режиме реагирования на инциденты.
Новый сервис GitOps [техническое превью]: Argo CD внутри VCF
Команды платформенного инжиниринга всё активнее опираются на GitOps для автоматизации развёртывания и управления жизненным циклом. Однако интеграция инструментов GitOps исторически означала работу за пределами управляющей среды VCF, что добавляло сложности в цепочку инструментов и размывало зоны ответственности при поддержке.
Новый GitOps Service (выпущен в статусе технического превью) добавляет Argo CD в качестве нативного GitOps-сервиса в рамках сервисной управляющей среды VCF. Это объединяет развёртывание и управление жизненным циклом непосредственно в интерфейсе VCF Automation, перенося процессы GitOps в ту же операционную плоскость, где находится остальная инфраструктура. Сокращая разрастание инструментария, команды повышают операционную эффективность и отдачу от вложений. Кроме того, сервис GitOps защищает доступ к конвейерам с помощью аутентификации OIDC, интегрированной с VCF Automation.
Командам платформенного инжиниринга предлагается ранний доступ в формате технического превью — чтобы вместе с ними дорабатывать функциональность под масштабы реальных платформенных команд.
По мере роста сред частного облака растёт и сетевая сложность. Сетевые команды сталкиваются с трудоёмкой настройкой, ограничениями производительности и связанными с этим сложностями при диагностике.
Архитектурные улучшения EVPN: проще и масштабируемее
В VCF 9.1.1 появились важные архитектурные улучшения EVPN, включая оптимизированный путь передачи данных между транзитными шлюзами VCF и физической фабрикой для трафика «восток - запад». Прямые туннели VXLAN между транзитным шлюзом и коммутаторами уровня leaf оптимизируют производительность датаплейна для трафика «восток - запад». Помимо этого, сетевые сервисы — NAT, балансировка нагрузки NSX, балансировка нагрузки AVI и DHCP relay — теперь доступны в режиме распределённой связности EVPN VXLAN. В совокупности эти улучшения обеспечивают критически важную мультитенантную и внешнюю связность, а также дают более высокую производительность, более простую конфигурацию и упрощённую диагностику сред EVPN.
Улучшенная совместимость с физической фабрикой означает, что сетевые команды могут проектировать и эксплуатировать более крупные и гибкие сети частного облака без той сложности, которая традиционно замедляла их работу.
Add-on Management Framework в VMware vSphere Kubernetes Service 3.7: уверенность при масштабировании
По мере роста сред Kubernetes разрастается и экосистема дополнительных инструментов — сетевых, средств наблюдаемости, безопасности, хранения данных. Основные трудности проявляются на этапе Day 2: управление жизненным циклом дополнений и устранение возникающих проблем. Ситуацию усугубляет неясность в зонах ответственности за поддержку - непонятно, к кому обращаться, когда что-то ломается. Механизм Add-on Management Framework в vSphere Kubernetes Service (VKS) 3.7 обеспечивает предсказуемую поддержку с прозрачным распределением ответственности и даёт заказчикам свободу выбора при внедрении экосистемных инструментов. Чёткие маршруты поддержки на каждом уровне сокращают время до решения проблемы, давая командам уверенность при масштабировании и скорость для внедрения инноваций.
Следующий шаг
Версия VCF 9.1.1 уже доступна. Для тех, кто уже эксплуатирует VCF 9.1, этот релиз продолжает линию регулярных обновлений с усилением безопасности, удерживающих частное облако на переднем крае AI-инфраструктуры. Для тех, кто пока только оценивает VCF, сейчас лучшее время для перехода.
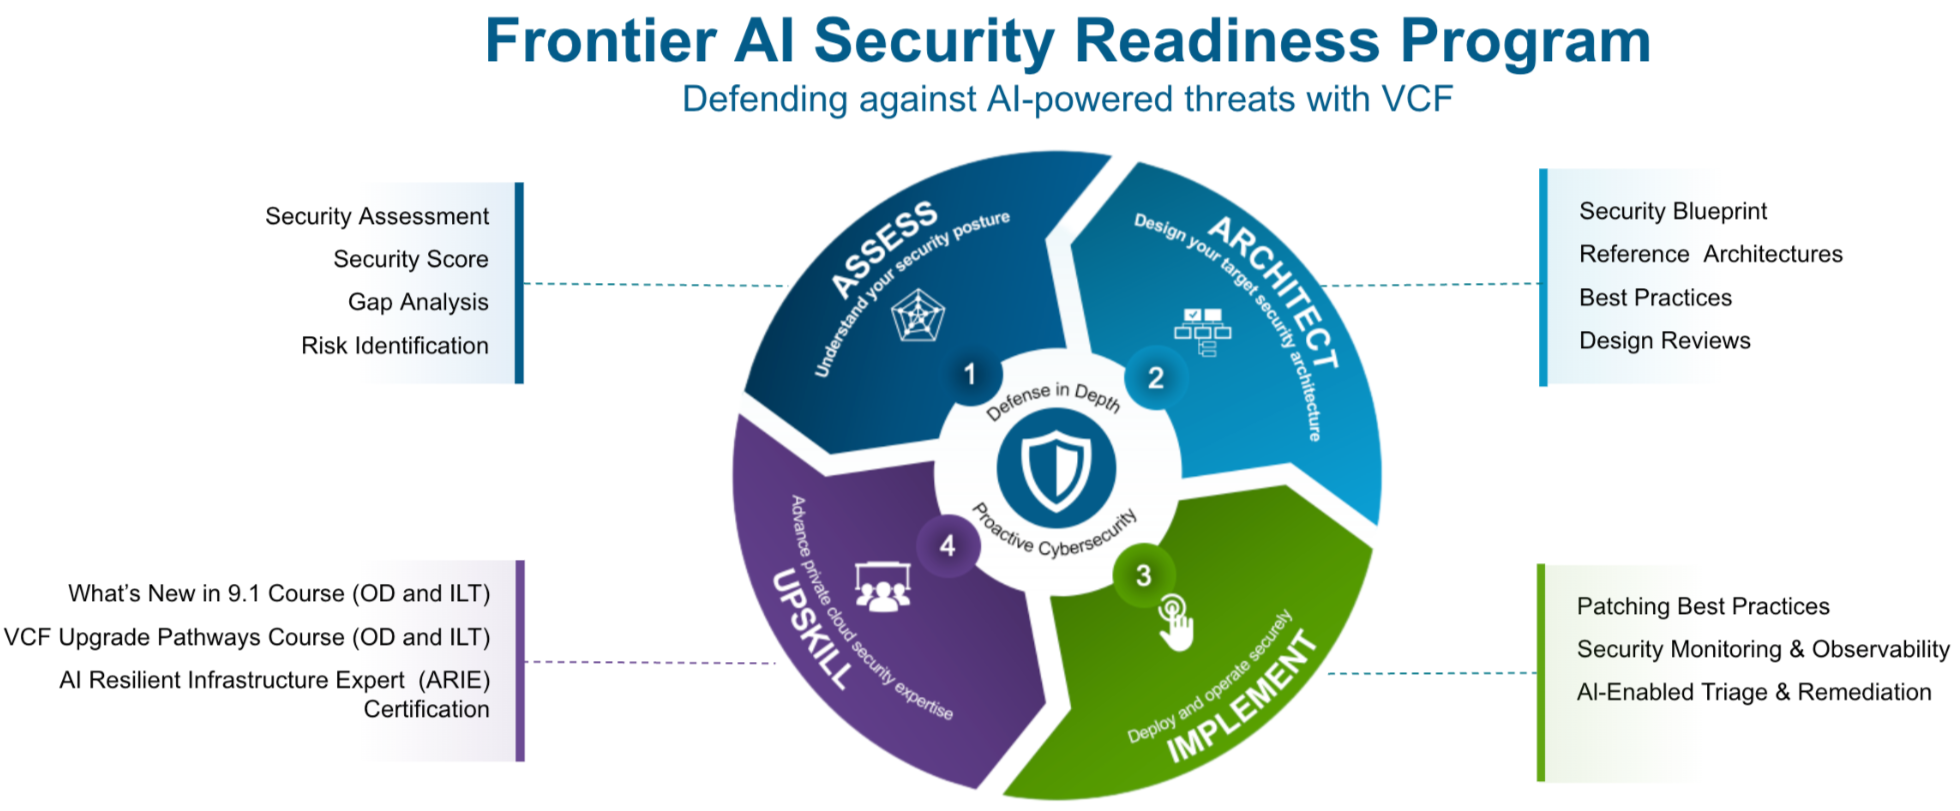
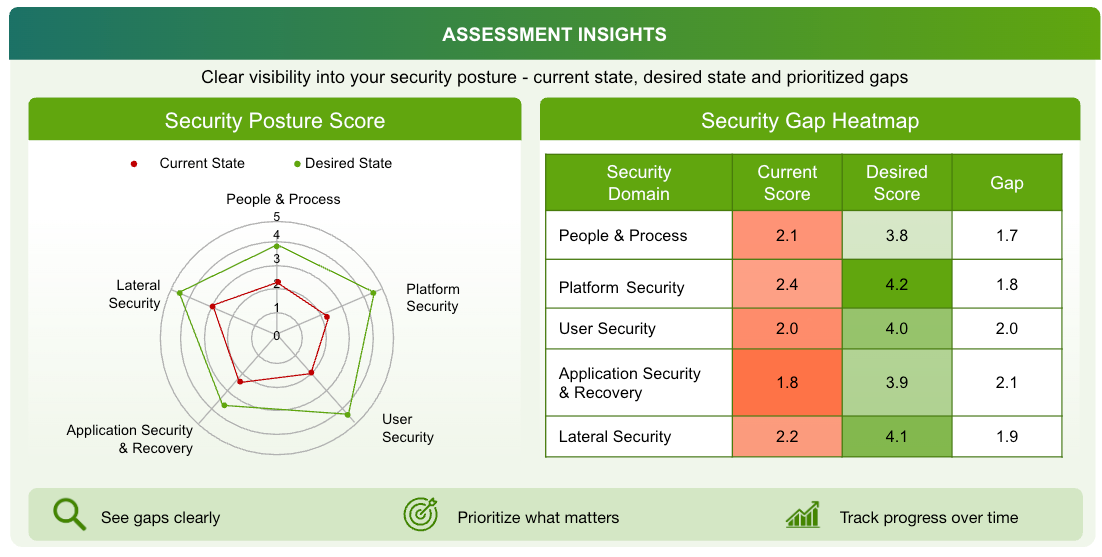
Передовой искусственный интеллект (frontier AI) коренным образом меняет ландшафт кибербезопасности: он повышает скорость, масштаб и изощрённость атак и одновременно сжимает окно, за которое защита успевает отреагировать. Такие ускоренные векторы атак требуют проактивной защитной позиции. Заказчикам помогают ориентироваться в новом ландшафте угроз с помощью стратегических рекомендаций, изложенных в этом материале.
Усиление защиты частного облака остаётся критически важной задачей, однако из-за внутренней сложности уникальных пользовательских сред универсальные сценарии действий оказываются неэффективными. Понимание текущего положения дел и выявление критических пробелов необходимы, чтобы расставить приоритеты среди наиболее результативных практик, особенно для ИТ-команд, работающих в условиях жёсткого дефицита времени.
Сегодня по всему миру запускается программа Frontier AI Security Readiness Program, которая предлагает заказчикам направляемую, предписывающую и адаптированную траекторию движения к более устойчивому частному облаку. Эффективная защита от угроз, управляемых AI, требует сквозного, целостного подхода к безопасности, а не разрозненных фрагментарных решений.
Программа объединяет комплексную методологию, состоящую из четырёх взаимосвязанных этапов:
Assess (оценка): количественно измерить экспозицию и пробелы в защитной позиции, чтобы получить базовую линию, основанную на данных.
Architect (проектирование): определить целевое состояние, объединив результаты анализа пробелов с проверенными блупринтами по пяти разрезам.
Implement (внедрение): развернуть усиленные конфигурации, опираясь на бесшовное обновление, непрерывный мониторинг и сортировку инцидентов с помощью AI.
Upskill (повышение квалификации): развить компетенции организации за счёт специализированных учебных курсов по VMware Cloud Foundation (VCF) 9.1 и будущей сертификации AI Resilient Infrastructure Expert (ARIE).
В эпоху передового AI автономные угрозы эксплуатируют задержки с установкой обновлений и нехватку квалификации персонала на машинной скорости. Объединяя технологии, автоматизацию и развитие кадров, эта методология обеспечивает четыре стратегических результата: построение устойчивого частного облака, минимизацию поверхности атаки, быстрое реагирование на уязвимости и поддержание адаптивной позиции безопасности.
Чтобы построить устойчивое частное облако, первым фундаментальным шагом программы безопасности становится оценка, поскольку нельзя защищать то, что не измерено. Веб-инструмент VCF Security Assessment даёт объективную, основанную на баллах видимость защитной позиции по всему стеку, применяя риск-ориентированную систему оценок, чтобы приоритизировать значимые продуктивные среды и DMZ над менее критичными лабораторными нагрузками.
Защита частных облаков VMware Cloud Foundation (VCF) от управляемых ИИ угроз, действующих на машинной скорости, требует отказа от статических периметров в пользу автоматизированной модели secure-by-design. Лепестковая диаграмма и анализ пробелов, которые формирует опросник оценки безопасности, помогают совершить этот переход: они вскрывают критические уязвимости и дают немедленную визуальную ясность по пяти архитектурным опорам — People and Process, User Security, Platform Security, Lateral Security и Application Security & Recovery. Вооружившись этими данными, организации могут выстроить устойчивую базовую линию платформы, которая минимизирует поверхность атаки, обеспечивает строгий контроль идентичностей, ограничивает горизонтальное перемещение и позволяет быстро восстанавливаться. Тем самым реактивное управление обновлениями превращается в целенаправленную непрерывную защиту, способную выдерживать атаки эпохи Frontier AI.
Этап Architect
После того как базовая линия безопасности установлена, этап Architect переводит сырые результаты оценки в конкретный устойчивый целевой дизайн. Сочетание баллов оценки безопасности и тепловых карт пробелов с VCF Security Blueprints по тем же пяти ключевым разрезам — People & Process, Platform, User, Lateral и Application Security & Recovery — даёт чёткие предписывающие рекомендации. Это обеспечивает точный набор строительных блоков для реализации: от внедрения строгого RBAC и SSO до перехода на VCF 9.1+ ради автоматизированного обновления в рамках жизненного цикла и встраивания базовых сетевых механизмов, шифрования и средств аварийного восстановления.
С точки зрения угроз передового AI такой системный конвейер критически важен. Автономные атакующие движки используют архитектурную несогласованность, дрейф конфигураций и задержки в установке патчей, чтобы связывать эксплойты в цепочки гораздо быстрее, чем команды успевают реагировать вручную. Соединяя данные оценки с чертежами по пяти разрезам для выработки предписывающих рекомендаций, можно устранить догадки при проектировании и обеспечить стандартизированные, жёстко заданные ограничители по всему стеку VCF. Это помогает гарантировать, что архитектура структурно защищена от непрерывных атак, оркестрируемых AI.
Этап Implement
Как только целевая архитектура определена, этап внедрения и эксплуатации переводит безопасность в плоскость повседневных операций через три ключевых вида деятельности:
Развёртывание компонентов по проверенным, усиленным блупринтам
Выполнение бесшовного автоматизированного обновления для поддержания соответствия требованиям
Использование сканеров безопасности для бюллетеней VMware Security Advisories, чтобы быстро приоритизировать уязвимости
Помимо этих базовых активностей интегрируются развивающиеся возможности AI, включая операции с AI-поддержкой, сортировку и устранение проблем силами AI, непрерывное применение политик и аналитику угроз в реальном времени. Эти возможности дают командам силы защищать, обнаруживать и реагировать в нужном масштабе.
С точки зрения угроз передового AI этот операционный фундамент становится передним краем обороны. Автономные атакующие агенты целенаправленно эксплуатируют операционную задержку между публикацией бюллетеня безопасности и установкой патча, выполняя эксплойты на машинной скорости. Чтобы бороться с AI при помощи AI, автоматизированные сценарии обновления, непрерывная аналитика безопасности и анализ первопричин на базе AI сокращают окно уязвимости практически до нуля. Это помогает частному облаку динамически адаптироваться и самокорректироваться, оставаясь устойчивым к современным векторам угроз.
На всех трёх этапах заказчики работают рука об руку со своими системными инженерами (SE) и техническими менеджерами (TAM), либо с партнёрами. Стоит отметить, что VCF Professional Services предлагает набор сервисов, соответствующих этапам программы (Assess, Architect, Implement), а экспертное сопровождение способно заметно ускорить сроки проектов. Подробности о VCF Professional Services можно узнать у своей команды по работе с клиентами.
Этап Upskill
Заключительная опора программы готовности к безопасности сосредоточена на готовности людей и реализуется через специализированное обучение и лидирующие в отрасли сертификации. В эпоху передового AI повышение квалификации сотрудников становится фундаментальным требованием: только так команды смогут грамотно проектировать, эксплуатировать и поддерживать структурно устойчивое частное облако перед лицом эволюционирующих угроз на машинной скорости.
Учебная программа VCF 9.1 даёт глубокое понимание современных путей обновления и функций киберустойчивости, помогая персоналу оставаться в курсе новейших архитектурных ограничителей.
Сертификационный трек AI Resilient Infrastructure Expert (ARIE), скоро
Готовящийся трек ARIE предлагает три целевых учебных маршрута, рассчитанных на структурное усиление защиты платформы VCF:
Специалисты по продажам (4 часа): фокус на свободном владении темой устойчивости к AI, позиционировании VCF как стека безопасности и эффективных стратегиях общения с CISO.
Системные инженеры (около 10 часов): технические погружения во внутреннее устройство DFW, VM-identity, Avi WAF, Live Recovery и VulnOps для защиты на машинной скорости.
Кандидаты VCDX (40 часов): продвинутые лабораторные работы, ведущие к сертификациям VCAP/VCDX, с упором на применение Zero Trust и автономное реагирование на угрозы.
Эти адаптированные маршруты позволяют персоналу получить предписывающую экспертизу, необходимую для защиты стека VCF от современных векторов атак. По завершении специализированной учебной программы команды будут способны:
Проектировать архитектуры Zero Trust в соответствии с методиками NIST, CIS и MITRE.
Обеспечивать защиту рабочих нагрузок средствами микросегментации vDefend, IDS/IPS и Avi WAF.
Использовать Salt для автоматизации непрерывного контроля соответствия и устранения дрейфа конфигураций.
Обеспечивать устойчивость к программам-вымогателям и выполнять быстрое ускоренное восстановление.
С обучением AI Resilient Infrastructure Expert команды не просто узнают о защите современного частного облака. Они получают сертификацию на защиту платформы VCF. Стоит учитывать, что сертификации сгруппированы по нескольким технологическим направлениям и имеют уровни как для новичков в отрасли, так и для экспертов. Подробнее об этом рассказывает страница VMware Certification.
Во-вторых, стоит связаться со своей командой по работе с клиентами или партнёром, чтобы разобраться в предложениях VCF Professional Services, которые помогают ускорить высокоприоритетные ИТ-проекты. Наконец, стоит воспользоваться правами на обучение VCF Learning, чтобы повысить или сменить квалификацию с помощью продвинутых курсов и новых сертификаций VCAP и VCDX, а также следить за анонсом будущего трека обучения и сертификации AI Resilient Infrastructure Expert (ARIE).
Одна мысль звучит от заказчиков VMware постоянно: перенос нагрузок Kubernetes на VMware vSphere Kubernetes Service (VKS) — самый важный шаг на пути внедрения VMware Cloud Foundation (VCF). Долгое время он же оставался и самым трудным для объяснения. У большого числа заказчиков миграция раз за разом всплывала как блокер номер один на пути к VCF. Опасения были реальными и повторяющимися: длинные окна переключения, риск потери данных и методы резервного копирования и восстановления, которые попросту не поспевали за масштабом крупных наборов данных. В отдельных случаях заказчикам приходилось полностью отказываться от старой среды и разворачивать новые кластеры VKS с нуля — только чтобы обойти эту сложность.
Именно эту проблему и взялись решить. За несколько последних месяцев команды профессиональных сервисов, решений и инженерная команда проверили три различных пути миграции на широком наборе исходных топологий: от Tanzu и OpenShift на vSphere до Kubernetes на «голом железе» и облачных дистрибутивов вроде EKS, GKE и AKS. Результатом стал повторяемый плейбук из трёх путей, за которым стоят скрипты, ранбуки и технические документы. Этот материал обобщает четыре документа, кодифицирующих плейбук, и даёт практическую систему выбора нужного пути под конкретную ситуацию. Полный список документов доступен по ссылкам ниже.
OpenShift на «голом железе», облачные Kubernetes, любой сторонний CSI
Методология, общая для всех сценариев
Все четыре документа опираются на один и тот же каркас — четырёхфазную методологию, которая сохраняет миграцию проверяемой и обратимой:
Discover — инвентаризация всего: объекты Kubernetes API, топология сети, RBAC и секреты (значения никогда не выгружаются), а также перекрёстная сверка с FCD в vSphere, сопоставляющая каждый PVC с PV и с UUID диска FCD.
Analyze — трансляция специфичных для платформы объектов в эквиваленты VKS (Routes в OpenShift становятся Ingress, SCC — Pod Security Admission, проекты Rancher — пространствами имён) и выбор пути для данных.
Blueprint — фиксация плана в файле Solution Definition File (SDF) с тремя письменными шлюзами согласования: спонсор, платформа, комплаенс. Ни одна волна не выполняется, пока не подписаны все три.
Execute — поволновая миграция с прогонами вхолостую, шлюзами валидации и отрепетированным откатом.
Различаются ситуации тем, какой путь для данных выбирается на второй фазе: именно он определяет простой, риск потери данных и инструментарий.
Варианты переноса постоянных данных
Это самое важное решение в любой миграции на VKS, и сводится оно к одному вопросу: находится ли диск, на котором лежит постоянный том, уже внутри vSphere?
Путь 1: Zero-Copy, адаптация FCD только на уровне метаданных
Применяется, когда источник использует драйвер vSphere CSI, а диск First Class Disk (FCD) присутствует в базе данных vCenter. Данные приложения не копируются вообще. Velero переносит манифесты Kubernetes (PV, PVC и снимки при этом исключаются), а сам FCD отцепляется от источника и заново регистрируется на целевом кластере через CnsRegisterVolume. Всё это время том физически остаётся на том же хранилище данных.
Простой: ограничен синхронизацией API, а не полосой пропускания — менее 2 минут для тома объёмом 100 ГБ.
Риск потери данных: низкий, поскольку копирования нет, но операционный риск вполне реален — опасность в разделении состояния (split-brain). Оба кластера ни в коем случае не должны монтировать FCD одновременно, иначе повреждение данных наступает немедленно. Источник должен быть масштабирован до нуля прежде, чем целевой кластер подключит диск.
Предварительные требования: хранение источника на vSphere CSI; FCD разрешается в vCenter; политика reclaim у PV изменена на Retain до освобождения исходного claim; проверена целостность UUID диска FCD (Storage vMotion между хранилищами может изменить UUID); подключением должен управлять драйвер CSI, а не команда govc disk.attach.
Путь 2: Data-Copy, копирование данных
Применяется, когда хранение реализовано не на vSphere CSI (AWS EBS, Ceph, NFS, облачные блочные хранилища) либо когда FCD в vCenter отсутствует. Данные физически перемещаются через S3-совместимое объектное хранилище с помощью Data Mover для снимков CSI в Velero: встроенный в агент узла движок Kopia выполняет дедупликацию, сжатие, шифрование и выгрузку блоков, а целевая сторона создаёт новый том vSphere CSI и загружает данные в него.
Простой: растёт вместе с объёмом тома и зависит от полосы пропускания — 45–90 минут для тома 100 ГБ. Замеры дали около 24 минут для одного PVC на 450 ГиБ при использовании движка под управлением оператора и около 86 минут для четырёх томов по 450 ГиБ (1,8 ТиБ) параллельно.
Риск потери данных: выше, поскольку данные активно копируются. Но источник при этом не изменяется, поэтому откат обходится дёшево: достаточно удалить целевое пространство имён и заново созданные тома, а источник остаётся главным вплоть до момента переключения.
Предварительные требования: Velero и CSI Data Mover (либо файловое резервное копирование для драйверов без поддержки снимков); общая точка BackupStorageLocation на S3, доступность которой подтверждена с обоих кластеров; сетевая доступность; класс хранения с немедленной привязкой (Immediate) на целевой стороне; MinIO или S3 объёмом не менее 1,2 от самой крупной партии.
Замечание об инструментах: путь с копированием данных использует Velero вместе с Restic или Kopia (либо Data Mover для снимков CSI в составе Velero). Для источников вне vSphere документы описывают также pv-migrate — более прямой инструмент переноса данных «точка-точка» на базе rsync. А для переездов между кластерами VKS в разных vCenter блоки FCD переносит сам vMotion, и этот вариант предпочтительнее и Velero, и pv-migrate, поскольку он уже является частью vSphere.
Какой путь выбрать: руководство по принятию решения
Ниже — практическая рекомендация для каждой ситуации.
Ситуация 1: инфраструктура уже на vSphere (TKG, OpenShift, Rancher, upstream)
Это идеальный случай, и именно на него приходится основной спрос со стороны заказчиков сегодня: более 300 кластеров на vSphere CSI ждут такого переезда. Почти наверняка такая инфраструктура подходит под zero-copy-адаптацию FCD, которая превращает многочасовое окно простоя в считанные минуты. Схема принятия решения из документа выглядит так:
Драйвер хранения — csi.vsphere.vmware.com, и FCD присутствует в vCenter: zero-copy через CnsRegisterVolume.
Любой другой драйвер CSI либо отсутствие FCD в vCenter: копирование данных через Velero с Restic или Kopia.
Обязательно следует сменить политику reclaim у PV на Retain до удаления исходного PVC, проверить UUID диска FCD после любого Storage vMotion и никогда не допускать одновременного монтирования обоими кластерами. Состояние Helm нужно обрабатывать явно. Миграция пространств имён без фильтров исключения сохраняет на целевой стороне секреты релизов Helm (sh.helm.release.v1) и блокирует helm upgrade. Этап 6.5 методологии выполняет сверку или пересборку релиза с ключом --take-ownership.
Рекомендация: по умолчанию выбирать zero-copy. Копирование данных оставить для небольшого набора томов на стороннем хранилище. Рассчитывать стоит на SLA отката менее 10 минут, если что-то пойдёт не так.
Ситуация 2: инфраструктура уже на VKS, перенос между кластерами VKS
Внешне это похоже на первую ситуацию, но нюанс в том, где расположены Supervisor и vCenter.
Тот же vCenter и то же хранилище данных: zero-copy — объекты Supervisor сохраняются, создаётся новый PV в VKS, и всё завершается менее чем за 2 минуты на каждые 100 ГБ.
Разные vCenter: копирование данных, но силами vMotion, а не Velero и не pv-migrate. vMotion переносит блоки FCD нативно, через транспортную оболочку в виде выключенной вспомогательной виртуальной машины, после чего CnsRegisterVolume адаптирует диск на приёмной стороне. Закладывать следует 45–90 минут на каждые 100 ГБ.
Резервное копирование и восстановление томов средствами Velero здесь явно не выбрано как путь: промежуточное хранение в S3 добавляет задержку, которой vMotion избегает.
Два правила для сценария с разными vCenter важнее прочих. Первое: UUID диска FCD сохраняется при миграции, но его всегда необходимо заново обнаруживать после vMotion — нельзя предполагать, что он совпадает с исходным идентификатором, и нельзя передавать исходный UUID в CnsRegisterVolume. Второе: пространству имён на целевом Supervisor нужна политика хранения, назначенная этому FCD и открытая для данного пространства имён, а также трансляция реестра образов и ingress (например, AKO в Contour) через плагины ConfigMap в Velero.
Рекомендация: если оба кластера используют один vCenter и одно хранилище данных, zero-copy тривиален. Если нет — опираться следует на vMotion, а UUID диска FCD рассматривать как величину, которую всегда перепроверяют, а не принимают на веру. Откат ограничен длительностью vMotion, поэтому RTO стоит отрепетировать.
Ситуация 3: инфраструктура на vSphere, но хранение не на vSphere CSI (NFS, Ceph, внешние массивы)
Этот сценарий сбивает с толку чаще всего. Кластер Kubernetes работает на vSphere, поэтому легко предположить, что zero-copy-адаптация FCD доступна. Но постоянные тома обслуживает сторонний драйвер CSI: NFS, Ceph, внешний массив SAN или NAS либо любой другой сторонний плагин хранения. Адаптировать в vCenter нечего, FCD там просто нет, поэтому zero-copy отпадает. Документ формулирует это прямо: реализация хранения на стороне источника не имеет значения для метода переноса, пока исходный PVC является файловым томом, который задание миграции может смонтировать и прочитать.
Рекомендуемый путь — копирование данных через pv-migrate (rsync поверх SSH), тогда как манифесты Kubernetes переносит Velero. Поскольку перенос работает на уровне файловой системы по сети, источнику и приёмнику не нужно иметь общую платформу хранения, общий драйвер CSI и даже общий vCenter. Этот же документ покрывает и полностью не-vSphere источники: методология идентична, потому что абстракция хранения одна и та же.
Простой: растёт вместе с объёмом набора данных, количеством файлов и доступной полосой пропускания — 45–90 минут для тома 100 ГБ.
Риск потери данных: выше, чем при zero-copy, поскольку данные физически копируются, но исходный PVC не удаляется до тех пор, пока волна не принята, — граница отката сохраняется полностью.
Предварительные требования: исходный PVC является файловым томом; pv-migrate (rsync поверх SSH) для данных; Velero для манифестов; Helm для сверки; сетевая достижимость между источником и VKS по TCP 22 до балансировщика нагрузки VKS; класс хранения StorageClass на стороне VKS.
Ключевой принцип: исходный и целевой тома — независимые объекты хранения. Им не требуется общий vCenter, общий домен CNS, общий массив хранения, общий драйвер CSI или общий дистрибутив Kubernetes. Исходный PVC остаётся на месте и обеспечивает возможность отката до тех пор, пока волна миграции не будет принята.
Нюанс по сравнению с первой ситуацией стоит подчеркнуть: работать на vSphere — недостаточно. Решающим фактором является то, лежит ли постоянный том на диске FCD, которым управляет драйвер vSphere CSI. Если нет, то даже когда сам кластер работает на виртуальных машинах vSphere, сценарий относится к территории копирования данных.
Рекомендация: использовать pv-migrate для копирования данных и Velero для манифестов. Заложить окно по полосе пропускания, выполнить инкрементальную синхронизацию перед переключением, чтобы минимизировать финальную дельту, и сохранять исходный PVC до тех пор, пока нагрузка в VKS не пройдёт проверку. Откат чистый: достаточно удалить целевой PVC и создать его заново, источник остаётся нетронутым.
Ситуация 4: инфраструктура вне vSphere (облако, «голое железо», стороннее хранение)
Zero-copy здесь недоступен, потому что в vCenter нет FCD, который можно было бы адаптировать. Копирование данных остаётся единственным путём, а эталонная архитектура на Velero и S3 — проверенный способ его реализовать. Главная мысль этого документа в том, что источники вне vSphere заставляют встретиться с гравитацией данных лицом к лицу, поэтому работа уходит в классификацию и тонкую настройку, а не в изобретательные приёмы с хранилищем.
Каждый объект классифицируется до переключения по одной из трёх проекций: MIGRATE_AS_IS (переносимый, восстанавливается без изменений), REVIEW_REQUIRED (нужен трансформирующий оверлей — Route в Ingress, DeploymentConfig в Deployment, SCC в Pod Security Admission) или BLOCK_MIGRATION (на целевой стороне отсутствует CRD или оператор — сначала установить, либо исключить). Скрипты проверяются по записанным ожидаемым вердиктам, поэтому неверная классификация всплывает как дефект инструментария до переключения, а не как сломанное приложение после.
Предпочтительна установка под управлением оператора: на источнике это OADP в OpenShift. По результатам проверки она оказалась примерно в 4 раза быстрее нативного Velero для одного PVC на 450 ГиБ (24 минуты против примерно 90), потому что плагин CSI, Data Mover и агент узла остаются согласованными по версиям и обновляются как единое целое. На целевой стороне VKS всегда работает нативный Velero.
Ориентироваться следует на ресурсы DataUpload и DataDownload, а не на фазу Backup или Restore: именно ресурсы данных являются источником истины. PartiallyFailed — нормальное конечное состояние для восстановления, и только постпроверочное сканирование вместе с чек-листом приёмки решают, прошла ли партия.
Асимметрия ёмкости: файловые системы вне vSphere (например, CephFS) сообщают всю номинальную ёмкость как доступную, тогда как целевые тома на vSphere CSI с ext4 заранее выделяют таблицы inode (около 1,7%) и резервируют 5% для root. Исходные PVC следует заполнять не более чем на 90%, а целевые PVC для патологически заполненных томов делать больше.
Рекомендация: планировать копирование данных с самого начала. Заложить окно по полосе пропускания, классифицировать объекты заранее, предпочесть установку Velero под управлением оператора и выполнить дельта-партию непосредственно перед переключением, чтобы последние записи источника попали на целевую сторону. Откат обходится дёшево, поскольку источник не изменяется, поэтому фиксироваться следует только в момент переключения.
Сводим воедино: краткая таблица решений
Если источник…
А хранение…
Использовать путь
Простой (100 ГБ)
Основной инструментарий
Kubernetes на vSphere (TKG, OpenShift, Rancher, upstream)
vSphere CSI и FCD в vCenter
Zero-copy
Менее 2 минут
Velero (манифесты) и CnsRegisterVolume
VKS в VKS, разные vCenter
vSphere CSI
Копирование данных через vMotion
45–90 минут
vMotion и CnsRegisterVolume
Kubernetes на vSphere
Сторонний CSI, FCD отсутствует
Копирование данных
45–90 минут
Velero с Restic или Kopia либо pv-migrate
Kubernetes вне vSphere (облако, «голое железо»)
Любое хранение вне vSphere
Копирование данных
45–90 минут
Velero, CSI Data Mover и S3
Несколько правил, действующих для всех четырёх методов
Каким бы ни был выбранный путь, эти правила работают всегда:
Разделять конфигурацию без состояния и хранение с состоянием. Velero переносит манифесты, путь хранения переносит данные. Смешивать их не нужно.
Никогда не обслуживать трафик с обеих сторон одновременно. Перед финальной партией источник нужно остановить или масштабировать вниз, либо выполнить дельта-партию прямо перед переключением. Две расходящиеся живые копии — самый быстрый способ получить повреждение данных.
Сохранять метаданные PVC, принадлежащие приложению (метки и аннотации для Helm и операторов), но никогда не копировать метаданные привязки и выделения, сгенерированные самим Kubernetes: на восстановленной целевой стороне они не совпадут.
Явно обрабатывать состояние Helm. Не удалять вслепую секреты релизов Helm; до переключения извлечь значения и версию чарта из источника и выполнить сверку с ключом --take-ownership.
Проверять до продвижения. Шлюз продвижения контролирует, что PVC находится в состоянии Bound, реплики готовы, а конечная точка проверки состояния приложения отвечает healthy. До перевода волны в стабильное состояние должны пройти все четыре проверки.
Откат всегда репетируется. Zero-copy даёт RTO менее 10 минут, копирование данных даёт дешёвый откат, поскольку источник не тронут. В любом случае RTO нужно знать до переключения.
Итог
Правильная стратегия миграции — та, что соответствует месту, где данные уже находятся. Если тома уже являются дисками FCD в vSphere, zero-copy-адаптация превращает миграцию в операцию с метаданными, измеряемую минутами. Если нет, хорошо настроенный конвейер копирования данных на Velero и S3, с дисциплинированной классификацией объектов и отрепетированным откатом, приведёт к цели столь же безопасно, просто по графику, который упирается в полосу пропускания. А если инфраструктура уже работает на VKS, vMotion вместе с CnsRegisterVolume позволяет переезжать между кластерами вообще без копирования на уровне Kubernetes.
Обратная связь
Описанные пути миграции проверены, но не заморожены. По мере того как всё больше команд будет прогонять их на реальных производственных нагрузках, именно этот опыт отточит следующую редакцию плейбука. Обратная связь здесь по-настоящему важна. Связаться с Broadcom за подробностями можно, используя эту форму.
Шифрованный vMotion уже много лет остаётся одним из краеугольных камней защиты рабочих нагрузок в средах VMware. Он гарантирует, что данные виртуальной машины защищены при передаче каждый раз, когда ВМ перемещается между хостами, и для большинства продуктивных сред это попросту обязательное требование. С выходом VMware Cloud Foundation (VCF) 9.1 эта защита становится ещё эффективнее: криптографическая работа перекладывается на Intel QuickAssist Technology (QAT) — аппаратный ускоритель, встроенный в современные процессоры Intel Xeon. В VCF 9.1 функция включена по умолчанию и не требует какой-либо настройки. Команде инженеров было важно понять, сколько именно вычислительной мощности CPU возвращается заказчику, когда шифрованием занимается QAT, а не процессор. Тесты были проведены, и результаты дают вполне однозначную картину.
Как работает разгрузка на QAT
Когда запускается миграция vMotion, данные ВМ шифруются на исходном хосте и расшифровываются на целевом. При использовании разгрузки на QAT в VCF 9.1 работа по шифрованию и расшифровке выполняется аппаратным ускорителем QAT, а не центральным процессором. Процессоры на обеих сторонах освобождаются и могут заниматься выполнением рабочих нагрузок. Для администратора функция прозрачна и на поддерживаемом оборудовании Intel Xeon включена по умолчанию. Подробнее о разгрузке шифрованного vMotion на Intel QAT в VCF 9.1 рассказывается в отдельной статье.
Стенд для тестирования
Для испытаний требовалась нагрузка, чувствительная к доступности CPU, — такая, на которой было бы отчётливо видно, что происходит с производительностью приложения, когда процессор получает обратно такты, ранее уходившие на шифрование. Выбор пал на базу данных Oracle под управлением HammerDB — OLTP-нагрузку с интенсивным профилем дисковых операций. Основной метрикой состояния системы на протяжении всех испытаний служила пропускная способность транзакций Oracle (операций в секунду).
Методика миграции была следующей: на этапе измерений в установившемся режиме выполнялось восемь последовательных операций vMotion с паузой в 120 секунд между соседними миграциями. Восемь прогонов дают статистически честную картину вместо одной-единственной точки данных.
Тестировались три конфигурации:
Шифрование отключено: теоретический потолок без каких-либо криптографических накладных расходов.
QAT Off: шифрованный vMotion полностью выполняется программно силами CPU.
QAT On: шифрованный vMotion разгружен на аппаратный ускоритель Intel QAT.
Результаты
Медианные значения по всем восьми миграциям:
Метрика
Шифрование отключено
QAT OFF
QAT ON
Время миграции (секунды)
57,22
86,97
84,71
Пропускная способность предварительного копирования (МБ/с)
10 871
7 592
7 146
CPU исходного хоста (среднее число одновременно занятых ядер)
7,8*
20,1
7,7
CPU целевого хоста (среднее число одновременно занятых ядер)
18,8*
13,6
10,5
Пропускная способность Oracle (операций/с)
51 319
44 306
50 634
Время простоя ВМ (секунды)**
0,42
0,33
0,78
* Эта конфигурация завершает миграции за существенно меньшее астрономическое время, поэтому её показатель среднего числа одновременно занятых ядер отражает ту же фоновую работу CPU, сжатую в более короткое окно, и не является корректной точкой сравнения с конфигурациями QAT On и QAT Off. Приводится исключительно для справки.
** Время простоя в обеих конфигурациях оставалось близким к целевому, а наблюдаемый разброс обусловлен характером передачи страниц (page-in) на конкретно этой нагрузке, а не работой QAT. Разгрузка шифрования не оказывает причинно-следственного влияния на время простоя.
Экономия CPU на исходном хосте
Загрузка CPU исходного хоста падает с примерно 20,1 ядра при QAT Off до примерно 7,7 ядра при QAT On — это около 62% сокращения вычислительной мощности, расходуемой на шифрование vMotion на стороне источника. Процессорные ресурсы, ранее занятые шифрованием, теперь могут быть отданы работе Oracle. Целевой хост тоже выигрывает: накладные расходы на расшифровку сокращаются примерно на 23% (с ~13,6 до ~10,5 ядра). Больший выигрыш достаётся исходному хосту, поскольку шифрование из этих двух операций вычислительно более затратно.
Пропускная способность Oracle
При QAT Off пропускная способность Oracle в окне миграции составляла 44 306 операций в секунду. При QAT On она восстановилась до 50 634 операций в секунду, что на 14% больше, чем при чисто программном шифровании. Для OLTP-среды, где темп транзакций напрямую отражается на бизнес-результате, эта возвращённая пропускная способность имеет вполне ощутимую ценность.
Время миграции
Конфигурации QAT On и QAT Off дают практически одинаковое время миграции — 84,71 против 86,97 секунды. Разгрузка на QAT и не рассчитана на то, чтобы ускорять саму миграцию. Операции копирования по сети и работы с памятью занимают одинаковое время в обоих случаях. Меняется другое — сколько процессорного запаса остаётся работающей нагрузке, пока идёт эта передача.
Стабильность и джиттер
Разгрузка на QAT полностью развязывает шифрование и планирование выполнения на CPU, и это проявляется в измеримо меньшем разбросе как времени миграции, так и пропускной способности гостевой системы при повторяющихся миграциях. Для нагрузок, работа которых регламентирована SLA, такая предсказуемость имеет вполне реальную эксплуатационную ценность.
Результаты при одновременных миграциях vMotion
Результаты по одиночной ВМ показывают лишь часть картины. Сценарии эвакуации хоста подразумевают множество одновременных миграций. Такие тесты также были проведены.
При невысокой степени параллелизма (от 4 до 6 ВМ одновременно на каналах 25–50 GbE) QAT обеспечивает сокращение нагрузки на CPU на 40–45% без изменения времени завершения миграций. При более высокой степени параллелизма, характерной для полной эвакуации хоста, миграции завершаются практически с той же скоростью, что и без QAT, тогда как потребление CPU на исходном хосте снижается вплоть до ~39%. Плановое обслуживание или аварийная эвакуация — в обоих случаях QAT возвращает задействованным хостам заметный запас процессорной мощности.
Возврат CPU рабочим нагрузкам
Основная ценность разгрузки на QAT состоит не в скорости миграции. Она в том, что именно возвращается системе. Каждое ядро вычислительной мощности, которое QAT удерживает от работы по шифрованию, — это ядро, которое рабочая нагрузка забирает себе для полезной работы. В проведённых тестах это выразилось в 14% приросте пропускной способности Oracle, удерживаемом на протяжении всего окна миграции, и примерно 62% сокращении вычислительной мощности, потребляемой шифрованием на исходном хосте, что эквивалентно примерно 12 освободившимся ядрам во время миграции.
Для команд, эксплуатирующих плотные OLTP-среды, эти возвращённые такты могут стать разницей между сохранением темпа транзакций в окне обслуживания и его проседанием. Для более широкого класса смешанных нагрузок профиль выигрыша аналогичен. Процессор хоста может уделять больше внимания выполнению рабочих нагрузок, пока шифрованием занимается QAT.
Есть и эксплуатационный аспект. Поскольку QAT снимает с исходного хоста основную часть «процессорного налога» во время миграций, хосты с частой активностью vMotion — активные кластеры DRS или площадки с насыщенным графиком обслуживания и эвакуаций — сохраняют больший запас CPU для продуктивных нагрузок на протяжении всех этих операций, вместо того чтобы закладывать дополнительный резерв под накладные расходы на шифрование.
Что это значит на практике
Если VCF 9.1 уже работает на поддерживаемом оборудовании Intel Xeon, разгрузка на QAT уже активна. В среде виртуализации настраивать ничего не требуется. Практический вопрос в другом — что именно дадут конкретной инфраструктуре возвращённые процессорные такты. Для нагрузок с интенсивным OLTP-профилем вроде Oracle ответ очевиден: это пропускная способность транзакций, которую QAT возвращает приложению. Для других чувствительных к CPU нагрузок профиль выигрыша схож.
Итоги
Разгрузка на QAT в VCF 9.1 даёт примерно на 62% меньше накладных расходов CPU на исходном хосте, на 14% более высокую пропускную способность Oracle, удерживаемую в течение окна миграции, и меньший разброс времени миграции и производительности приложения при повторяющихся прогонах. Всё это происходит прозрачно на уровне инфраструктуры, на оборудовании, которое уже присутствует в большинстве развёртываний на Intel Xeon. Шифрованный vMotion продолжает делать ровно то же, что делал всегда: защищать рабочие нагрузки при передаче. Разгрузка на QAT лишь позволяет ему делать это, одновременно возвращая процессорные ресурсы тем нагрузкам, которым они нужны.
Тем, кто ещё не перешёл на VCF 9.1, это даёт конкретный измеримый повод для обновления. Для тех, кто уже работает на этой версии, описанный механизм уже действует в их среде. Проверить, поддерживает ли конкретная модель Intel Xeon технологию QAT, можно на ark.intel.com — и начать возвращать процессорные такты уже сегодня.
Для администраторов vSphere и инженеров автоматизации ESXCLI остаётся одной из самых базовых утилит в наборе средств управления VMware. Она позволяет удалённо выполнять команды управления хостом: обращаться к хосту ESXi напрямую или работать с любым хостом под управлением vCenter Server — с локальной рабочей станции или административного jumpbox, без интерактивной SSH-сессии к самому хосту.
Недавно было объявлено о переводе автономной версии ESXCLI 9.1.0 (сборка 25692154) в статус общей доступности. Этот выпуск приносит упрощённую установку за счёт использования штатной упаковки Python, модернизацию платформы, ужесточение требований безопасности при проверке хоста, детальное управление клиентским логированием и критически важные исправления стабильности аутентификации.
Независимо от того, на какой системе выполняются задачи администрирования — Linux, macOS или Windows, — ESXCLI 9.1.0 делает удалённое управление более безопасным, доступным и надёжным.
Что нового в ESXCLI 9.1.0
1. Современные требования к Python и упрощённая поставка через PyPI
ESXCLI 9.1.0 распространяется как единый пакет Python, совместимый с PyPI. Установку и обновление автономной версии на Linux, Windows и macOS теперь можно выполнять стандартными инструментами управления пакетами Python.
Системные требования:
Версия Python: требуется Python 3.10 или новее.
Отказ от устаревших версий: Python 2.7 и версии Python ниже 3.10 больше не поддерживаются.
Чтобы установить ESXCLI 9.1 через PyPI, выполните:
2. Ужесточение требований безопасности: отказ от SHA-1
Требования стандартов безопасности в корпоративной инфраструктуре продолжают развиваться. В ESXCLI 9.1.0 отпечатки серверных сертификатов SHA-1 официально больше не принимаются.
Уведомление о критическом изменении
При установлении проверенных удалённых сессий поддерживаются только отпечатки SHA-256 и SHA-512. Это относится к следующим способам передачи отпечатка:
параметр командной строки --thumbprint;
переменная окружения VI_THUMBPRINT;
записи, сохранённые в хранилище учётных данных ESXCLI.
Важное действие, которое нужно выполнить до обновления: проверьте автоматизированные скрипты, конвейеры CI/CD, переменные окружения и конфигурации хранилища учётных данных. Отпечатки SHA-1 необходимо заменить на отпечатки SHA-256 или SHA-512 до перехода на новую версию. Соединения, опирающиеся на отпечатки SHA-1, в версии 9.1.0 работать не будут.
Пример: запуск ESXCLI с отпечатком SHA-256
esxcli --server=vcenter.domain.local --target=esxi01.domain.local \
--username=administrator@vsphere.local \
--thumbprint=25:E3:4C:…:SHA256_THUMBPRINT… \
system version get
3. Гибкое управление клиентским логированием
В предыдущих версиях ESXCLI автоматически создавал и поддерживал ротируемый файл .log рядом с исполняемым файлом. В версии 9.1.0 поведение журналирования полностью настраивается и по умолчанию не проявляет себя никак.
Поведение по умолчанию: клиент больше не создаёт файл журнала на диске и не пишет в него.
Произвольный путь к журналу (--log-file): перенаправление клиентских сообщений журнала в выбранный вами файл.
Подробное и отладочное журналирование (--log-verbose): включение детализации уровня debug для изучения деталей протокола и диагностики проблем с подключением или выполнением команд.
Пример: подробное журналирование в произвольный файл
esxcli --server=esxi01.domain.local \
--log-file=/var/log/esxcli-debug.log \
--log-verbose \
network nic list
Чек-лист обновления для администраторов
Прежде чем переходить на версию 9.1, держите в уме этот короткий список проверок:
Проверьте окружение Python: убедитесь, что на административных рабочих станциях используется Python 3.10 или новее.
Обновите отпечатки: замените все отпечатки SHA-1 в скриптах и сохранённых хранилищах учётных данных на отпечатки SHA-256 или SHA-512.
Пересмотрите сценарии работы с журналами: если какие-либо пользовательские рабочие процессы полагаются на чтение файла журнала, который раньше создавался по умолчанию рядом с бинарным файлом ESXCLI, обновите эти сценарии так, чтобы они явно передавали --log-file <path>.
Развёртывание контейнерных нагрузок в изолированных (air-gapped) средах всегда требовало тщательной проработки — особенно в ситуации, когда реестр платформы, который планируется использовать, не может установить сам себя без образов, которых у него ещё нет. Именно поэтому упрощение развёртывания Harbor в качестве Supervisor Service в изолированных средах VMware Cloud Foundation (VCF) стало одним из ключевых направлений работы. Раньше эффективным промежуточным решением служили наработки сообщества, например сторонние реестры, а теперь предлагается официальный, поддерживаемый в рамках VCF вариант, спроектированный специально под этот сценарий.
С выходом VMware Bootstrap Registry Appliance в полной доступности (General Availability) появилось официальное решение с поддержкой со стороны VCF: специализированный OVA-образ, который даёт заказчикам VCF чистый, безопасный и чётко регламентированный с эксплуатационной точки зрения путь первоначальной загрузки (bootstrapping) Harbor в роли Supervisor Service в изолированных средах VCF 9.0 и vSphere 8.0 Update 3.
Что такое VMware Bootstrap Registry Appliance
VMware Bootstrap Registry Appliance — это защищённый (hardened) виртуальный модуль, распространяемый в формате OVA. В его составе поставляется совместимый со спецификацией OCI реестр Harbor, работающий нативно на Photon OS 5.0. Модуль предназначен для размещения OCI-образов, необходимых для включения Harbor Supervisor Service (а также Contour) на vSphere Supervisor.
При этом модуль не является универсальным корпоративным реестром и не предназначен для обслуживания рабочих нагрузок в продуктивной среде. Его роль — Registry 0 в последовательности развёртывания изолированной среды: это временный инструмент первоначальной загрузки, который передаёт ответственность сервису Harbor Supervisor Service (Registry 1), как только тот становится работоспособным и функционирует штатно.
Чтобы обеспечить соответствие архитектурным требованиям и сохранить право на поддержку, развёртывание VMware Bootstrap Registry Appliance регулируется следующими обязательными эксплуатационными ограничениями:
Исключительно задача bootstrap: VMware Bootstrap Registry Appliance допускается применять только для загрузки и хранения OCI-образов, необходимых для включения сервисов Contour и Harbor Supervisor на Supervisor.
Запрет вторичных ролей: модуль не должен использоваться в инфраструктуре ни для каких иных целей. В частности, прямо запрещено его применение в качестве постоянного реестра платформы или корпоративного реестра рабочих нагрузок.
Ограничение по версии развёртывания: использование VMware Bootstrap Registry Appliance допускается только в развёртываниях версий ниже VCF 9.1. Начиная с VCF 9.1 официально поддерживаемым решением для управления жизненным циклом изолированных сред становится Fleet Depot Service (FDS).
Для vSphere 8.0: Broadcom Support Portal > My Downloads > VMware vSphere > VMware vSphere Standard > 8.0 > Drivers and Tools > VMware Bootstrap Appliance > BOOTSTRAP_APPLIANCE-2.15.2+vmware.1-25635995.ova
Для VCF 9.0: Broadcom Support Portal > My Downloads > VMware Cloud Foundation > VMware Cloud Foundation 9 – 9.0.2 > VMware vCenter > Drivers and Tools > VMware Bootstrap Appliance > BOOTSTRAP_APPLIANCE-2.15.2+vmware.1-25635995.ova
Обзор процесса развёртывания
Развёртывание VCF в изолированной среде выполняется по двухфазной схеме. Сначала, на первой фазе, создаётся bootstrap-реестр на базе VMware Bootstrap Registry Appliance. На второй фазе разворачивается Harbor в качестве Supervisor Service, который затем становится продуктивным реестром для всех рабочих нагрузок.
Сегодня VMware Bootstrap Registry Appliance является подходящим решением для сред VCF 9.0 и vSphere 8.0 U3. Заказчики, которые перейдут на VCF 9.1, смогут воспользоваться преимуществами Fleet Depot Service (FDS). Этот встроенный реестр нативно обслуживает жизненный цикл первоначальной загрузки как часть платформы. В средах VCF 9.1 VMware Bootstrap Registry Appliance больше не требуется, поскольку эту роль берёт на себя FDS.
Заключение
Таким образом, VMware Bootstrap Registry Appliance закрывает пробел в сценарии развёртывания изолированных сред VCF. Он представляет собой специализированный и поддерживаемый инструмент первоначальной загрузки сервиса Harbor Supervisor Service. Решение на базе Bitnami Harbor заменяется альтернативой, готовой к промышленной эксплуатации. Этот путь рекомендуется как при развёртывании с нуля на VCF 9.0, так и при миграции уже существующей изолированной среды.
В стремительно меняющемся ИТ-ландшафте корпоративные ИТ-подразделения сталкиваются с фундаментальной операционной дилеммой. С одной стороны, администраторам VMware vSphere и инфраструктуры необходимы жёсткий контроль, соответствие требованиям, безопасность и мультиарендное управление ресурсами. С другой стороны, разработчикам и DevOps-инженерам нужны гибкость, быстрое самостоятельное выделение ресурсов и нативная инфраструктура, управляемая через API, чтобы ускорить выпуск приложений.
Когда эти два приоритета сталкиваются, операционные проблемы неизбежны. Инфраструктурные команды тонут в бесконечных очередях заявок на развёртывание кластеров и изменение сетевых настроек, а команды разработки, раздражённые задержками, уходят в теневые ИТ или разворачивают изолированные внешние управляющие кластеры. Такая фрагментация не только замедляет инновации, но и порождает серьёзные уязвимости в безопасности, дополнительные операционные издержки и неэффективные расходы.
В недавнем вебинаре Activating VKS Supervisor to Support Kubernetes было показано, как активация управляющего уровня, называемого vSphere Supervisor, в VMware Cloud Foundation (VCF) 9.1 напрямую решает эту дилемму современных приложений.
VMware vSphere Kubernetes Service (VKS) — это среда исполнения Kubernetes, встроенная непосредственно в VCF. Благодаря сертифицированному CNCF дистрибутиву Kubernetes служба VKS позволяет платформенным инженерам разворачивать кластеры Kubernetes, управлять ими и масштабировать их, задействуя при этом весь набор облачных сервисов VCF, а также любые совместимые сторонние сервисы.
Преодоление разрыва: что такое vSphere Supervisor
Корпоративные платформенные команды постоянно испытывают операционное напряжение: разработчикам нужны быстрые API Kubernetes в режиме самообслуживания, тогда как инфраструктурные команды обязаны обеспечивать централизованное управление, безопасность и соблюдение политик по ресурсам.
vSphere Supervisor снимает эти трения, предоставляя настоящее самообслуживание для разработчиков, подкреплённое административным контролем корпоративного уровня, — и всё это работает прямо на существующей инфраструктуре vSphere. Вместо того чтобы строить и обслуживать сложные изолированные управляющие кластеры поверх vSphere, Supervisor встраивает нативный управляющий уровень Kubernetes непосредственно в VMware ESXi и vSphere, превращая гипервизоры в нативные эндпоинты Kubernetes.
Такая архитектура создаёт общую мультиарендную платформу, на которой гармонично работают и инфраструктурные администраторы, и разработчики:
Для администраторов vSphere: контроль и соответствие требованиям сохраняются за счёт пространств имён vSphere Namespaces. Администраторы задают границы ресурсов (квоты на CPU, память и хранилище), назначают ролевую модель доступа (RBAC) и сохраняют полную операционную видимость через vSphere Client и VMware Cloud Foundation Operations.
Для DevOps-инженеров: платформа предоставляет стандартную конечную точку API Kubernetes. Инженеры могут применять декларативные YAML-манифесты через kubectl и Helm, чтобы разворачивать кластеры рабочих нагрузок (кластеры VKS), виртуальные машины (через VM Service) и контейнеризованные нагрузки прямо внутри выделенных им пространств имён vSphere.
В VCF 9.1 развязанное управление жизненным циклом позволяет платформенным командам обновлять и патчить версии Kubernetes независимо от обновлений самой платформы. В сочетании с серьёзной оптимизацией движка VKS платформа обеспечивает развёртывание кластеров до 70% быстрее, обновления до 75% быстрее и масштабирование до 500 кластеров на один экземпляр управляющего уровня.
Архитектура vSphere Supervisor и высокая доступность
Архитектура vSphere Supervisor спроектирована так, чтобы обеспечивать отказоустойчивость корпоративного уровня за счёт встраивания нативного высокодоступного управляющего уровня Kubernetes непосредственно в слой гипервизора vSphere. Управляющий уровень vSphere Supervisor состоит из трёх активных виртуальных машин управляющего уровня Kubernetes, развёрнутых на хостах ESX или в мультизональных кластерах vSphere, что обеспечивает непрерывный кворум и отсутствие единых точек отказа. Эти виртуальные машины напрямую взаимодействуют с vCenter и ESX, управляя жизненным циклом рабочих нагрузок, распределением ресурсов и согласованием состояния во всей среде.
На низком уровне примитивы хранения и вычислений тесно связаны между собой, что помогает обеспечить высокую доступность. Алгоритм размещения управляющего уровня динамически распределяет виртуальные машины по доменам отказа, а временные данные обслуживаются через эфемерные диски (Ephemeral Disks), которые автоматически очищаются при завершении работы пода. Кроме того, диски с образами контейнеров кэшируются непосредственно на отдельных хостах ESX, что позволяет обойти задержки загрузки из реестра и обеспечить практически мгновенное создание подов и их восстановление при отказе хоста.
Топологии хранения и управление политиками
Приложениям с сохранением состояния, построенным по облачно-нативным принципам, требуется надёжная работа с постоянным хранилищем. vSphere Supervisor связывает запросы Kubernetes на постоянные тома с примитивами хранения vSphere через Cloud Native Storage (CNS) и нативный драйвер vSphere Container Storage Interface (CSI).
Когда разработчик отправляет запрос PersistentVolumeClaim (PVC), драйвер CNS-CSI напрямую обращается к vCenter и транслирует этот запрос в диск First Class Disk (FCD) на нижележащем хранилище. Администраторы обеспечивают управляемость, назначая политики хранения (например, Gold, Silver) и лимиты ёмкости непосредственно пространствам имён vSphere.
vSphere Supervisor поддерживает три различные топологии хранения, рассчитанные на конкретные требования рабочих нагрузок:
Хотя чаще всего в качестве примера приводится гиперконвергентный vSAN, традиционные внешние массивы хранения (Fibre Channel, iSCSI и NFS) отображаются на те же самые топологии. Стандартные внешние хранилища SAN/NAS, подключённые к одному кластеру vSphere, работают как зональные хранилища (Zonal Datastores). В мультизональных развёртываниях заказчики, использующие репликацию на уровне сторонних массивов — например, метрокластеры хранения на базе FC/iSCSI, — могут добиться доступности межзональных хранилищ (Cross-Zone Datastore) без применения нативного растянутого кластера vSAN.
Помимо постоянного хранилища vSphere Supervisor управляет дисками управляющего уровня, эфемерными дисками (автоматически уничтожаются при удалении пода) и кэшированием образов контейнеров непосредственно на хостах ESX, что обеспечивает практически мгновенный запуск подов.
Сеть и балансировка нагрузки в vSphere Supervisor
Сетевая подсистема и балансировка нагрузки в vSphere Supervisor построены вокруг развязанной, хорошо масштабируемой модели виртуального частного облака (VPC), реализованной через системные проекты VMware NSX и централизованные транзитные шлюзы. Каждое пространство имён vSphere работает внутри собственного выделенного NSX VPC с приватными подсетями и шлюзами VPC, которые изолируют нагрузки арендаторов и устраняют конфликты IP-адресов, даже если разные команды используют пересекающиеся блоки CIDR.
Маршрутизация трафика между пространствами имён, управляющими сетями и внешними сервисами обеспечивается транзитными шлюзами Tier-0 и Tier-1, что помогает организовать безопасную и высокопроизводительную транзитную передачу по сетевой фабрике. Для балансировки нагрузки и входящего трафика vSphere Supervisor интегрируется с VMware Avi Load Balancer. Эта интеграция автоматизирует выделение и управление жизненным циклом виртуальных IP-адресов (VIP), балансировщиков для конечной точки API Kubernetes и контроллеров ingress уровней L4/L7, обеспечивая точное управление трафиком, полностью автоматическую настройку сети и глубокую изоляцию по безопасности без ручного вмешательства в сетевую конфигурацию.
Современная сеть: NSX VPC и транзитные шлюзы
Организация сети в мультиарендных контейнерных платформах традиционно вызывала значительные трудности, нередко приводя к исчерпанию IP-адресов, усложнению маршрутизации на межсетевых экранах и рискам безопасности.
vSphere Supervisor решает эту задачу, сочетая виртуальные частные облака NSX (VPC) с гибкими схемами транзитных шлюзов в системных проектах NSX. Хотя в демонстрации на вебинаре был показан вариант с централизованным транзитным шлюзом, vSphere Supervisor в полной мере поддерживает и распределённые транзитные шлюзы, что позволяет выбрать модель подключения, наиболее подходящую конкретной среде.
Ключевые возможности этой сетевой архитектуры:
Изолированные VPC для каждого пространства имён: каждое пространство имён vSphere изолировано внутри собственного NSX VPC с приватными подсетями и выделенными шлюзами VPC.
Отсутствие конфликтов IP и развязанная маршрутизация: развязанная маршрутизация между VPC позволяет разным командам разработки использовать пересекающиеся диапазоны IP без сетевых коллизий.
Линейная масштабируемость: централизованные транзитные шлюзы безопасно обрабатывают высокоскоростную маршрутизацию между пространствами имён и во внешние сети через шлюзы Tier-0/Tier-1.
Встроенная балансировка нагрузки: Avi Load Balancer автоматизирует маршрутизацию трафика через контроллер ingress и балансировку API Kubernetes.
Пошаговая активация и сценарий демонстрации
В демонстрационной части вебинара был показан полный сквозной жизненный цикл развёртывания — как со стороны администратора, так и со стороны разработчика.
Наблюдаемость на этапе Day-2: вся телеметрия, метрики производительности и логи поступают напрямую в централизованный VCF Operations для проактивного мониторинга и операций жизненного цикла.
Предварительные требования и запуск активации: перед запуском активации Supervisor необходимо убедиться, что выполнены базовые требования: действующий домен рабочих нагрузок VCF с включёнными vSphere HA и DRS, сетевая конфигурация на базе NSX или распределённого коммутатора vSphere с назначенными пулами IP-адресов, поддерживаемый балансировщик нагрузки, выделенная политика хранения vSphere и подписная библиотека контента (Subscribed Content Library). После этого активацию можно инициировать при создании домена рабочих нагрузок в VCF Operations либо уже после развёртывания непосредственно в vCenter в разделе Supervisor Management -> Get Started, где мастер перед развёртыванием проверяет вычислительные зоны, политики хранения, библиотеки контента и настройки балансировки нагрузки.
Настройка пространства имён и RBAC: администратор виртуальной инфраструктуры создаёт пространство имён vSphere, назначает политики хранения и квоты ресурсов, а также выдаёт права доступа разработчикам.
Декларативное развёртывание: DevOps-инженер аутентифицируется на управляющем уровне vSphere Supervisor через kubectl и применяет YAML-манифест с запросом на новый кластер VKS. vSphere Supervisor автоматически разворачивает узлы управляющего уровня и рабочие узлы.
Двойная перспектива наблюдения: администратор виртуальной инфраструктуры отслеживает состояние инфраструктуры и объекты виртуальных машин в vSphere и VCF Operations, тогда как разработчик управляет подами, сервисами и развёртываниями через kubectl.
Развёртывание гибридного приложения: команды разворачивают многоуровневые приложения, объединяющие виртуальные машины (через API службы VM Service) и контейнеризованные нагрузки на базе Helm-чартов.
Заключение и что дальше
Активация vSphere Supervisor превращает традиционную корпоративную виртуализацию в мощную мультиарендную облачную платформу. Предоставляя разработчикам нативное самообслуживание Kubernetes и одновременно оставляя ИТ-администраторам полный контроль над ресурсами и политиками, VKS ускоряет выпуск современных приложений без роста операционных рисков.
Учебные курсы: войдите в Learning@Broadcom через портал поддержки Broadcom, раздел «Education Portal», чтобы получить доступ к следующим курсам по VKS:
Если по проектам VKS нужна помощь, обратитесь к своему аккаунт-менеджеру Broadcom, чтобы узнать, чем могут помочь профессиональные сервисы VCF и партнёры, такие как TeraSky.
Механизм Memory Tiering в VMware Cloud Foundation 9 использует два типа устройств памяти, чтобы нарастить её объём при существенно меньшей стоимости. Технология незаметно для виртуальных машин отслеживает активность обращений к памяти и удерживает часто используемые данные в быстрой и дорогой DRAM, вытесняя редко запрашиваемые страницы на второй, более медленный и дешёвый уровень на NVMe-накопителе.
Память нередко оказывается самой дорогой составляющей в стоимости сервера, а современные приложения потребляют её всё больше: растут объёмы данных, усложняются вычисления, добавляются требования к работе в реальном времени. При этом в продуктивных средах администраторы обычно избегают переподписки памяти из-за непредсказуемой деградации при срабатывании механизмов её возврата — ballooning, сжатия или свопинга. Эти техники не обладают интеллектом Memory Tiering и не умеют грамотно распоряжаться активной памятью, поэтому виртуальным машинам выделяют полный требуемый объём. Решение рабочее, но неэффективное: одновременно используется далеко не вся выделенная память, и дорогой ресурс простаивает.
В VCF 9.0 Memory Tiering предоставляет виртуальным машинам единое логическое пространство памяти, а под капотом управляет двумя её типами в зависимости от активности обращений:
Tier 0 — высокоскоростная DRAM: дорогая и очень быстрая системная память, где остаётся активная, «горячая» память.
Tier 1 — устройства NVMe: производительные SSD, более медленные и заметно более дешёвые, куда переносится неактивная, «холодная» память.
После включения тиринга информация о нём доступна в интерфейсе VMware vCenter: вкладка Configure > Hardware > Overview > Memory. Там отображается суммарный объём памяти и его распределение по уровням — например, 1 022,93 ГБ всего, из которых 511,46 ГБ приходится на Tier 0 и столько же на Tier 1. Настройка описана в документации vSphere, а бизнес-обоснование технологии разобрано в блоге VMware Cloud Foundation.
Архитектура
В систему добавлен модуль классификации и размещения страниц памяти. Он периодически обходит всю гостевую память, динамически вычисляя активность гостя, пропускную способность каждого уровня, квоты уровней для виртуальных машин и пороги активности страниц. Планировщик памяти опирается на эти показатели вместе с историей активности каждой гостевой страницы и размещает страницы на подходящем уровне.
Работа идёт в фоне. Механизм наблюдает за обращениями к памяти и определяет, какие страницы горячие, а какие холодные в заданном временном окне: например, горячими считаются те, к которым чаще всего обращались в течение последней минуты, — они остаются в DRAM, остальные уходят на NVMe. Классификация постоянно пересматривается: когда нагрузки проходят через смену фаз и активными становятся другие участки памяти, тиринг перераспределяет страницы, поддерживая эффективную загрузку DRAM.
Методика тестирования
Для оценки была смоделирована продуктивная среда на VCF 9.0 с включённым тирингом, на которой запускались популярные корпоративные бенчмарки, нагружающие процессор, память, хранилище и сеть.
Бенчмарк
Нагрузка
Результат
Login Enterprise
Приложения VDI
Двукратный рост плотности ВМ, потери 0–8%
VMmark
Корпоративные приложения
Двукратный рост плотности ВМ, потери 5%
DVD Store
Oracle Database
Двукратный рост плотности ВМ, потери менее 5%
HammerDB
SQL Server, MySQL
Двукратный рост плотности ВМ, потери 5–10%
Все цифры относятся к двукратной плотности виртуальных машин; при меньшей плотности влияние на производительность будет ниже или вовсе незаметным. Соотношение DRAM к NVMe по умолчанию в VCF 9.0 составляет 1:1 — при 1 ТБ DRAM можно получить ещё около 1 ТБ памяти на NVMe. Во всех тестах применялось именно оно.
Результаты представлены через три группы метрик: прирост плотности виртуальных машин, разница в производительности относительно системы только на DRAM и загрузка процессора — как в части дополнительно утилизируемых ресурсов, так и в части накладных расходов тиринга. Чтобы точнее отразить последние, большие страницы (large pages) на хосте везде оставались отключёнными — это настройка по умолчанию для ESX с тирингом.
Метрика активной памяти в разных инструментах называется по-разному: в esxtop это TCHD (touched memory), причём общехостового счётчика нет и значения всех машин приходится суммировать; в vCenter — счётчик Active в разделе Monitor > Performance > Overview > Memory; в VCF Operations — Metrics > Memory > Guest Active.
VDI: тестирование с Login Enterprise
Login Enterprise от Login VSI — отраслевой стандарт для оценки ёмкости и производительности VDI: виртуальные пользователи имитируют реальных сотрудников и замеряют время отклика на каждое взаимодействие. Инфраструктурой рабочих столов служила Omnissa Horizon. Из двух преднастроенных профилей выбран knowledge worker как самый тяжёлый и распространённый: он включает девять приложений, среди которых Word, PowerPoint, Excel, Outlook, браузер Edge и потоковое видео. Главная метрика — оценка пользовательского опыта EUX, складывающаяся из таймеров типичных действий: отзывчивости приложений, обработки клавиатурного ввода, ресурсоёмких вычислений и задержек дисковых операций.
Тесты шли в двух вариантах провижининга: с отключённым межмашинным Pshare (ModeB) и с включённым (ModeA). В ModeA мгновенные клоны при создании клонируются от родительской ВМ и разделяют её память; в ModeB — от выключенной ВМ-реплики, без разделения. Режимы различаются не только поведением разделения страниц, но и работой алгоритма тиринга, поэтому в исследование вошли оба. Одиночный узел — Dell PowerEdge R760 с двумя Intel Xeon 8480 (56 ядер на сокет) и 1 или 2 ТБ DRAM, устройство тиринга Dell Ent NVMe P5620 MU на 1,6 ТБ, рабочие столы Windows 11 на 2 vCPU.
В режиме ModeB машинам выделялось 8 ГБ RAM: при 1 ТБ DRAM это давало около 120 VDI-сессий, а добавление 1 ТБ на NVMe позволило довести их число до 240. Потери составили менее 6% относительно варианта только на DRAM (1 ТБ). Оценка EUX снизилась с 8,6 до 8,3 при сравнении дорогой системы с 2 ТБ DRAM и заметно более дешёвой с 1 ТБ DRAM плюс 1 ТБ тиринга — падение всего около 3,5%. Загрузка процессора выросла с 63,5% до 74%: перемещение данных между уровнями имеет свою цену.
Время отклика приложений изменилось незначительно: Outlook открывался за 1,10 секунды против 0,94 на чистой DRAM, запуск Excel и PowerPoint замедлился примерно на 0,002 секунды. Активная память хоста держалась в диапазоне 420–450 ГБ — около 50% от ёмкости DRAM. Динамика EUX по мере роста числа сессий тесно коррелирует с показателями NVMe: когда задержка поднималась выше 200 микросекунд, метрики CPU score и Generic application score проседали, а при стабилизации около 200 микросекунд снова росли вместе с общей оценкой.
В режиме ModeA машинам выделялось 6 ГБ: выигрыш от разделения страниц оставляет алгоритму больше пространства для масштабирования. Число сессий выросло с 160 до 320. Оценка EUX снизилась с 8,7 до 7,9, но причина не в тиринге: в первом случае процессор работал с турбо-ускорением в 1,5 раза, а при 320 машинах из-за высокой загрузки его частота была близка к номинальной. С включёнными большими страницами EUX составила 8,3 при загрузке CPU 84,5%, с отключёнными — 7,9 при загрузке 90%. Сравнение 8,3 и 7,8 даёт потерю 6%, а если брать только малые страницы, падение с 7,9 до 7,8 — порядка 1%. Столь низкие потери согласуются с задержкой NVMe всего в 100 микросекунд при пропускной способности чтения заметно ниже 100 МБ/с.
Многоузловые тесты шли на трёхузловом кластере vSAN архитектуры ESA с RAID 5 на серверах Dell PowerEdge R660 с двумя Intel Xeon 6430 (32 ядра на сокет) и 512 ГБ DRAM: четыре NVMe в каждом хосте отданы под vSAN, пятое — под тиринг. В режиме ModeB тиринг позволил удвоить плотность машин за счёт добавления 512 ГБ NVMe, при этом оценка EUX относительно 1 ТБ DRAM снизилась лишь на 8%. Пропускная способность чтения NVMe составляла около 200 МБ/с, задержки стартовали со 100 микросекунд, поднимались до 400 по мере добавления сессий и опускались до 200 в установившемся режиме.
Во втором наборе тестов число рабочих столов увеличили до 200 на хост, то есть до 600 на кластер, с мгновенными клонами по 5 ГБ и провижинингом ModeA. Оценки EUX для DRAM (1 ТБ) и Memory Tiering (1 ТБ) составили 6,9 и 7,0 при загрузке процессора выше 90% в обоих случаях — то есть удвоение плотности прошло вовсе без потерь производительности. Задержки устройства тиринга достигали 150 микросекунд, пропускная способность держалась около 200 МБ/с, активная память доходила до 320 ГБ — 62,5% от доступной DRAM.
Корпоративные приложения: VMmark
VMmark оценивает производительность и масштабируемость виртуализованных ЦОД. Бенчмарк объединяет типовые приложения (standby, DVD Store и Weathervane) в блоки-«тайлы»; один тайл состоит из 19 Linux-машин с нагрузками от 1 до 8 vCPU и от 4 до 250 ГБ памяти. Использовалась конфигурация с большим объёмом памяти: размер ВМ с базой увеличен с 32 до 250 ГБ, размер базы — со 100 до 300 ГБ, время раздумий — с 1 до 1,5 секунды, чтобы сделать тест в большей степени memory-intensive, чем compute-intensive. Тестовая система — два Intel Xeon 8592 по 64 ядра с 1 или 2 ТБ DRAM, устройство тиринга Samsung PM9A3 на 3,84 ТБ, на тайл приходилось 376 ГБ памяти и 31 vCPU.
Итоговая оценка агрегирует метрики пропускной способности приложений с нормализацией по весу каждого, а тайлы добавлялись до появления сбоев качества обслуживания. Конфигурация только на DRAM (1 ТБ) выдержала 57 виртуальных машин в трёх тайлах, конфигурация с тирингом (2 ТБ) — 114 машин в шести тайлах.
Сравнение трёх конфигураций показывает накладные расходы технологии по производительности и по процессору. В базовом варианте загрузка CPU была ограничена нехваткой памяти, тогда как при большем её объёме сервер утилизировался значительно плотнее. Производительность тиринговой конфигурации оказалась менее чем на 5% ниже варианта с 2 ТБ DRAM — притом что хост располагал лишь 1 ТБ реальной DRAM. Пропускная способность чтения NVMe была чуть выше рекомендованной, но задержка оставалась около 100 микросекунд, и производительность не пострадала.
Базы данных: SQL Server, Oracle и MySQL
Нагрузки баз данных требовательны к процессору, дискам и памяти одновременно, что делает их хорошим полигоном для проверки тиринга. Тестировались СУБД, типичные для развёртываний VCF: Microsoft SQL Server 2022, Oracle Database 21c и MySQL 8.0.
SQL Server измерялся с помощью HammerDB 5.0 (профиль TPC-C, 1000 складов, 125 виртуальных пользователей) на Dell PowerEdge R760 с 512 ГБ или 1 ТБ DRAM и виртуальными машинами на 8 vCPU и 80 ГБ. На хосте с 512 ГБ DRAM удавалось запустить не более 6 машин — при попытке добавить больше транзакции завершались по таймауту. Расширение памяти до 1 ТБ с помощью тиринга позволило удвоить их число. Прирост производительности при переходе от 512 ГБ к 1 ТБ DRAM составил 1,6 раза (нелинейность объясняется факторами, не связанными с тирингом), а падение при сравнении DRAM (1 ТБ) и тиринга (1 ТБ) не превысило 10%.
Активная память в установившемся режиме составляла около 256 ГБ, а процессорная нагрузка снизилась, поскольку машины ожидали обслуживания промахов DRAM накопителем. Задержка чтения NVMe на фазе разогрева держалась в районе 300–400 микросекунд и стабилизировалась примерно на 200 в измерительной фазе. Показательна корреляция: пока активная память на разогреве превышала 50% от DRAM, число транзакций в минуту проседало; когда она устоялась на уровне около 50%, показатель TPM вырос и стабилизировался.
Oracle Database 21c тестировалась на Oracle Enterprise Linux 8.8 с нагрузкой DVD Store 3.5: 600 пользователей на машину, время раздумий 5 секунд, база около 200 ГБ. Система — односокетный AMD EPYC 9755 на 128 ядер с 768 ГБ DRAM, виртуальные машины на 16 vCPU и 192 ГБ. Проверялись три сценария: 768 ГБ DRAM, 1,5 ТБ DRAM и тиринговый вариант из 768 ГБ DRAM плюс 768 ГБ NVMe. Число машин подбиралось так, чтобы полностью законтрактовать память: 4 машины на 768 ГБ и 8 машин на 1,5 ТБ. Результат — рост с 4 до 8 машин при потере менее 5% относительно 1,5 ТБ чистой DRAM.
Особенно показательна динамика процессора: в базовом сценарии его загрузка была ограничена 43%, а с тирингом достигла 85%. Это наглядно демонстрирует способность технологии раскрывать ёмкость хоста там, где система упирается в память, а процессорные циклы простаивают. Активная память по счётчику touched memory в esxtop в среднем составляла около 400 ГБ — чуть больше 50% от DRAM, а средняя задержка чтения NVMe — 86 микросекунд при пропускной способности около 35 МБ/с.
MySQL 8.0 на RHEL 9.4 тестировался тем же HammerDB на машинах с 14 vCPU и 60 ГБ; плотность также удалось удвоить при потере менее 5%. Параметром keyingandthinktime здесь регулировались нагрузка на процессор и объём активной памяти. При времени раздумий 10 миллисекунд загрузка CPU в базовом сценарии на 512 ГБ была высокой — 70%, активная память достигала 286 ГБ (около 55% ёмкости DRAM); при удвоении числа машин в работу вовлекались 224 vCPU и процессор доходил почти до насыщения, что объясняет нелинейное масштабирование. Когда время раздумий подняли до 45 миллисекунд, активная память выросла до 410 ГБ (около 80% DRAM), а загрузка CPU снизилась до 45% — благодаря запасу по процессору удвоение плотности дало двукратный рост пропускной способности. Примечательно, что даже при активной памяти на уровне 80% потери оказались минимальными: вероятно, большое время раздумий поглощало задержки NVMe.
Влияние на vMotion
Производительность виртуальных машин при миграции vMotion в среде с тирингом не страдает, но сама миграция может занимать больше времени: фаза предварительного копирования читает данные с медленных уровней. Внутренний механизм vMotion разобран в отдельном документе.
Тестировался Dell PowerEdge R750 с двумя Intel Xeon 8380 и адаптерами Mellanox 100GbE. Четыре машины на 12 vCPU и 48 ГБ работали под RHEL 8.1 с Oracle 21c и SGA 43 ГБ, нагрузка создавалась HammerDB; чтобы активировать тиринг, память хоста искусственно уменьшили до 164 ГБ. В сценарии эвакуации хоста с одновременной миграцией всех четырёх машин пропускная способность Oracle оставалась практически неизменной: наблюдался единственный провал в фазе переключения, но простой не превышал секунды.
Сценарий
Среднее время миграции
Простой ВМ
Штраф для гостя
4 ВМ, базовый вариант (только DRAM)
23,5 секунды
менее 1 секунды
менее 5%
4 ВМ, Memory Tiering
82 секунды
менее 1 секунды
менее 5%
Тиринг увеличивает длительность vMotion, но на производительности машин это не сказывается: замедление приходится на фазу предварительного копирования, когда холодные страницы читаются с более медленного NVMe.
Эксплуатация и мониторинг
Чтобы Memory Tiering обеспечивал хорошую производительность, важны три вещи: следить за активной памятью, следить за задержкой чтения NVMe и правильно выбрать сам накопитель.
Активную память рекомендуется удерживать не выше 50% от ёмкости DRAM хоста; для некоторых нагрузок она может быть выше без каких-либо проблем. В диапазоне от 50% до 75% необходимы тестирование и наблюдение за конкретной нагрузкой. Выше 75% в большинстве случаев следует ожидать существенных потерь.
Пока задержка чтения накопителя остаётся ниже 200 микросекунд, производительность тиринга ожидаемо хорошая. В диапазоне 200–400 микросекунд возможны проблемы, а выше 400 влияние на нагрузки становится заметным.
При выборе накопителя стоит ориентироваться на высокий класс износостойкости D и высокий класс производительности — более 100 000 операций записи в секунду при DWPD = 3 — а также на больший объём.
Нужные метрики доступны в vCenter на странице Advanced Performance через Chart Options. Пропускная способность записи показывает перенос холодных страниц на NVMe, чтения — извлечение страницы, которая снова стала активной, но отсутствует в DRAM; если чтение превышает 200 МБ/с, стоит присмотреться к задержкам. На качественном накопителе они остаются заметно ниже 200 микросекунд даже при 400 МБ/с, тогда как некоторые другие модели на схожем трафике показывают около 300. Чтобы понять, почему конкретная машина работает медленно, стоит посмотреть пропускную способность чтения в её разрезе: всплывающее окно графика позволяет вывести несколько машин сразу. Активная память хоста доступна там же, а также в VCF Operations.
Дополнительно рекомендуется обеспечить достаточный запас по процессору под накладные расходы тиринга; следить, чтобы загрузка CPU на нетиринговых хостах кластера не превышала 75%, иначе эффективность технологии может снизиться; и не использовать с Memory Tiering «монструозные» виртуальные машины — крупнее 32 vCPU и 512 ГБ DRAM.
Выводы
Memory Tiering — важное усовершенствование VCF 9, позволяющее за счёт добавления NVMe SSD получить значительно больший объём памяти при существенно меньшей стоимости по сравнению с использованием только DRAM. Технология решает проблему растущей стоимости памяти в ЦОД, оптимизируя совокупную стоимость владения серверами и нагрузками, ограниченными объёмом памяти.
Измерения на нескольких бенчмарках дали стабильно хорошие результаты: двукратный рост плотности виртуальных машин и экономия TCO до 40%. Тиринг также высвобождает процессорные ресурсы хоста, которые при дефиците памяти иначе остались бы неиспользованными, а простой машин при vMotion неизменно остаётся ниже одной секунды. Оптимальную производительность обеспечивает мониторинг двух показателей: активную память в идеале следует удерживать ниже 50% от объёма DRAM, а задержку устройства нижнего уровня — ниже 200 микросекунд.


 RSS
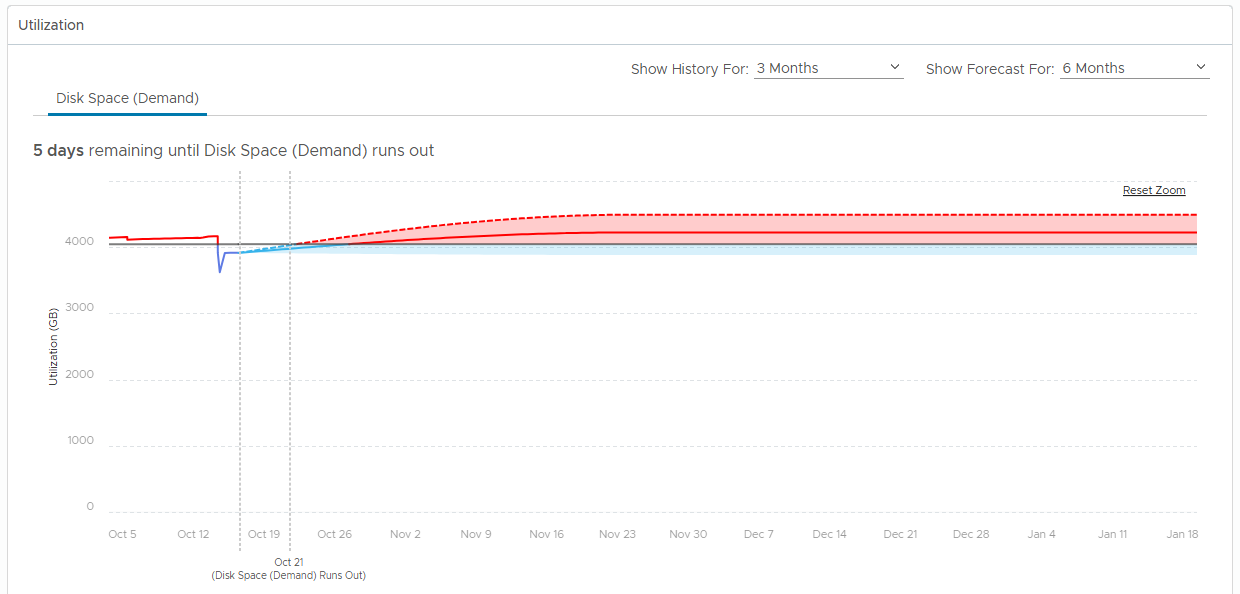
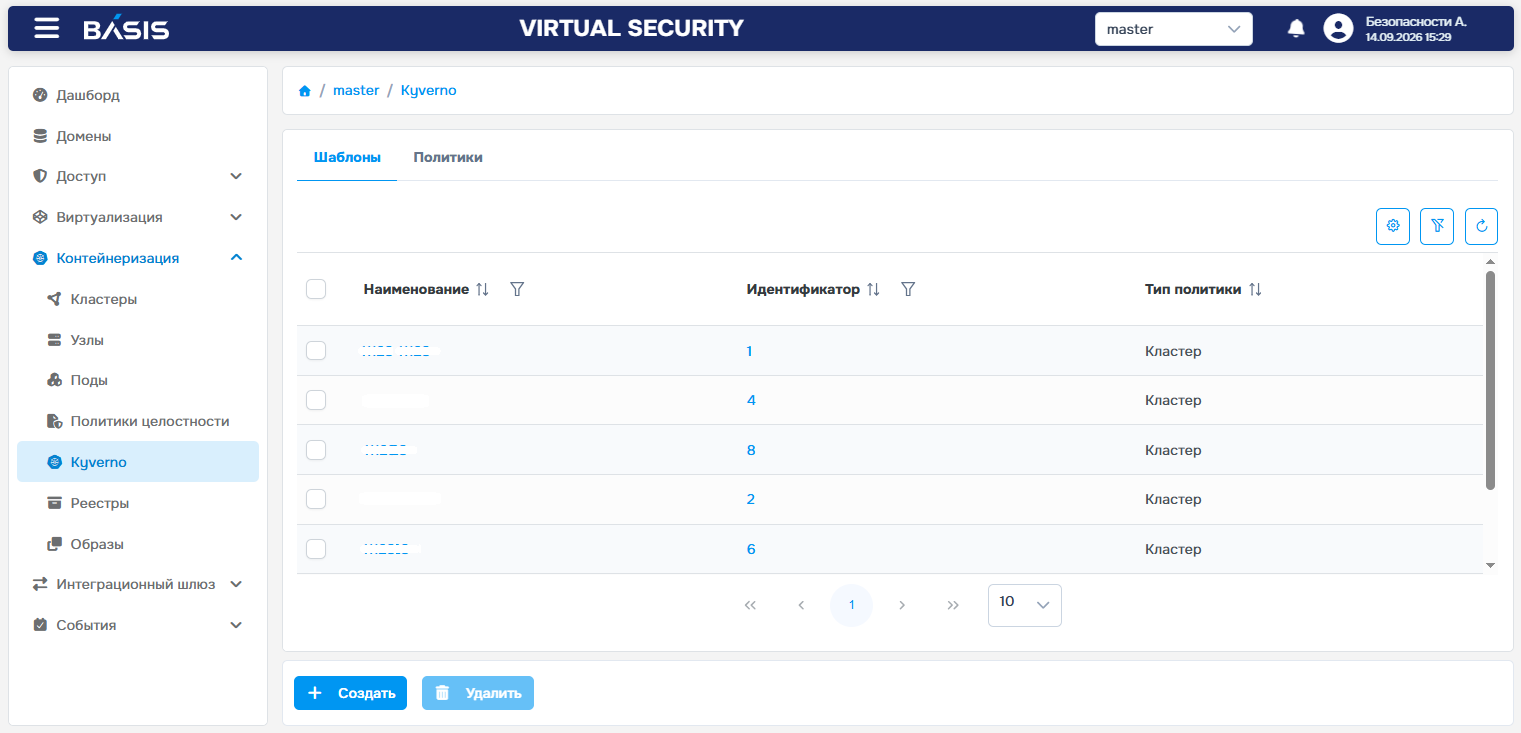 В Basis Virtual Security 4.1 появились контроль кластеров Kubernetes, политики Kyverno, сканирование реестров и проверка подписей контейнерных образов.
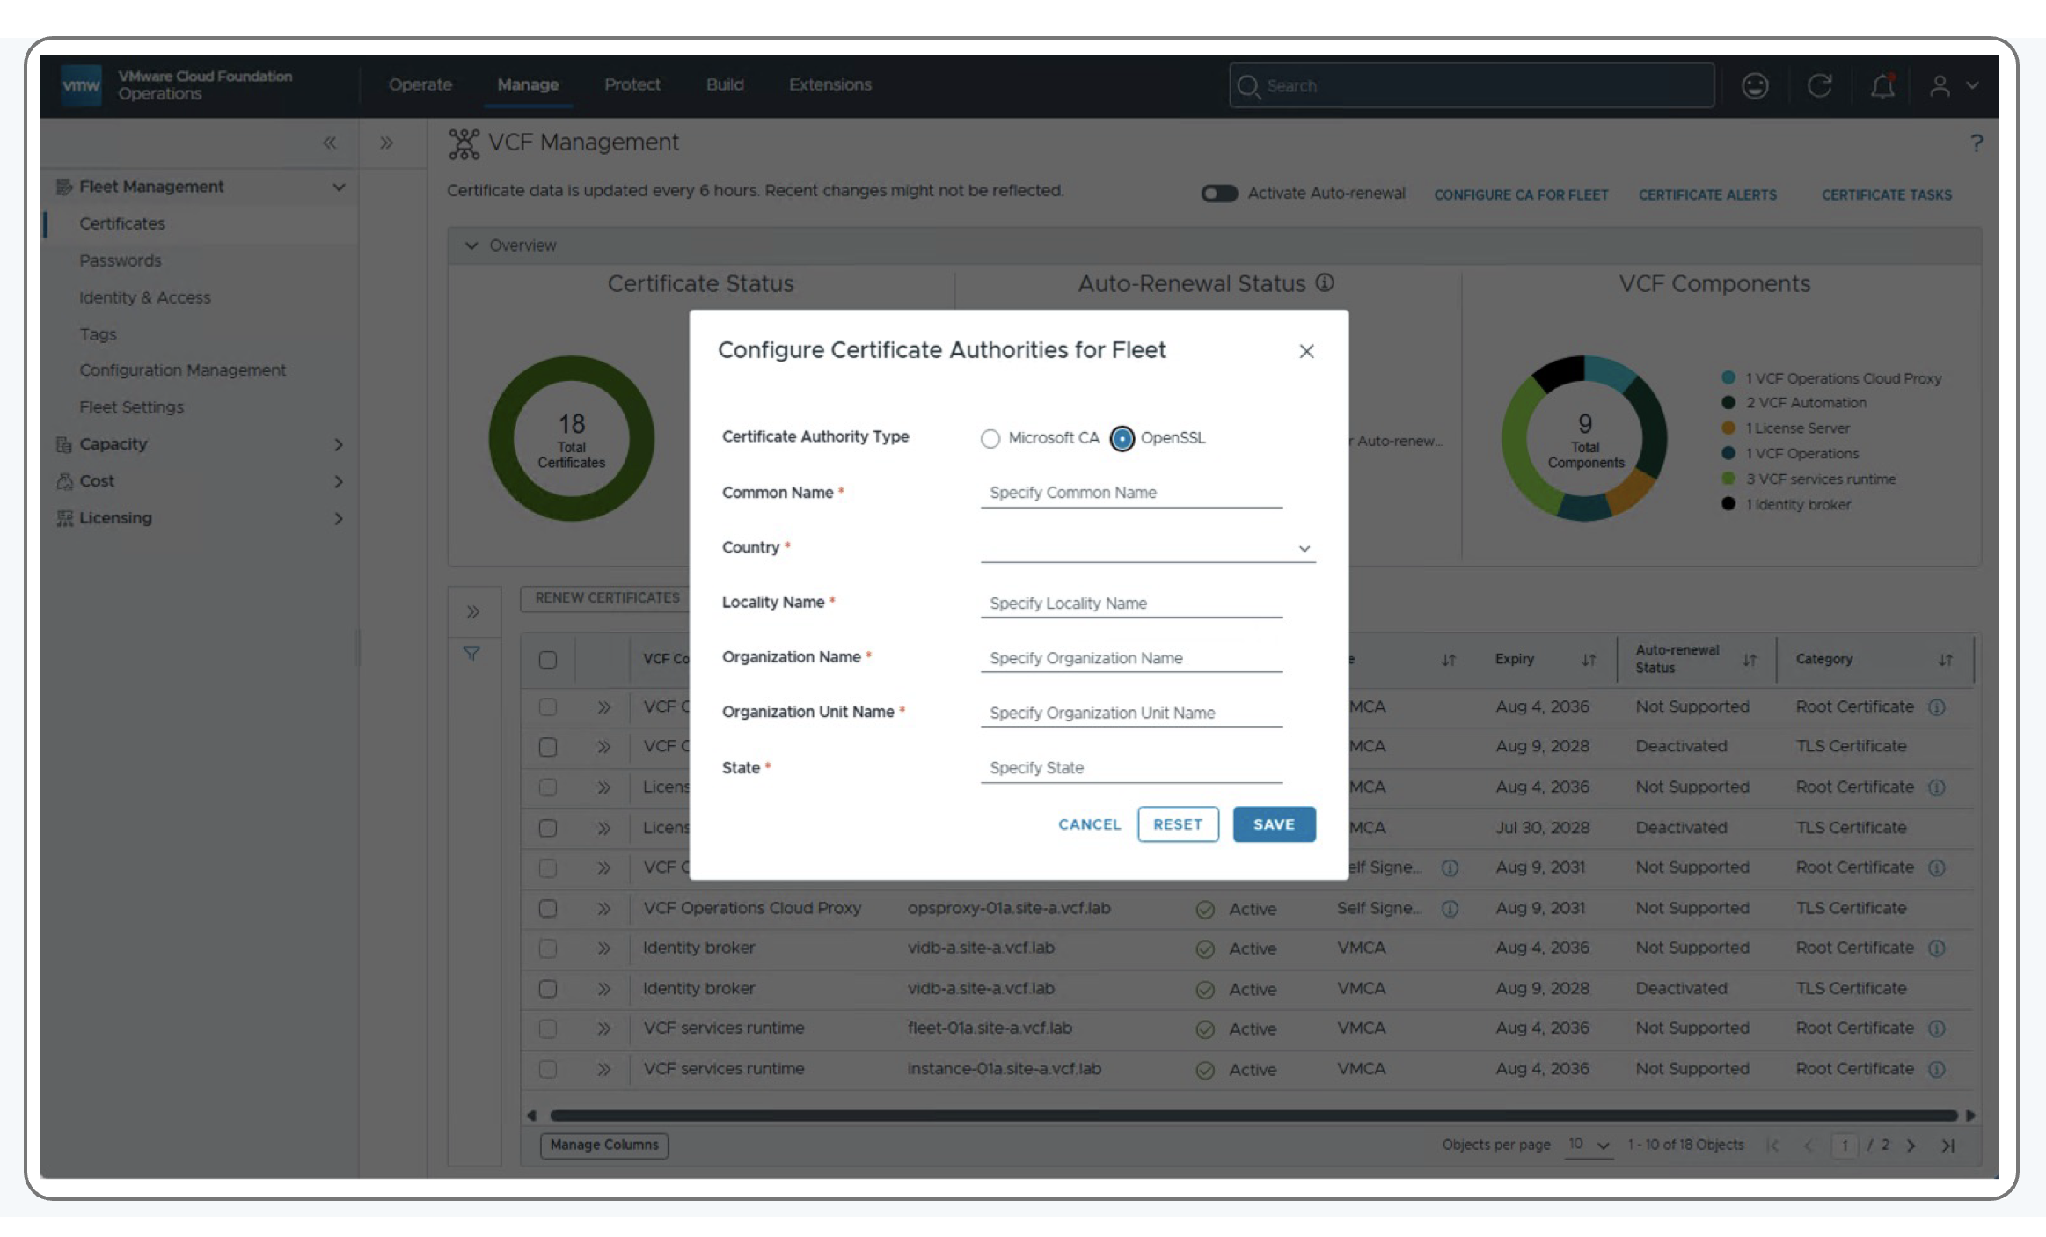 VCF Operations 9.1.1 управляет сертификатами смешанного парка VCF и vSphere: CA, массовые операции, контроль срока действия и API.